
机器学习与深度学习 / 系统课时
CPU 与 GPU 数据迁移
CPU 与 GPU 数据迁移
本课解决张量在 CPU 与 GPU 之间如何安全迁移的问题。你将完成设备选择、张量复制、结果回传,并能判断设备不一致、直接转 NumPy 等常见错误的根因。
学习目标
- 判断张量当前所在的计算设备
- 使用
to()在 CPU 与 GPU 之间迁移张量 - 理解设备一致性、复制开销和结果回传规则
为什么设备必须一致
CPU 内存与 GPU 显存是两套独立的存储空间。张量从 CPU 移到 GPU 时,通常会发生一次数据复制;计算结束后若要交给 NumPy、日志系统或普通 Python 代码处理,还需要把结果复制回 CPU。
同一次运算中的张量必须位于兼容设备上。例如,一个张量在 cpu,另一个在 cuda:0,PyTorch 无法直接执行加法或矩阵乘法,因为计算内核不能同时读取两套地址空间。
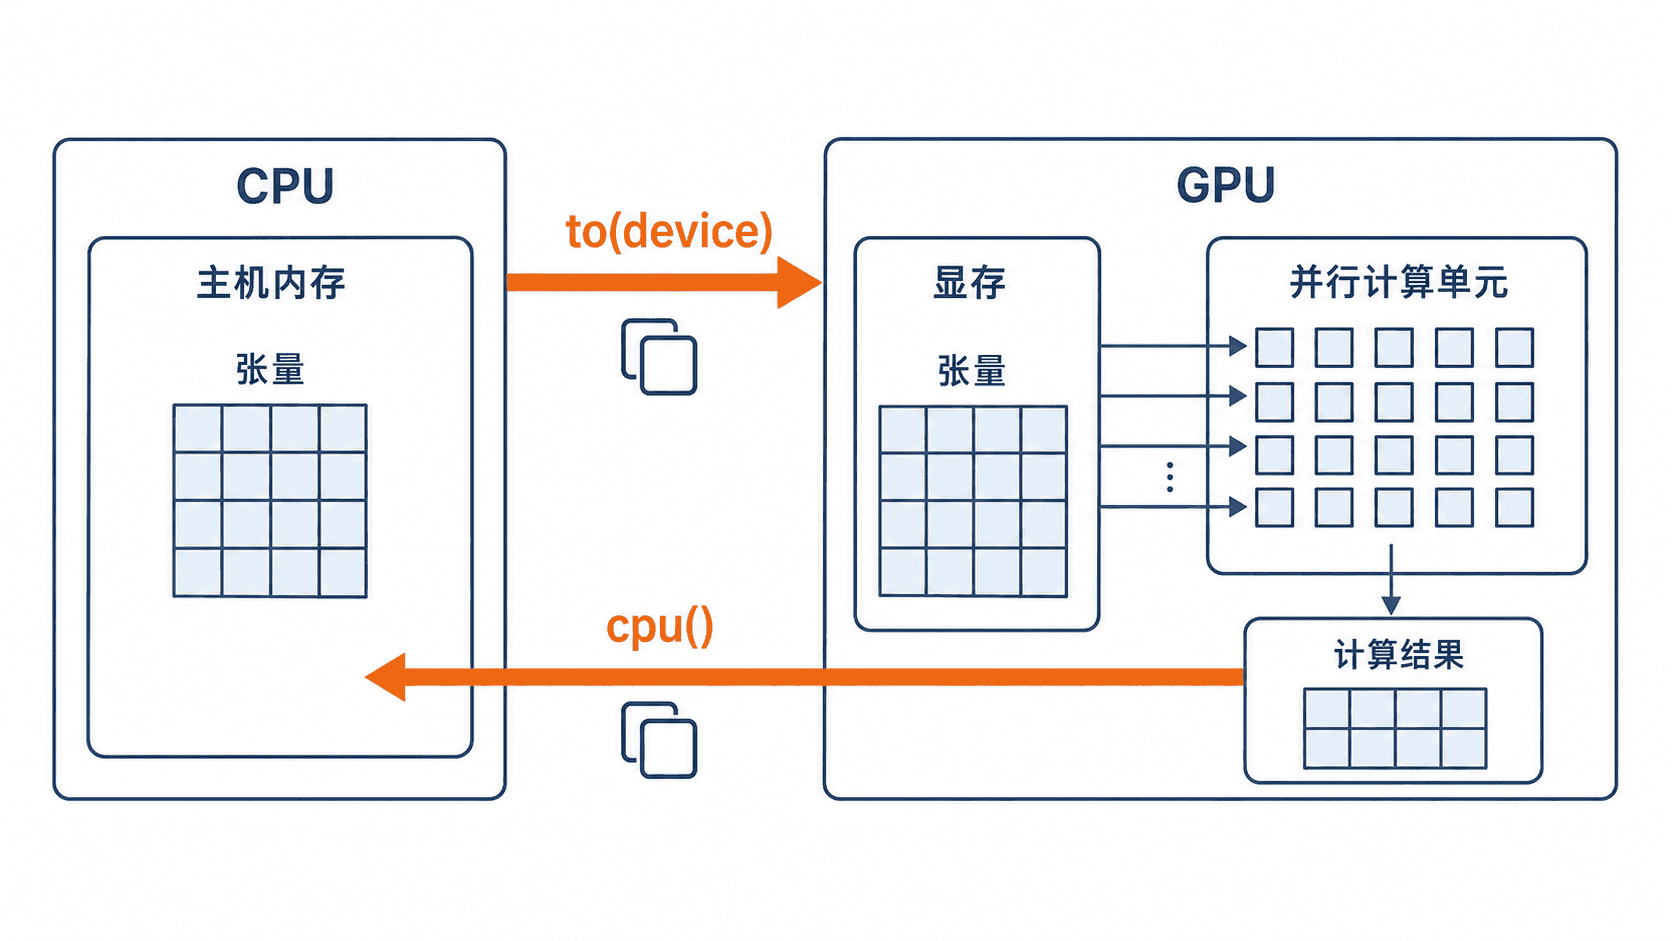
完整示例:选择设备并迁移张量
下面的程序优先选择第一块 CUDA GPU;没有可用 GPU 时自动回退到 CPU,因此在两类环境中都能运行。
import torch

def main() -> None:
    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")

    # 原始张量创建在 CPU,to() 在需要时复制到目标设备
    cpu_tensor = torch.tensor([[1.0, 2.0], [3.0, 4.0]])
    device_tensor = cpu_tensor.to(device)

    result_on_device = device_tensor * 2
    result_on_cpu = result_on_device.cpu()

    print(f"device={device}")
    print(f"source={cpu_tensor.device}, target={device_tensor.device}")
    print(result_on_cpu)

if __name__ == "__main__":
    main()
预期输出
device=<DEVICE>
source=cpu, target=<DEVICE>
tensor([[2., 4.],
        [6., 8.]])
<DEVICE> 在无 GPU 环境中为 cpu,在 CUDA 环境中通常为 cuda:0,实际值可能因设备配置不同而变化。原始 cpu_tensor 仍留在 CPU,to() 的返回值才是目标设备上的张量。
迁移时需要掌握的边界
tensor.to(device) 比直接调用 tensor.cuda() 更通用,因为同一份代码可以在 CPU 与 GPU 环境间切换。若张量已经位于目标设备,PyTorch 通常会直接复用原对象,而不是再次复制。
GPU 运算通常采用异步提交。调用 .cpu()、读取 .item() 或进行某些同步操作时,程序可能等待 GPU 完成任务。因此,频繁在循环中来回迁移小张量,往往会让复制和同步开销超过计算收益。
训练模型时,模型参数与输入也必须迁移到同一设备。常见写法是先执行 model.to(device),再对每个批次执行 inputs = inputs.to(device) 和 labels = labels.to(device)。
常见错误
GPU 张量不能直接调用 .numpy(),因为 NumPy 只能读取 CPU 内存。推理结果通常使用 tensor.detach().cpu().numpy():detach() 切断梯度跟踪,cpu() 完成设备回传,最后再转换为 NumPy 数组。
设置 non_blocking=True 不等于复制一定异步。它通常需要配合 DataLoader 的固定页内存 pin_memory=True 才可能减少主机到 GPU 的等待,是否有效还要通过实际性能测试确认。
本课总结
- CPU 内存与 GPU 显存彼此独立,跨设备迁移通常意味着数据复制
- 参与同一运算的张量和模型参数必须位于兼容设备
- 使用
to(device)统一设备逻辑,结果交给 NumPy 前先回传到 CPU
下一课预告
下一课将进入自动微分,观察 PyTorch 如何动态记录张量运算,并通过反向传播计算和清零梯度。