
机器学习与深度学习 / 系统课时
批量大小与显存预算
批量大小与显存预算
本课建立一套可计算、可测量的显存预算方法,把模型参数、梯度、优化器状态、激活值和临时缓冲区分开估算。完成后,你能找到设备可稳定运行的微批量大小,并用梯度累积扩展有效批量。
学习目标
- 识别训练显存的固定部分与随批量变化的部分
- 使用 PyTorch 测量不同批量大小的峰值显存
- 在安全余量、吞吐量和有效批量之间做出合理选择
拆解显存构成
训练峰值显存可以近似写成:
参数、梯度和优化器状态主要由参数量与数据类型决定,通常可视为固定成本。激活值需要保留到反向传播,通常随批量大小近似线性增长,也是批量增大后最先触发显存不足的部分。临时缓冲区和框架保留显存则会受算子实现、输入形状和内存碎片影响。
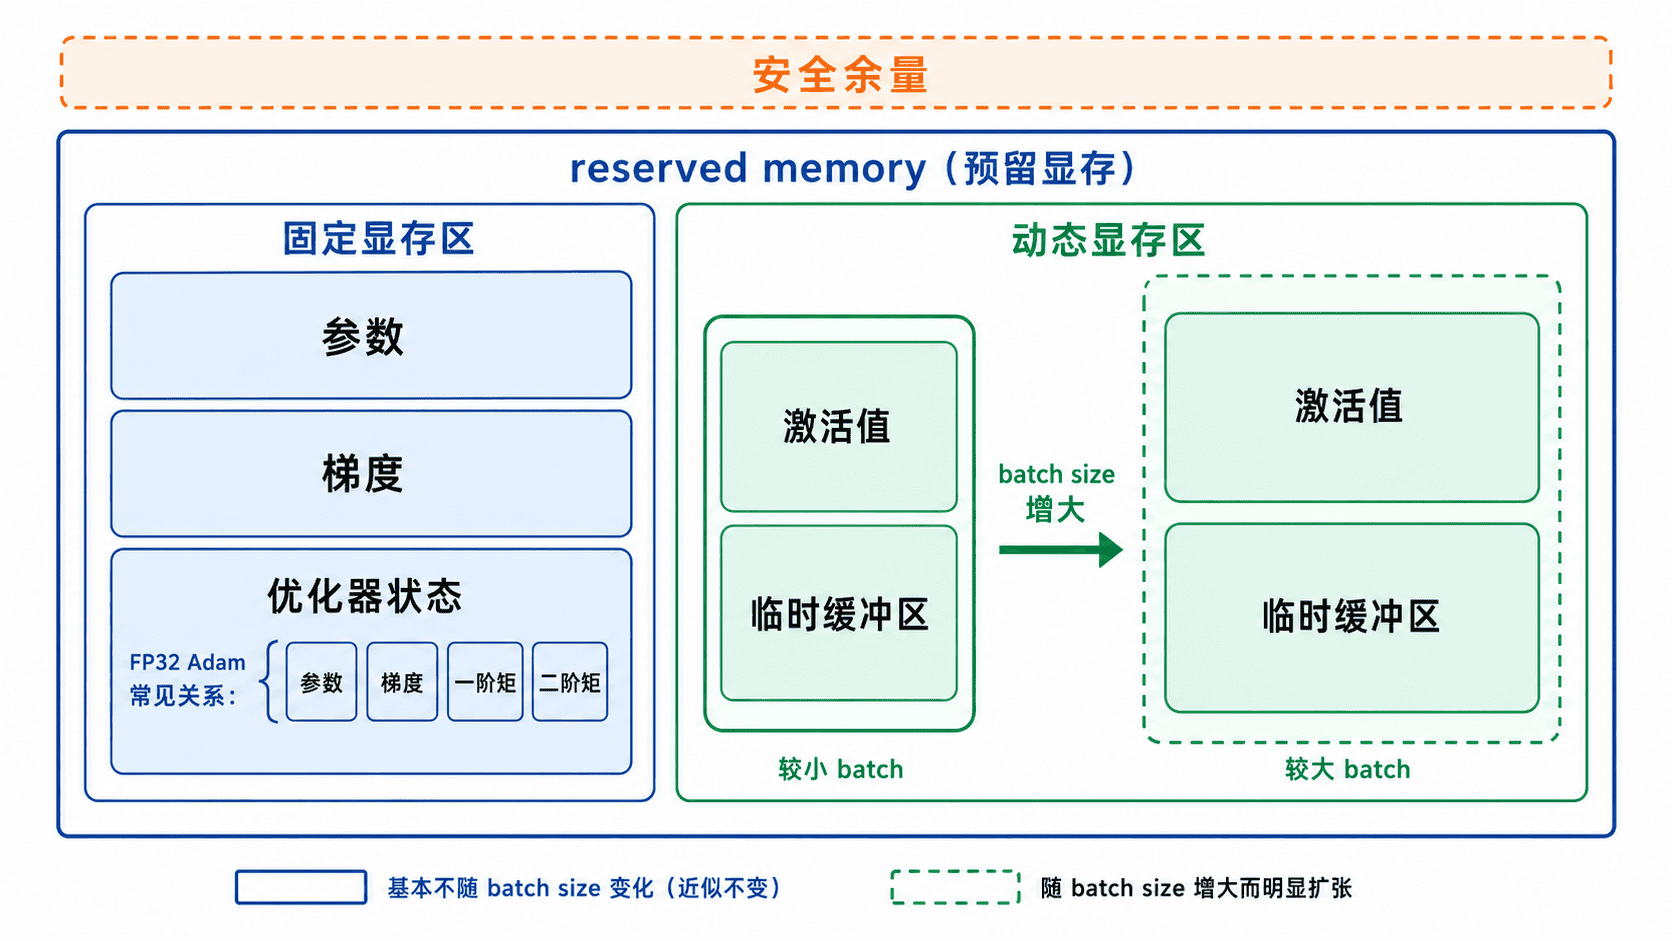
以 FP32 和 Adam 类优化器为例,每个参数至少可能对应 4 字节参数、4 字节梯度以及两组各 4 字节的动量状态,静态成本约为每参数 16 字节。混合精度训练可能降低激活值占用,但若保留 FP32 主权重,静态部分不会按相同比例下降。
测量不同批量的峰值
估算用于预判,最终选择必须以实际测量为准。下面的脚本在 CUDA 上分别测试多个批量大小,输出峰值已分配显存和峰值保留显存。每次测试都会重新创建模型与优化器,避免前一次运行残留状态影响结果。
import gc

import torch
from torch import nn

if not torch.cuda.is_available():
    raise SystemExit("需要 CUDA GPU 才能测量显存。")

device = torch.device("cuda")

class TinyCNN(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 64, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(64, 128, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(128, 256, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d(1),
        )
        self.classifier = nn.Linear(256, 10)

    def forward(self, inputs: torch.Tensor) -> torch.Tensor:
        features = self.features(inputs)
        return self.classifier(features.flatten(1))

def to_mib(byte_count: int) -> float:
    return byte_count / 1024**2

def measure(batch_size: int) -> tuple[float, float]:
    gc.collect()
    torch.cuda.empty_cache()
    torch.cuda.reset_peak_memory_stats()

    # 模型、梯度和 AdamW 状态都计入本轮峰值。
    model = TinyCNN().to(device)
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
    criterion = nn.CrossEntropyLoss()

    inputs = torch.randn(batch_size, 3, 224, 224, device=device)
    labels = torch.randint(0, 10, (batch_size,), device=device)

    optimizer.zero_grad(set_to_none=True)
    logits = model(inputs)
    loss = criterion(logits, labels)
    loss.backward()
    optimizer.step()
    torch.cuda.synchronize()

    peak_allocated = torch.cuda.max_memory_allocated()
    peak_reserved = torch.cuda.max_memory_reserved()

    del model, optimizer, criterion, inputs, labels, logits, loss
    torch.cuda.empty_cache()
    return to_mib(peak_allocated), to_mib(peak_reserved)

print(f"GPU: {torch.cuda.get_device_name(0)}")
for batch_size in (8, 16, 32, 64, 128):
    try:
        allocated, reserved = measure(batch_size)
        print(
            f"batch={batch_size:>3} "
            f"allocated={allocated:>8.1f} MiB "
            f"reserved={reserved:>8.1f} MiB"
        )
    except torch.OutOfMemoryError:
        torch.cuda.empty_cache()
        print(f"batch={batch_size:>3} OOM")
预期输出如下。显卡型号和数值属于动态结果,较大的批量可能成功,也可能显示 OOM。
GPU: <GPU_NAME>
batch=  8 allocated=<MEM_MIB> MiB reserved=<MEM_MIB> MiB
batch= 16 allocated=<MEM_MIB> MiB reserved=<MEM_MIB> MiB
batch= 32 allocated=<MEM_MIB> MiB reserved=<MEM_MIB> MiB
batch= 64 allocated=<MEM_MIB> MiB reserved=<MEM_MIB> MiB
batch=128 OOM
allocated 表示张量当前实际使用或曾达到的显存,reserved 表示 PyTorch 缓存分配器向 CUDA 申请并保留的显存。出现 reserved 明显高于 allocated 时,不一定是泄漏,也可能是缓存和碎片造成的差异。
选择安全批量大小
不要把“刚好不 OOM”当成可用配置。训练中还可能出现验证步骤、更大样本、保存检查点、通信缓冲区或算子工作区,因此通常应保留约 10%~20% 的显存余量,并用多个完整迭代验证峰值是否稳定。
选择时先找到最大可运行微批量,再比较吞吐量。批量翻倍并不保证每秒样本数翻倍;当算力已饱和,继续增大批量只会增加显存和单步延迟。最终配置应同时满足不溢出、吞吐量较高和收敛行为可接受。
显存不足但又需要更大的有效批量时,可以使用梯度累积:
例如单卡微批量为 16,累计 4 次后再更新参数,有效批量就是 64。梯度累积降低的是单次前向与反向所需的激活显存,但不会减少模型参数、梯度和优化器状态的固定成本。
本课总结
- 训练显存由固定成本、随批量增长的激活值以及临时和保留空间共同组成
- 批量大小必须通过真实峰值测量确定,并为运行波动保留安全余量
- 显存受限时可用梯度累积扩大有效批量,但它不能消除参数与优化器状态占用
下一课预告
下一课将继续优化训练资源使用,重点介绍混合精度训练如何降低激活显存、提升张量核心利用率,以及何时需要保留 FP32 精度路径。