
机器学习与深度学习 / 系统课时
定义项目目标与指标
定义项目目标与指标
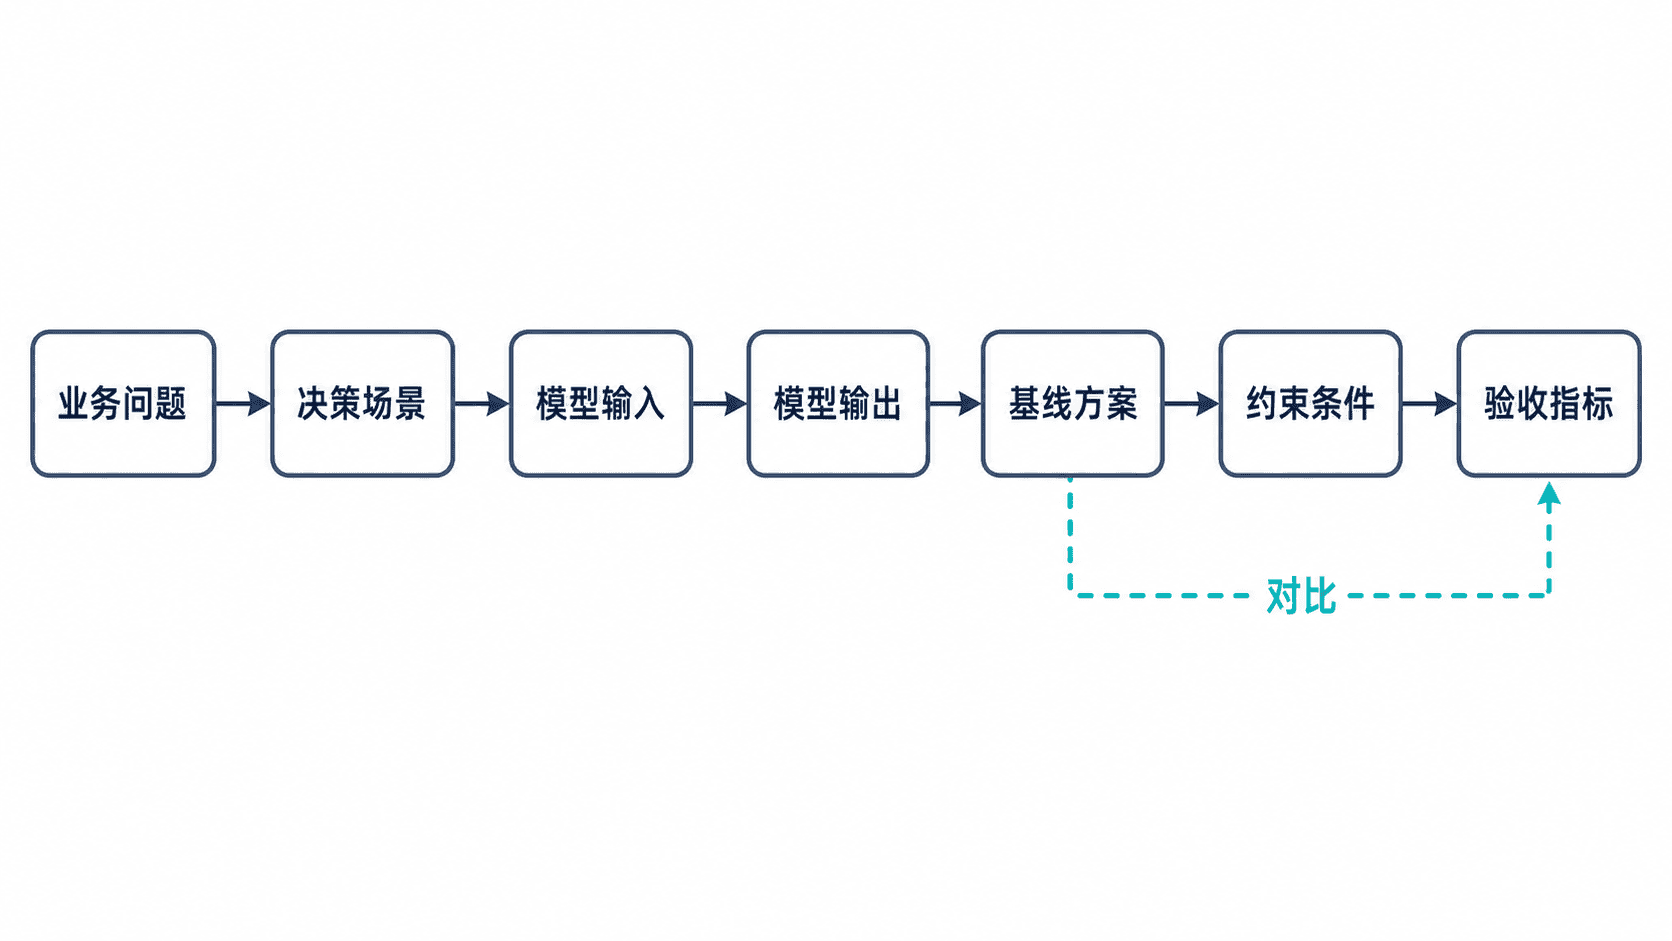
本课把一个模糊的深度学习想法整理成可执行项目定义,最终得到明确的业务目标、输入输出、基线、约束和可自动检查的验收指标,避免模型训练完成后才发现“做对了技术,却没有解决问题”。
学习目标
- 把业务问题改写为可观察、可验证的项目目标
- 明确模型的输入、输出、适用范围和失败边界
- 建立同时覆盖效果、性能与资源约束的验收指标
从业务问题写到项目目标
项目目标不能只写“提高识别准确率”,而要说明谁在什么场景下做什么决策,以及模型结果如何改变该决策。一个可执行的目标通常包含业务对象、触发条件、模型输出、使用动作和期望收益。
例如,客服工单分类项目可以定义为:系统接收新工单文本,在两秒内输出一个类别及置信度;高置信度结果自动路由,低置信度结果进入人工队列;上线后自动路由覆盖率提升,同时误路由率不得超过现有规则系统。
固定输入、输出与适用范围
输入定义要包含数据形式、必要字段、尺寸或长度限制,以及线上数据到达方式。输出定义不仅要写类别或数值,还要规定置信度、排序、阈值和异常返回方式。
| 要素 | 工单分类示例 | 必须回答的问题 |
|---|---|---|
| 输入 | 工单标题与正文 | 是否允许空文本,最长多少字符 |
| 输出 | 类别、置信度、模型版本 | 低置信度如何处理 |
| 范围 | 中文售后工单 | 是否覆盖多语言和图片附件 |
| 失败边界 | 内容缺失或超长 | 返回错误还是转人工 |
适用范围必须与训练数据一致。训练集没有覆盖的语言、设备、地区或业务类型,应明确列为暂不支持,而不是依赖模型在未知分布上“自行泛化”。
建立基线与验收指标
基线是新方案必须超过的参照物,可以是人工规则、简单统计模型、现网模型或人工处理结果。没有基线时,即使离线指标看起来很高,也无法判断项目是否真正带来改进。
验收指标应分成主指标和护栏指标。主指标衡量任务效果,例如宏平均 F1;护栏指标限制不能被牺牲的条件,例如延迟、模型大小、误拒率和单次推理成本。每项指标都要写明数据集、计算方法、方向和阈值。
| 指标 | 方向 | 示例阈值 | 角色 |
|---|---|---|---|
| Accuracy | 不低于 | 0.90 | 整体效果 |
| Macro-F1 | 不低于 | 0.88 | 类别均衡效果 |
| P95 延迟 | 不高于 | 80 ms | 在线性能护栏 |
| 模型大小 | 不高于 | 40 MB | 部署资源护栏 |
用脚本执行验收检查
下面的脚本把指标和阈值写成机器可执行规则。真实项目中,指标值应由评估流水线生成,再交给同类检查逻辑决定是否允许发布。
metrics = {
    "accuracy": 0.912,
    "macro_f1": 0.884,
    "p95_latency_ms": 76,
    "model_size_mb": 38,
}

thresholds = {
    "accuracy": ("min", 0.90),
    "macro_f1": ("min", 0.88),
    "p95_latency_ms": ("max", 80),
    "model_size_mb": ("max", 40),
}

all_passed = True

for name, (direction, limit) in thresholds.items():
    value = metrics[name]
    passed = value >= limit if direction == "min" else value <= limit
    all_passed = all_passed and passed
    status = "PASS" if passed else "FAIL"
    print(f"{name}: {value} {direction} {limit} -> {status}")

print(f"release_decision={'PASS' if all_passed else 'FAIL'}")
预期输出
accuracy: 0.912 min 0.9 -> PASS
macro_f1: 0.884 min 0.88 -> PASS
p95_latency_ms: 76 max 80 -> PASS
model_size_mb: 38 max 40 -> PASS
release_decision=PASS
阈值通过只表示满足当前约定,不代表模型永远可靠。发布前还应确认评估数据版本、推理环境和指标计算代码与验收定义一致。
补齐约束与验收清单
项目约束至少覆盖数据、时间、算力、隐私和上线环境。约束不是附注,而是决定方案是否可落地的边界。例如只能使用 CPU 推理时,模型结构与延迟目标必须从项目开始阶段就共同设计。
最终验收清单应能直接回答:输入是否合法、离线效果是否超过基线、护栏指标是否达标、异常样本如何降级、线上监控是否可用,以及出现回归时能否回滚。任何一项无法验证,都不应写成“默认满足”。
本课总结
- 可执行目标必须连接业务决策、模型输入输出和可观察收益
- 基线负责回答“是否变好”,主指标与护栏指标共同回答“能否上线”
- 约束、失败边界和验收脚本应在训练前确定,而不是发布前补写
下一课预告
下一课将先构建一个最小可运行基线,再系统审计标签、类别分布、重复样本和异常样本,为后续模型改进建立可信的数据起点。