
机器学习与深度学习 / 系统课时

链式法则与反向传播

链式法则与反向传播

多层神经网络把许多简单运算串联成复合函数。本课从单变量链式法则出发,拆解前向计算、局部导数与梯度回传,最终完成一个可手算验证的反向传播过程。

学习目标

  • 理解链式法则为何能计算复合函数的导数
  • 掌握计算图中梯度从输出向输入传播的规则
  • 能手算一个简单神经元的参数梯度

从复合函数理解链式法则

设中间变量 u=g(x)u=g(x),最终输出 y=f(u)y=f(u)。当 xx 发生微小变化时,它先影响 uu,再通过 uu 影响 yy,因此总变化率是两段局部变化率的乘积:

dydx=dydududx\frac{\mathrm{d}y}{\mathrm{d}x} = \frac{\mathrm{d}y}{\mathrm{d}u} \frac{\mathrm{d}u}{\mathrm{d}x}

对更深的复合函数,规则继续连乘。若 L=f3(f2(f1(x)))L=f_3(f_2(f_1(x))),则:

dLdx=∂L∂f2∂f2∂f1∂f1∂x\frac{\mathrm{d}L}{\mathrm{d}x} = \frac{\partial L}{\partial f_2} \frac{\partial f_2}{\partial f_1} \frac{\partial f_1}{\partial x}

链式法则的关键不是记住长公式,而是把复杂函数拆成简单节点,每个节点只计算自己的局部导数。
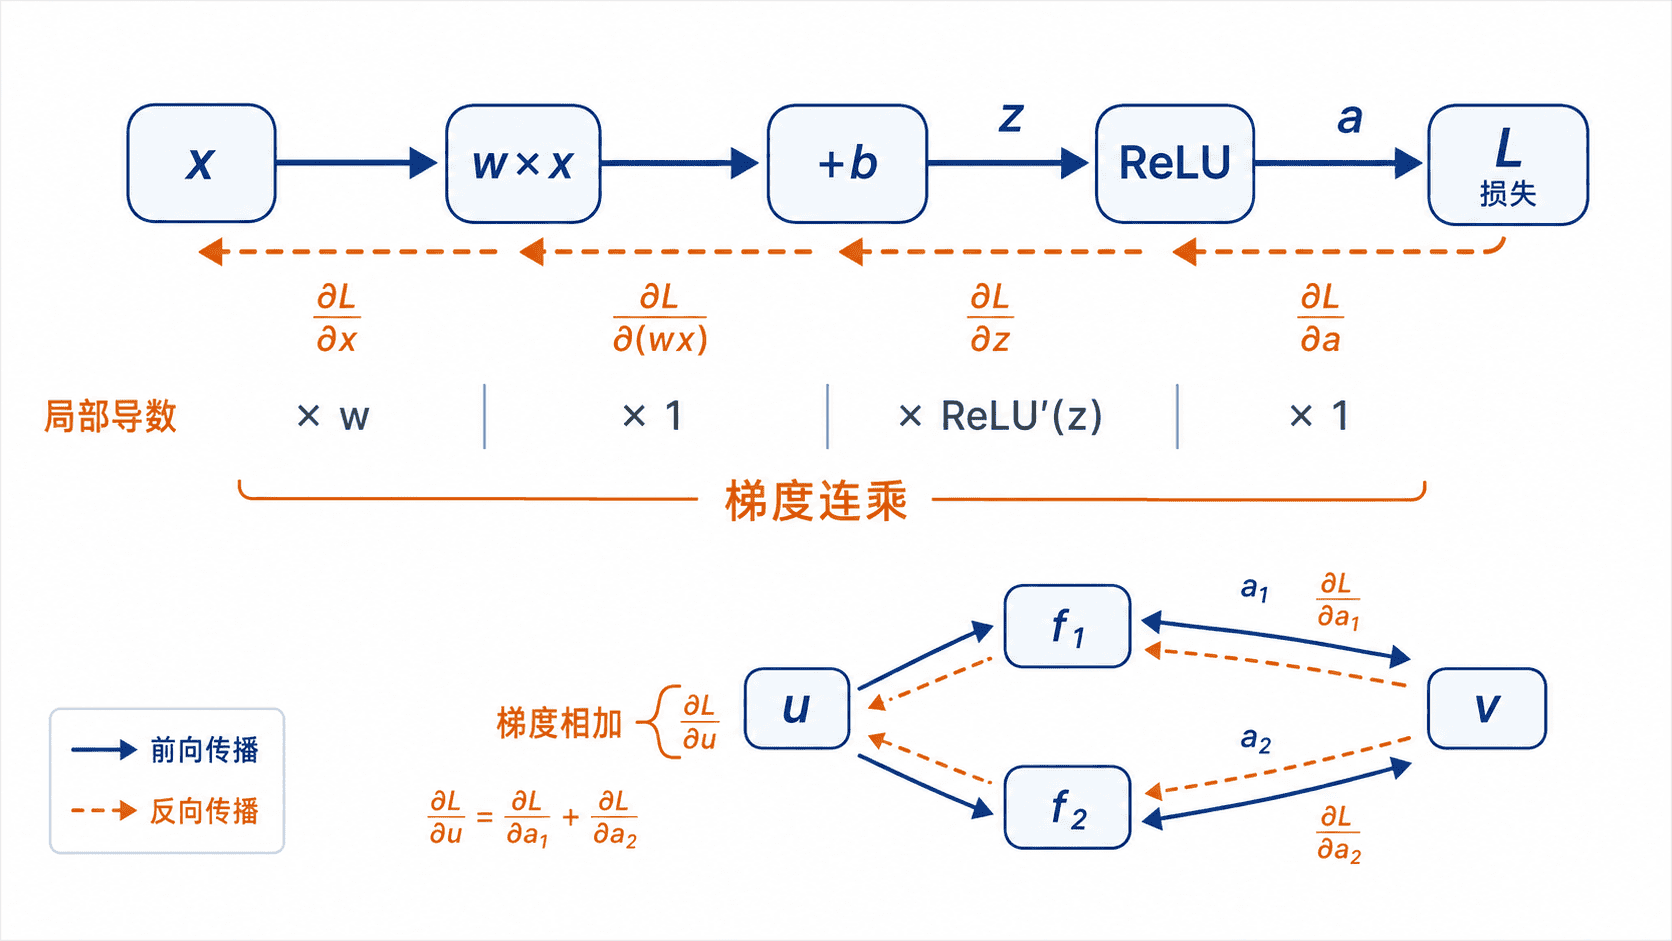
链式法则与反向传播计算图

反向传播如何工作

神经网络训练先执行前向传播,依次计算各层输出和最终损失,同时保存反向计算需要的中间值。随后从损失 LL 开始,把初始梯度设为 ∂L/∂L=1\partial L/\partial L=1,按照计算图的反方向逐节点回传。

每个节点只完成两件事:计算自己的局部导数,并把上游梯度乘以局部导数后传给输入。若同一变量通过多条路径影响损失,各路径返回的梯度必须相加:

∂L∂u=∑k∂L∂vk∂vk∂u\frac{\partial L}{\partial u} = \sum_k \frac{\partial L}{\partial v_k} \frac{\partial v_k}{\partial u}

这种从一个标量损失反向计算大量参数梯度的方法称为反向模式自动微分。它特别适合神经网络,因为训练通常只有一个损失,却包含成千上万个参数。

手算一个神经元的梯度

考虑一个标量神经元:

z=wx+b,a=ReLU⁡(z),L=12(a−y)2z=wx+b,\quad a=\operatorname{ReLU}(z),\quad L=\frac{1}{2}(a-y)^2

取 x=2x=2、w=3w=3、b=−1b=-1、y=4y=4。前向计算得到 z=5z=5、a=5a=5、L=0.5L=0.5。由于 z>0z>0,ReLU 的局部导数为 1。

反向计算按损失到输入的顺序进行:

∂L∂a=a−y=1\frac{\partial L}{\partial a}=a-y=1
∂L∂z=∂L∂a∂a∂z=1×1=1\frac{\partial L}{\partial z} = \frac{\partial L}{\partial a} \frac{\partial a}{\partial z} = 1\times1=1

于是参数与输入的梯度为:

梯度 计算 结果
∂L/∂w\partial L/\partial w (∂L/∂z)⋅x(\partial L/\partial z)\cdot x 22
∂L/∂b\partial L/\partial b (∂L/∂z)⋅1(\partial L/\partial z)\cdot 1 11
∂L/∂x\partial L/\partial x (∂L/∂z)⋅w(\partial L/\partial z)\cdot w 33

若使用学习率 η=0.1\eta=0.1 做一次梯度下降,参数更新为 w=3−0.1×2=2.8w=3-0.1\times2=2.8,b=−1−0.1×1=−1.1b=-1-0.1\times1=-1.1。更新方向与梯度相反,目的是减小损失。

常见易错点

链式法则中的乘法顺序来自依赖关系,而不是变量书写顺序。遇到复杂网络时,应先画出计算图,再从损失沿依赖边反向追踪。

ReLU 在 z<0z<0 时导数为 0,这会阻断该样本上的梯度;在 z=0z=0 处不可导,工程实现通常约定一个次梯度值。分支节点的梯度必须求和,不能只保留其中一条路径。

训练框架会把梯度累积到参数的梯度缓冲区。开始下一次反向传播前通常需要清零,否则得到的是多次计算的累加结果。

本课总结

  • 链式法则把复合函数的总导数分解为沿路径的局部导数连乘
  • 反向传播从损失出发逆序遍历计算图,并在分支汇合处累加梯度
  • 手算梯度时应先完成前向值,再按依赖关系逐节点回传

下一课预告

下一课将学习概率分布、条件概率、期望与方差,并理解它们如何进入损失函数、数据建模和不确定性描述。

按自己的节奏,确认真正理解。

目录与阅读设置

阅读设置

17

记录一个想法

链式法则与反向传播

0 / 10000 · 笔记保存到账号。未提交的修改会在关闭、离开或刷新后丢失。

登录哪都通