
机器学习与深度学习 / 系统课时
缩放点积注意力
缩放点积注意力
本课把注意力机制落实为可计算的矩阵过程。你将从查询、键和值出发,依次完成点积打分、尺度缩放、Softmax 归一化和加权聚合,并用一个可运行示例验证每一步的结果。
学习目标
- 写出缩放点积注意力的完整公式
- 解释为什么分数要除以
- 使用矩阵示例验证权重与输出形状
输入与最终目标
设查询矩阵为 ,键矩阵为 ,值矩阵为 。查询数量可以与键值数量不同,但键和值必须拥有相同的条目数 。
缩放点积注意力的完整表达式是:
最终输出形状为 。每个查询都会得到一行权重,并据此生成一个新的值表示。
四步计算过程
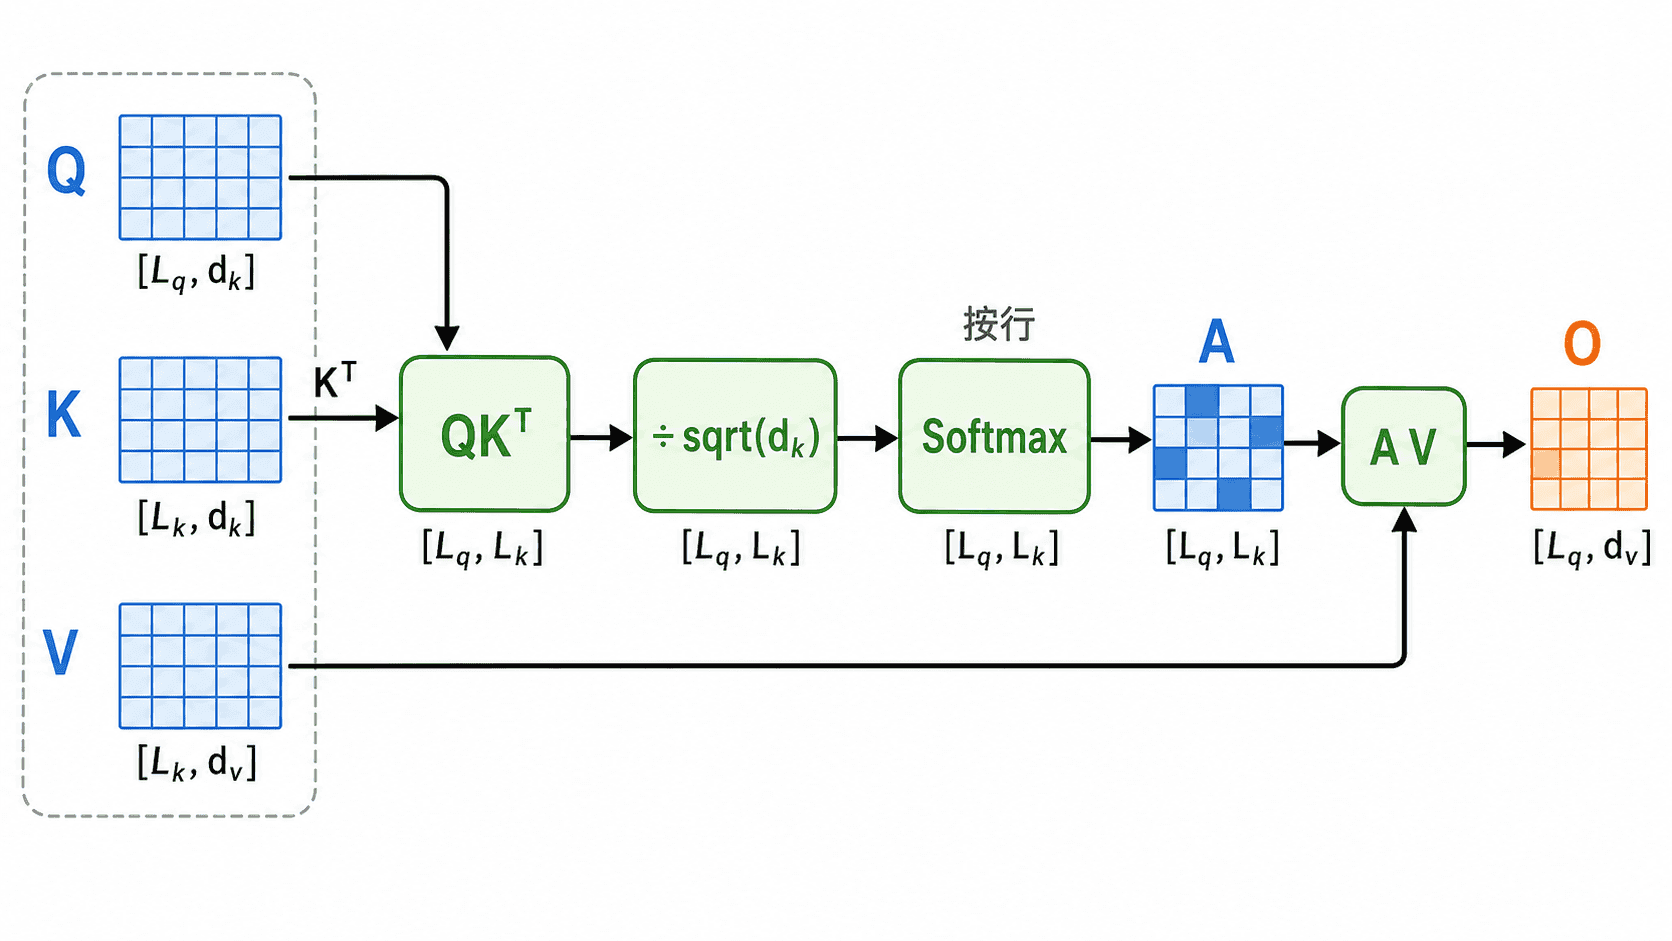
第一步计算 。每个查询会与每个键做点积,因此得到形状为 的分数矩阵。
第二步将分数除以 。当维度增大时,点积绝对值通常也会变大,Softmax 容易进入接近 0 或 1 的饱和区域,导致梯度过小;缩放可让分数保持在更稳定的范围。
第三步对分数矩阵的每一行执行 Softmax。每一行对应一个查询,各列权重非负且总和为 1。
第四步用权重矩阵乘以 。这会把每个查询对应的一组权重应用到所有值上,得到最终输出。
用代码验证完整计算
下面使用两个查询、两个键和两个值。为便于核对, 与 采用单位矩阵,值矩阵的两行分别携带不同信息。
import math
import numpy as np

Q = np.array([[1.0, 0.0], [0.0, 1.0]])
K = np.array([[1.0, 0.0], [0.0, 1.0]])
V = np.array([[10.0, 0.0], [0.0, 20.0]])

# 点积分数除以 sqrt(d_k),避免高维分数过大
scaled_scores = Q @ K.T / math.sqrt(K.shape[-1])

# 逐行执行稳定版 Softmax
shifted = scaled_scores - scaled_scores.max(axis=-1, keepdims=True)
exp_scores = np.exp(shifted)
weights = exp_scores / exp_scores.sum(axis=-1, keepdims=True)

output = weights @ V

np.set_printoptions(precision=4, suppress=True)
print("weights:")
print(weights)
print("output:")
print(output)
预期输出
weights:
[[0.6698 0.3302]
 [0.3302 0.6698]]
output:
[[ 6.6976  6.6048]
 [ 3.3024 13.3952]]
第一行查询更匹配第一个键,因此第一个值权重约为 0.6698;但第二个值仍贡献约 0.3302。输出不是某一行值的复制,而是两行值按权重混合后的结果。
关键边界与检查方法
Softmax 必须沿键所在的维度执行,也就是对分数矩阵的最后一维归一化。若沿错误维度计算,权重含义会从“一个查询如何分配到所有键”变成其他关系。
实际模型还可能加入掩码。填充掩码用于忽略无效位置,因果掩码用于阻止当前位置看到未来信息;它们通常在 Softmax 前把不可见位置的分数设为极小值。
验证实现时至少检查三点:权重矩阵形状应为 ,每行权重和应接近 1,最终输出形状应为 。
本课总结
- 缩放点积注意力按“点积、缩放、Softmax、乘值矩阵”四步计算
- 除以 可以缓解高维点积导致的 Softmax 饱和
- Softmax 应沿键维度执行,输出形状由查询数量和值维度决定
下一课预告
下一课将进一步组合多组查询、键和值,理解多头注意力如何并行关注不同类型的关系。