
机器学习与深度学习 / 系统课时
深度学习解决什么问题
深度学习解决什么问题
深度学习擅长从图像、语音、文本等高维数据中自动学习特征,并完成分类、预测、生成与决策。本课将建立一套判断框架:什么问题值得使用深度学习,什么问题反而用规则或传统算法更合适。
学习目标
- 识别深度学习最适合处理的数据类型和典型任务
- 理解深度学习与传统规则系统在解决路径上的差异
- 能根据数据规模、目标和成本判断是否应该采用深度学习
深度学习的核心价值
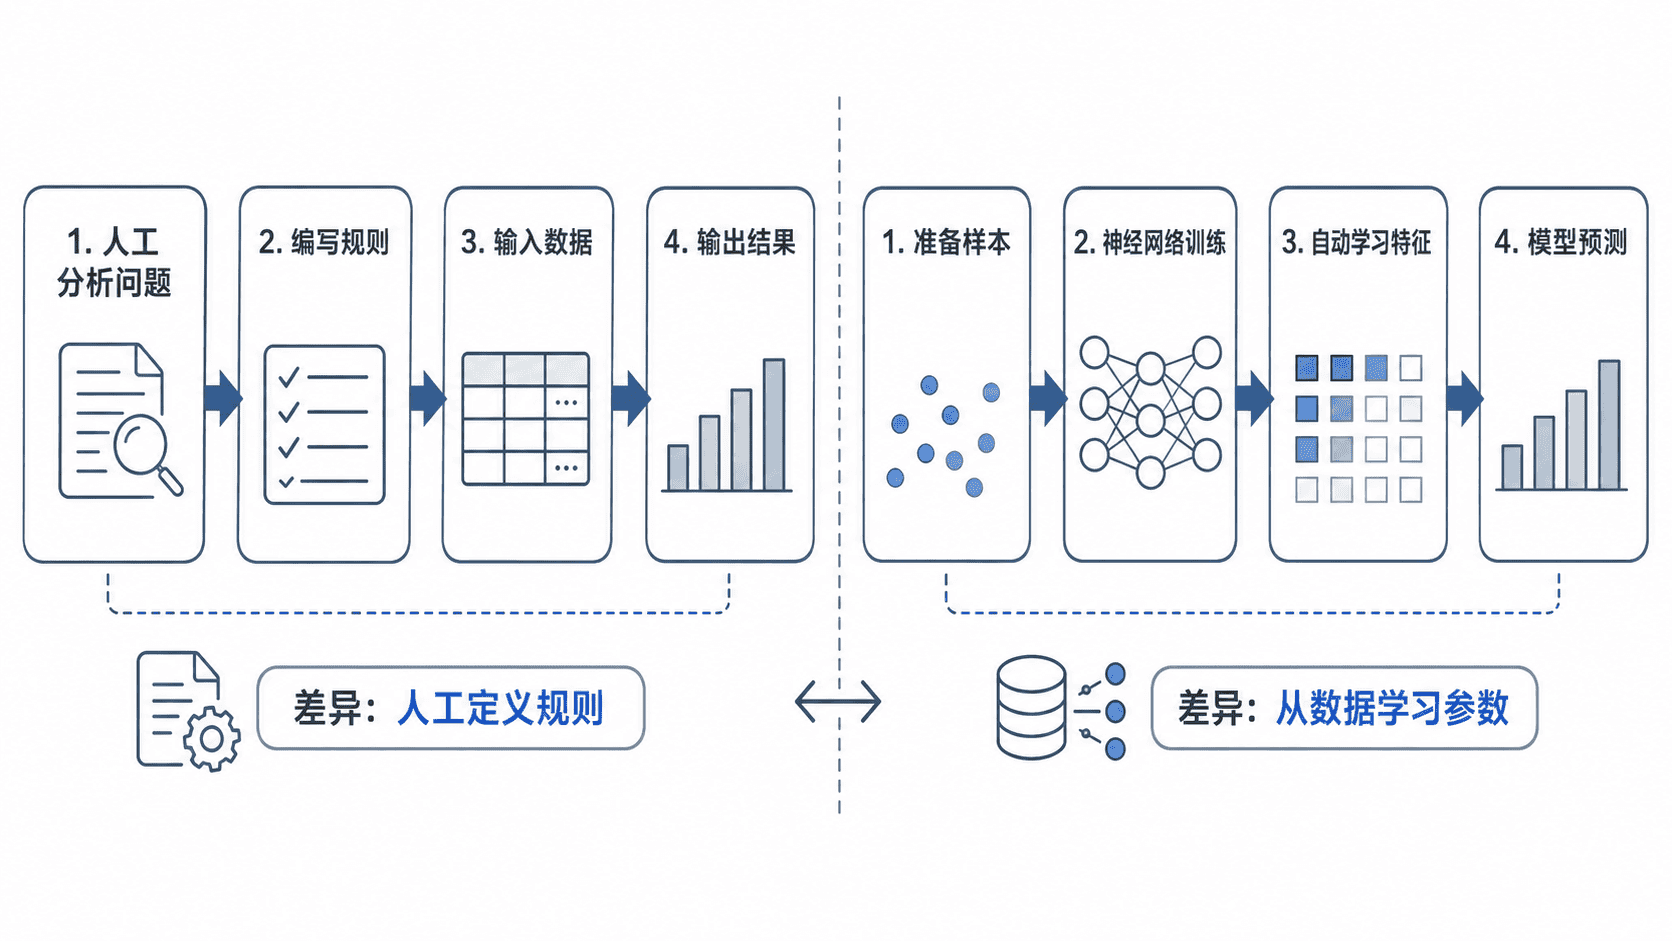
传统程序通常由开发者先写出规则,再让计算机按规则处理输入。深度学习则把大量样本交给神经网络,通过训练自动调整参数,从数据中形成可复用的表示。
这种方法最有价值的地方,不是“替代所有算法”,而是处理难以穷举规则的问题。例如,开发者很难写出一套完整规则来描述所有猫的外观,却可以用大量带标签图片训练模型识别猫。
适合处理的数据类型
深度学习尤其适合高维、非结构化或模式复杂的数据。图像由大量像素组成,语音包含连续声学信号,文本具有上下文和语义关系,这些数据很难直接写成固定规则。
结构化表格数据也能使用深度学习,但不一定总有优势。如果数据量较小、字段明确、解释性要求高,线性模型、决策树或梯度提升树往往更简单,也更容易调试。
常见任务类型
在识别类任务中,模型把输入映射为类别或数值,例如图像分类、语音识别、垃圾邮件判断和销量预测。在生成类任务中,模型学习数据分布,再生成文本、图片、音频或代码。
深度学习还可以完成检测、分割、推荐、排序和控制。它们看似不同,本质上都是通过训练数据学习输入与目标之间的复杂映射关系。
与规则系统的差异
规则系统的行为由条件明确决定,适合流程稳定、边界清楚、错误成本高且必须解释的场景。例如税率计算、权限校验和订单状态流转,通常应优先使用确定性规则。
深度学习的输出来自统计学习,适合规则难写但样本充足的场景。它能够处理模糊输入,却可能出现误判,因此不能把模型预测直接等同于业务事实。
| 判断维度 | 规则系统 | 深度学习 |
|---|---|---|
| 知识来源 | 人工编写条件 | 从训练数据学习 |
| 适合问题 | 边界明确、逻辑稳定 | 模式复杂、规则难穷举 |
| 数据需求 | 较低 | 通常较高 |
| 可解释性 | 较强 | 通常较弱 |
| 维护重点 | 修改规则 | 更新数据并重新训练 |
什么时候不该使用
如果问题可以用少量规则稳定解决,使用深度学习只会增加数据准备、训练、部署和监控成本。如果没有足够样本,模型也难以学到可靠规律。
还要考虑错误后果。医疗、金融审批或安全控制等高风险场景,即使使用模型,也需要人工复核、规则兜底、阈值控制和持续评估,而不是只看一次准确率。
本课总结
- 深度学习的优势是从复杂数据中自动学习特征和映射关系
- 图像、语音、文本等非结构化数据是最典型的应用对象
- 能用稳定规则解决的问题,不应为了“智能化”强行使用深度学习
下一课预告
下一课将梳理机器学习与深度学习的关系,并把监督学习、无监督学习、自监督学习和强化学习放进同一张知识地图中。