
机器学习与深度学习 / 系统课时
训练、推理与部署的区别
训练、推理与部署的区别
同一个深度学习模型,在开发过程中会经历训练、推理和部署三个阶段。本课将从计算目标、输入输出、资源需求与质量指标四个角度拆开它们,帮助你判断当前问题究竟属于模型学习、结果预测,还是工程交付。
学习目标
- 说清训练、推理与部署各自解决的问题
- 区分三个阶段的输入输出、资源瓶颈和评价指标
- 能根据实际需求选择正确的优化方向
三个阶段分别在做什么
训练的目标是“让模型学会”。程序反复读取带标签或带目标的数据,执行前向计算、损失计算、反向传播和参数更新,最终得到一组可保存的模型参数。
推理的目标是“让模型给出答案”。程序加载已经训练好的参数,只执行前向计算,不再计算梯度,也不再修改权重。输入可以是一张图片、一段文本或一组特征,输出通常是分类结果、概率、坐标或生成内容。
部署的目标是“让推理稳定地服务真实用户”。它不仅包含模型预测,还包括模型格式转换、服务接口、并发控制、监控、版本发布、回滚和硬件适配。一个离线准确率很高的模型,若响应慢、占用大或经常失败,仍不能算部署成功。
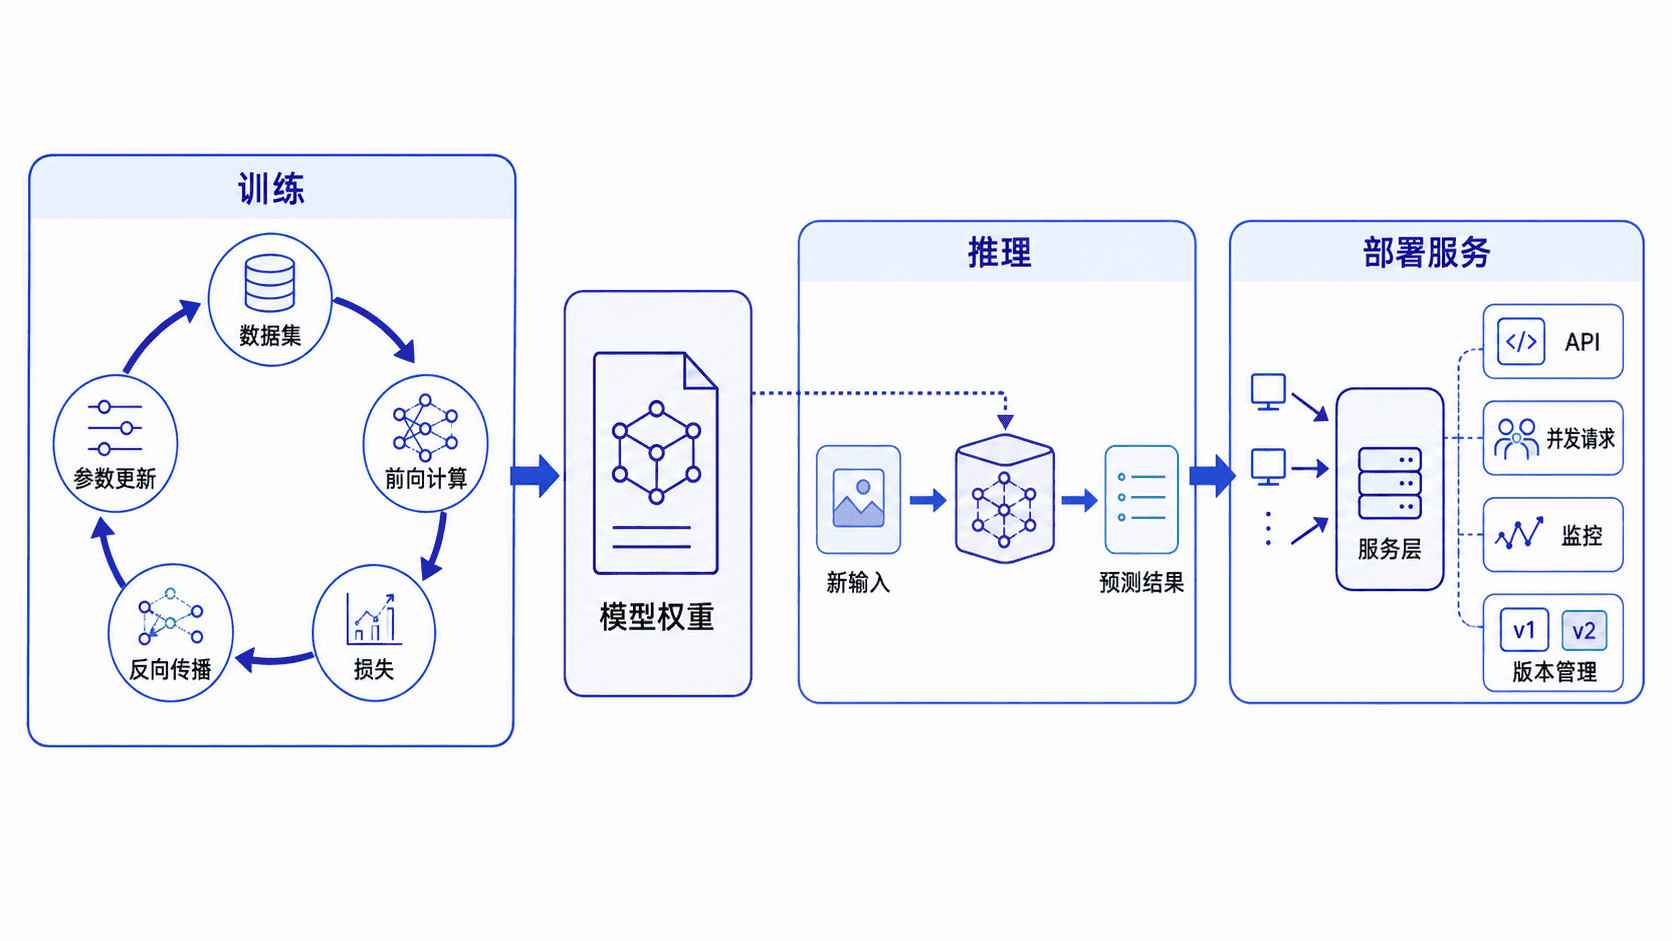
输入、输出与计算方式
| 阶段 | 主要输入 | 主要输出 | 是否更新参数 | 典型计算 |
|---|---|---|---|---|
| 训练 | 训练数据、标签、初始参数 | 新模型参数、训练日志 | 是 | 前向计算、损失、反向传播 |
| 推理 | 新样本、已训练参数 | 预测结果 | 否 | 前向计算 |
| 部署 | 模型、服务配置、真实请求 | 稳定接口、监控指标 | 通常否 | 推理加工程调度 |
训练通常一次处理一批样本,以提高硬件利用率;推理既可能批量离线执行,也可能逐条响应在线请求。部署阶段还要处理模型加载、请求排队、超时、异常和资源隔离,这些都不属于模型数学本身。
下面的脚本用同一程序模拟三个阶段的职责差异。它不训练真实神经网络,只用于观察每个阶段关心的输入和产物。
import argparse

def run_training() -> None:
    print("stage=training")
    print("input=labeled_dataset")
    print("output=model_weights.pt")
    print("updates_parameters=true")

def run_inference() -> None:
    print("stage=inference")
    print("input=new_sample+model_weights.pt")
    print("output=prediction")
    print("updates_parameters=false")

def run_deployment() -> None:
    print("stage=deployment")
    print("input=model+service_config+requests")
    print("output=stable_prediction_api")
    print("focus=latency,throughput,availability")

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("stage", choices=["training", "inference", "deployment"])
    args = parser.parse_args()
    {
        "training": run_training,
        "inference": run_inference,
        "deployment": run_deployment,
    }[args.stage]()
运行部署阶段:
python lifecycle_demo.py deployment预期输出:
stage=deployment
input=model+service_config+requests
output=stable_prediction_api
focus=latency,throughput,availability
资源需求与质量指标
训练最关注算力、显存、训练时间和收敛效果。常用指标包括训练损失、验证集准确率、召回率,以及模型是否过拟合。训练可以持续数小时甚至更久,但通常不直接面对用户请求。
推理更关注单次预测成本。在线服务常看延迟、吞吐量、内存占用和输出质量;离线批处理则更看整体处理速度和单位样本成本。关闭梯度、调整批大小和使用更合适的数值精度,都是推理优化手段。
部署还要增加可用性指标,例如成功率、超时率、错误率、资源峰值和版本回滚时间。模型指标回答“预测得准不准”,系统指标回答“服务能不能持续提供结果”,两类指标缺一不可。
常见混淆与判断方法
看到“准确率不够、损失不下降、模型过拟合”,优先检查训练数据、模型结构和训练策略。看到“预测结果正确但太慢”,优先检查推理批量、模型大小、算子和硬件。
看到“本地能预测,线上接口却超时或崩溃”,问题通常已经进入部署范围,应检查模型加载、请求并发、内存、依赖、日志和服务配置,而不是继续盲目增加训练轮数。
判断阶段时可以先问三个问题:参数是否仍在更新、输入是否来自真实请求、当前指标是模型质量还是服务质量。答案通常能迅速缩小排查范围。
本课总结
- 训练负责学习参数,推理负责使用参数,部署负责把推理变成稳定服务
- 三个阶段的输入输出、资源瓶颈和质量指标不同,优化方法不能混用
- 先判断问题所在阶段,再决定调整数据、模型、推理过程还是服务系统
下一课预告
下一课将搭建课程所需的 Python 环境,并把后续实践项目、硬件选择和阶段性学习成果串成一条可执行路线。