
机器学习与深度学习 / 系统课时
冻结骨干网络
冻结骨干网络
本课完成一个可运行的迁移学习最小示例:加载预训练 ResNet18,替换分类头,冻结骨干网络,并通过参数清单验证优化器只会更新新分类头。
学习目标
- 正确替换预训练模型的分类头
- 使用
requires_grad冻结骨干网络参数 - 验证可训练参数与优化器参数范围一致
实现思路
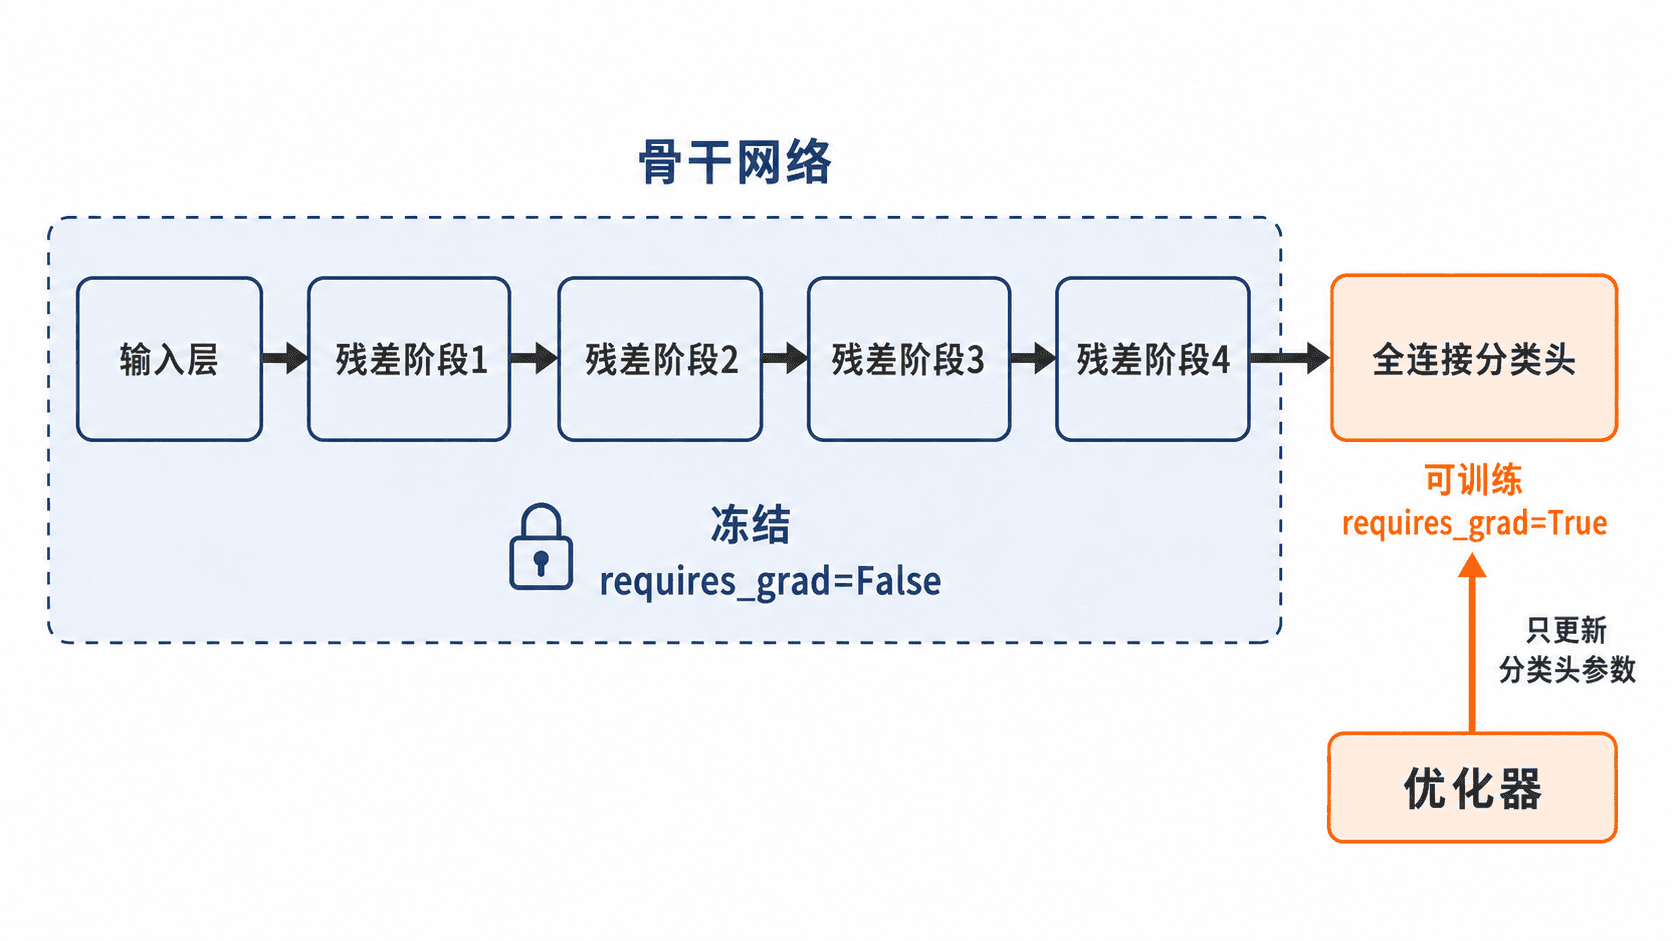
冻结骨干网络时,先加载预训练权重,再把原分类头替换为适配目标类别数的新层。随后将骨干参数的 requires_grad 设为 False,只保留新分类头为可训练状态。
顺序很重要:如果先冻结全部参数,再替换分类头,新创建的分类头默认仍可训练;但显式按模块冻结更清楚,也更不容易在模型结构调整后误伤任务头。
完整代码
下面示例依赖 torch 和 torchvision。首次运行若本机没有权重缓存,程序会下载官方预训练权重。
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

def build_model(num_classes: int) -> nn.Module:
    model = resnet18(weights=ResNet18_Weights.DEFAULT)

    # 冻结现有骨干参数,避免反向传播更新预训练特征。
    for parameter in model.parameters():
        parameter.requires_grad = False

    # 新分类头默认可训练,输入维度必须沿用原全连接层。
    in_features = model.fc.in_features
    model.fc = nn.Linear(in_features, num_classes)
    return model

def main() -> None:
    model = build_model(num_classes=3)

    trainable = [
        name for name, parameter in model.named_parameters()
        if parameter.requires_grad
    ]
    optimizer = torch.optim.Adam(
        (parameter for parameter in model.parameters()
         if parameter.requires_grad),
        lr=1e-3,
    )

    optimizer_parameter_count = sum(
        parameter.numel()
        for group in optimizer.param_groups
        for parameter in group["params"]
    )

    print("Trainable parameters:", trainable)
    print("Optimizer parameter count:", optimizer_parameter_count)

if __name__ == "__main__":
    main()
预期输出如下。权重下载日志和缓存路径可能因环境不同而出现,但最终两行应保持一致。
Trainable parameters: ['fc.weight', 'fc.bias']
Optimizer parameter count: 1539
1539 来自权重参数 与偏置参数 之和。目标类别数变化后,该数值会随之改变。
验证冻结是否真正生效
只查看 model.fc 不足以证明骨干已经冻结。可靠检查应同时覆盖参数状态和优化器范围:前者确认哪些参数允许计算梯度,后者确认优化器实际持有哪些参数。
还可以在一次反向传播后检查骨干参数的 grad 是否为 None。不过在训练前列出可训练参数更直接,也能尽早发现误把某个骨干层加入优化器的问题。
常见错误
直接把 model.fc 替换为新层,却把 model.parameters() 全部传给优化器,会让冻结状态与优化器配置难以核对。虽然 requires_grad=False 的参数不会更新,但显式过滤可训练参数能减少无效管理并提高代码可读性。
另一个常见问题是在后续执行“解冻最后一层”后继续复用当前仅包含分类头参数的优化器。优化器不会自动纳入新解冻的参数,此时应重新创建优化器,或显式把新参数加入参数组。
本课总结
- 冻结骨干网络依赖
requires_grad=False,替换后的分类头保持可训练 - 优化器应只接收可训练参数,并通过名称和参数量双重验证
- 解冻新的骨干层后,需要同步更新优化器参数范围
下一课预告
下一课将进一步解冻部分骨干层,并为分类头与骨干网络设置不同学习率,完成分层微调。