
机器学习与深度学习 / 系统课时
梯度裁剪与异常检测
梯度裁剪与异常检测
梯度异常会让一次参数更新破坏整个训练过程。本课将建立从反向传播、有限性检查、梯度统计、范数裁剪到异常定位的完整防线,并用可运行示例验证裁剪前后的变化。
学习目标
- 区分梯度过大与梯度出现 NaN、Inf 的不同处理方式
- 能在参数更新前检查、统计并裁剪梯度
- 能使用自动求导异常检测定位错误算子
先区分两类问题
梯度爆炸表示梯度仍是有限数值,但范数大到足以造成剧烈更新;NaN 或 Inf 则表示计算已经失效。裁剪可以限制有限梯度的大小,却不能把非有限数值修复为正常梯度,因此必须先检查有限性,再决定是否裁剪和更新。
常见诱因包括学习率过高、输入数据异常、除零、对负数开方、指数溢出、混合精度缩放顺序错误,以及深层网络中的连乘放大。排查时应先确认异常首次出现的位置,而不是只降低学习率掩盖问题。
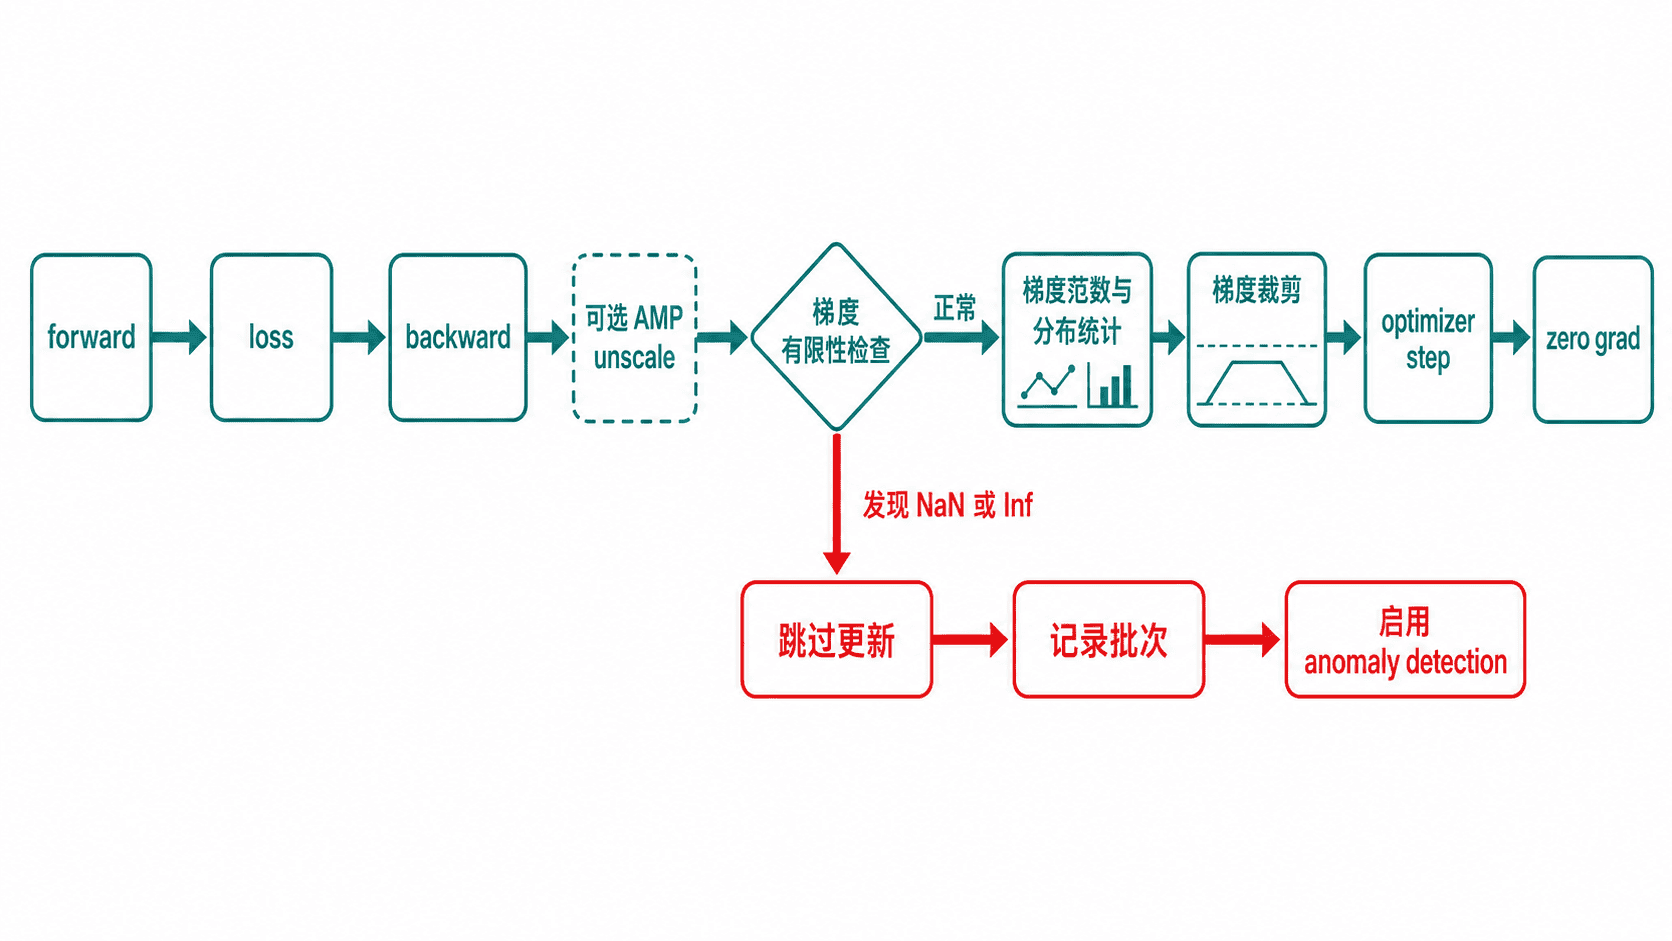
观察梯度再执行裁剪
全局二范数把所有参数梯度视为一个整体,适合判断本轮更新是否异常。分层统计则能发现某一层的梯度范围或标准差明显偏离其他层。训练日志不必记录每个元素,但应定期记录全局范数,并在异常轮次保留各层统计。
下面的程序故意把损失放大,制造很大的有限梯度;随后检查每层分布、把全局范数裁剪到 1.0,并通过异常检测捕获一个会产生 NaN 的反向传播。
import torch
from torch import nn

def total_grad_norm(model):
    norms = [
        parameter.grad.detach().norm(2)
        for parameter in model.parameters()
        if parameter.grad is not None
    ]
    return torch.linalg.vector_norm(torch.stack(norms), ord=2).item()

torch.manual_seed(7)

model = nn.Sequential(
    nn.Linear(4, 8),
    nn.ReLU(),
    nn.Linear(8, 1),
)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

inputs = torch.randn(16, 4)
targets = torch.randn(16, 1)

optimizer.zero_grad(set_to_none=True)
loss = nn.functional.mse_loss(model(inputs), targets) * 1_000_000
loss.backward()

for name, parameter in model.named_parameters():
    gradient = parameter.grad
    print(
        f"{name}: min={gradient.min():.2f}, "
        f"max={gradient.max():.2f}, std={gradient.std(unbiased=False):.2f}"
    )

all_finite = all(
    torch.isfinite(parameter.grad).all().item()
    for parameter in model.parameters()
    if parameter.grad is not None
)
print(f"梯度是否有限={all_finite}")

if not all_finite:
    raise RuntimeError("发现 NaN 或 Inf,跳过参数更新")

before = total_grad_norm(model)
returned = torch.nn.utils.clip_grad_norm_(
    model.parameters(),
    max_norm=1.0,
    error_if_nonfinite=True,
)
after = total_grad_norm(model)

print(f"裁剪前范数={before:.4f}")
print(f"裁剪函数返回值={returned.item():.4f}")
print(f"裁剪后范数={after:.4f}")

optimizer.step()

try:
    # 调试模式会报告产生非有限梯度的反向算子。
    with torch.autograd.detect_anomaly():
        value = torch.tensor([0.0], requires_grad=True)
        bad_loss = (value / value).sum()
        bad_loss.backward()
except RuntimeError:
    print("异常检测:已捕获产生 NaN 的反向传播")
预期输出
0.weight: min=<MIN>, max=<MAX>, std=<STD>
0.bias: min=<MIN>, max=<MAX>, std=<STD>
2.weight: min=<MIN>, max=<MAX>, std=<STD>
2.bias: min=<MIN>, max=<MAX>, std=<STD>
梯度是否有限=True
裁剪前范数=<BEFORE_NORM>
裁剪函数返回值=<BEFORE_NORM>
裁剪后范数=1.0000
异常检测:已捕获产生 NaN 的反向传播<MIN>、<MAX>、<STD> 和 <BEFORE_NORM> 会因 PyTorch 版本与底层计算实现略有差异,但裁剪函数返回的是裁剪前范数,裁剪后范数应接近 1.0。异常检测还会在标准错误流输出对应反向算子的调用信息。
放进真实训练循环
正确顺序是清空旧梯度、前向计算、反向传播、检查非有限值、统计范数、裁剪、更新参数。使用自动混合精度时,应先执行 scaler.unscale_(optimizer),再检查和裁剪;否则检查到的是缩放后的梯度,裁剪阈值没有实际意义。
发现 NaN 或 Inf 时应跳过本轮 optimizer.step(),记录批次索引、损失、学习率和输入范围,并检查数据与算子。error_if_nonfinite=True 能让非有限范数立即抛错,适合尽早阻断污染更新。
异常检测的使用边界
torch.autograd.detect_anomaly() 会保存更多中间信息并显著降低训练速度,因此只应在复现问题的少量批次上启用。长期监控更适合使用 torch.isfinite、全局梯度范数、分层统计以及训练日志告警。
裁剪阈值不是越小越安全。阈值过小会让大量正常梯度都被压缩,训练表现为损失下降缓慢。应先观察正常训练阶段的梯度范数分布,再选择能拦截异常尖峰而不过度干预正常更新的阈值。
本课总结
- 梯度裁剪只处理有限但过大的梯度,NaN 和 Inf 必须先定位根因
- 参数更新前应完成有限性检查、梯度统计和裁剪
- 异常检测适合短时调试,持续监控应依赖低开销指标与日志
下一课预告
下一课将把学习率调度、梯度裁剪和异常检查整合进完整训练循环,并加入检查点保存与恢复,形成可持续运行的训练模板。