
机器学习与深度学习 / 系统课时
自定义 Dataset
自定义 Dataset
本课将把分散的样本读取、标签解析、预处理与异常数据过滤封装进一个可复用的 PyTorch Dataset。完成后,你会得到一个职责清晰、可被 DataLoader 直接消费,并且能在训练前暴露坏数据的最小实现。
学习目标
- 理解
Dataset的__len__与__getitem__协议 - 将清单解析、样本读取和预处理拆分到合适位置
- 用可追踪的方式过滤缺失文件和非法标签
Dataset 的职责边界
自定义 Dataset 负责回答两个问题:数据集中有多少个可用样本,以及给定索引时如何返回一个样本。它不负责批量、打乱、多进程加载或设备迁移,这些工作应交给 DataLoader 和训练循环。
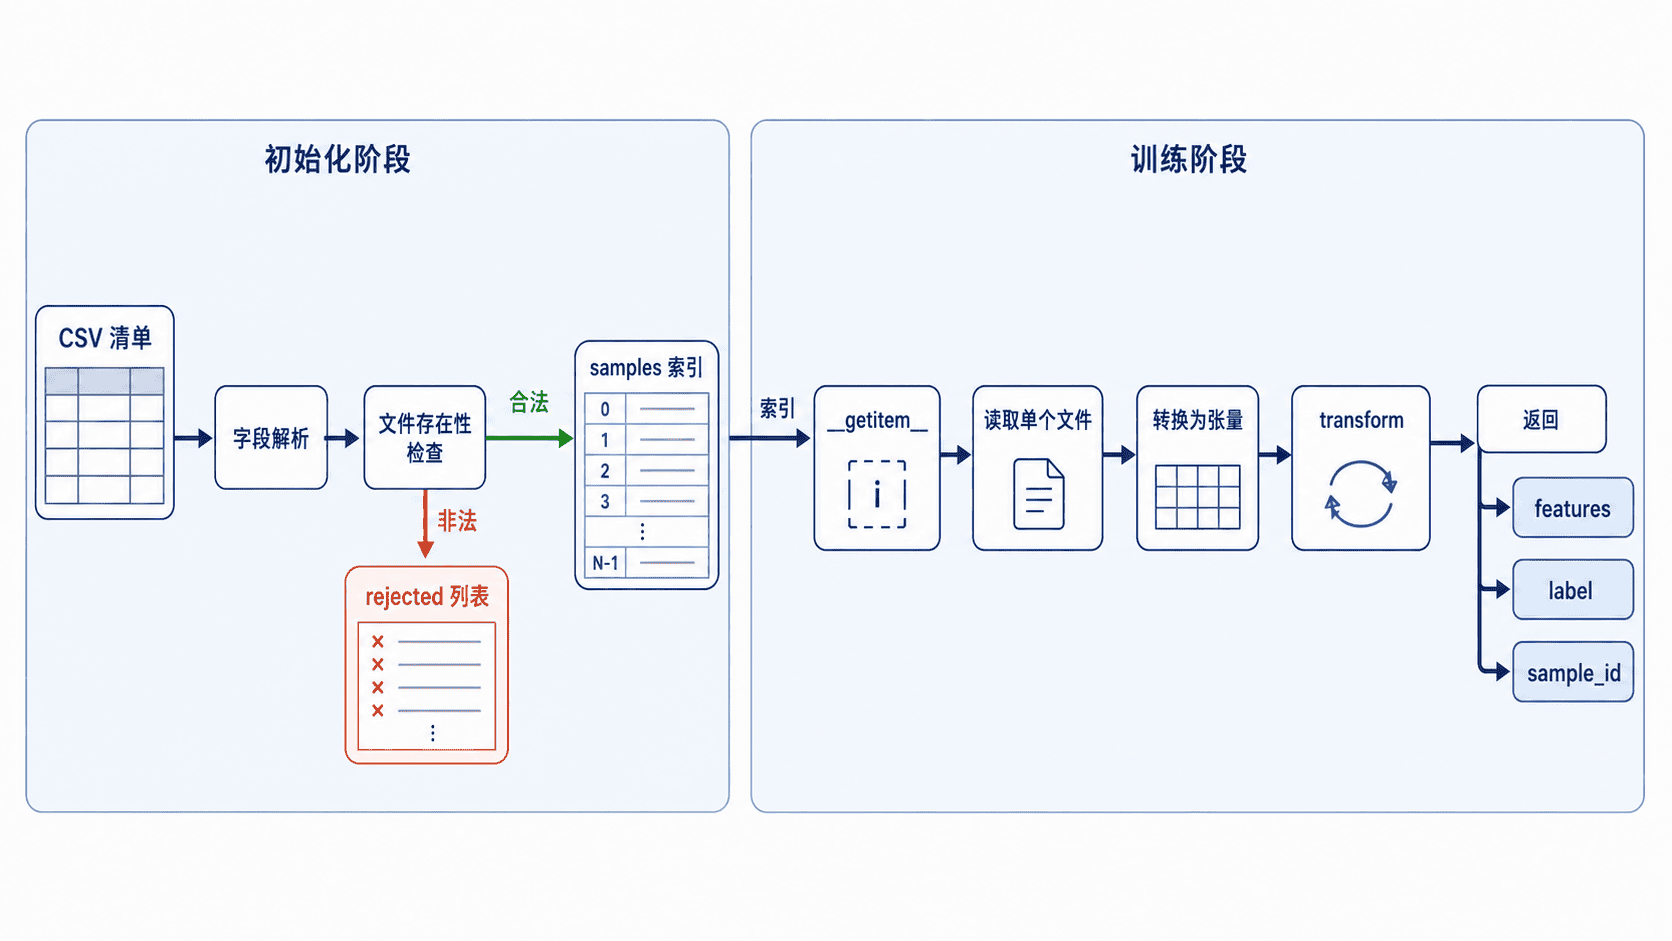
通常应在初始化阶段完成清单读取、路径拼接和明显异常检查,在 __getitem__ 中只读取当前样本并执行轻量预处理。这样既能尽早发现数据问题,也不会在每次取样时重复解析整个清单。
实现一个可运行的数据集
下面的示例会临时创建两个有效样本和一条缺失文件记录。Dataset 在初始化时过滤明显无效的数据,并保留拒绝原因,便于后续生成数据质量报告。
import csv
import tempfile
from pathlib import Path
from typing import Callable, Optional

import torch
from torch import Tensor
from torch.utils.data import Dataset

class NumberDataset(Dataset):
    def __init__(
        self,
        root_dir: Path,
        manifest_path: Path,
        transform: Optional[Callable[[Tensor], Tensor]] = None,
    ) -> None:
        self.root_dir = root_dir
        self.transform = transform
        self.samples: list[tuple[Path, int]] = []
        self.rejected: list[str] = []

        # 在初始化阶段完成结构校验,避免训练中途才发现明显坏数据。
        with manifest_path.open("r", encoding="utf-8", newline="") as file:
            for row in csv.DictReader(file):
                sample_path = root_dir / row["file"]
                try:
                    label = int(row["label"])
                except (TypeError, ValueError):
                    self.rejected.append(f'{row["file"]}: invalid label')
                    continue

                if not sample_path.is_file():
                    self.rejected.append(f'{row["file"]}: file not found')
                    continue

                self.samples.append((sample_path, label))

    def __len__(self) -> int:
        return len(self.samples)

    def __getitem__(self, index: int) -> dict[str, Tensor | str]:
        sample_path, label = self.samples[index]

        try:
            value = float(sample_path.read_text(encoding="utf-8").strip())
        except ValueError as exc:
            # 附带文件路径重新抛出,定位坏样本时不必反查索引。
            raise RuntimeError(f"invalid numeric content: {sample_path}") from exc

        features = torch.tensor([value], dtype=torch.float32)
        if self.transform is not None:
            features = self.transform(features)

        return {
            "features": features,
            "label": torch.tensor(label, dtype=torch.long),
            "sample_id": sample_path.stem,
        }

def main() -> None:
    with tempfile.TemporaryDirectory() as temp_dir:
        root = Path(temp_dir)
        (root / "a.txt").write_text("1.5", encoding="utf-8")
        (root / "b.txt").write_text("2.0", encoding="utf-8")

        manifest = root / "manifest.csv"
        manifest.write_text(
            "file,label\n"
            "a.txt,0\n"
            "b.txt,1\n"
            "missing.txt,2\n",
            encoding="utf-8",
        )

        dataset = NumberDataset(
            root_dir=root,
            manifest_path=manifest,
            transform=lambda tensor: (tensor - 1.5) / 0.5,
        )

        first = dataset[0]
        print("size:", len(dataset))
        print("rejected:", dataset.rejected)
        print("first:", first["features"].tolist(), first["label"].item(), first["sample_id"])

if __name__ == "__main__":
    main()
预期输出:
size: 2
rejected: ['missing.txt: file not found']
first: [0.0] 0 a
输出说明 missing.txt 没有进入有效索引,因此 len(dataset) 只返回 2。第一个样本经过标准化后从 1.5 变为 0.0,标签仍使用适合分类损失函数的 torch.long 类型。
关键边界与错误策略
__getitem__ 应返回结构稳定的对象,例如固定字段的字典、元组或命名结构。不要让同一数据集有时返回两个字段、有时返回三个字段,否则默认批处理逻辑会在运行时失败。
对于可在训练前确认的错误,如文件缺失、标签格式非法和必填字段为空,适合在初始化阶段过滤或直接终止。对于读取时才能发现的错误,如文件损坏,应抛出包含样本路径的异常。静默返回全零张量会掩盖数据问题,并可能让模型学习到错误模式。
预处理也要区分职责:确定性的格式转换可放在 Dataset 中;带随机性的增强可以通过 transform 注入,并配合 DataLoader 的随机种子管理,避免把实验参数写死在数据集内部。
验收检查
运行示例后,应确认有效样本数、拒绝记录和首个样本内容都符合预期。接入真实项目时,还应抽查若干索引的张量形状、数据类型和标签范围,确保它们与模型输入及损失函数一致。
本课总结
Dataset只定义样本数量与单样本读取,不承担批量和并行加载- 明显坏数据应尽早校验,并保留可追踪的拒绝原因
- 返回结构、张量形状和数据类型必须在所有样本间保持一致
下一课预告
下一课将使用 DataLoader 为自定义数据集加入批量、打乱、多进程、固定内存和可复现随机种子配置。