
机器学习与深度学习 / 系统课时
识别欠拟合与过拟合
识别欠拟合与过拟合
本课解决“模型还没学会,还是已经学过头”的判断问题。你将结合训练损失、验证损失和验证指标识别欠拟合、正常拟合与过拟合,并据此决定继续训练、调整模型容量还是加强数据与正则化。
学习目标
- 根据训练曲线与验证曲线判断拟合状态
- 区分模型容量不足、训练不足和数据问题
- 为不同诊断结果选择下一步动作
先看训练集与验证集的差距
训练指标反映模型对已见样本的拟合程度,验证指标反映模型对未参与参数更新的数据的表现。判断时不能只看单个数值,而要同时观察两条曲线的水平、趋势和差距。
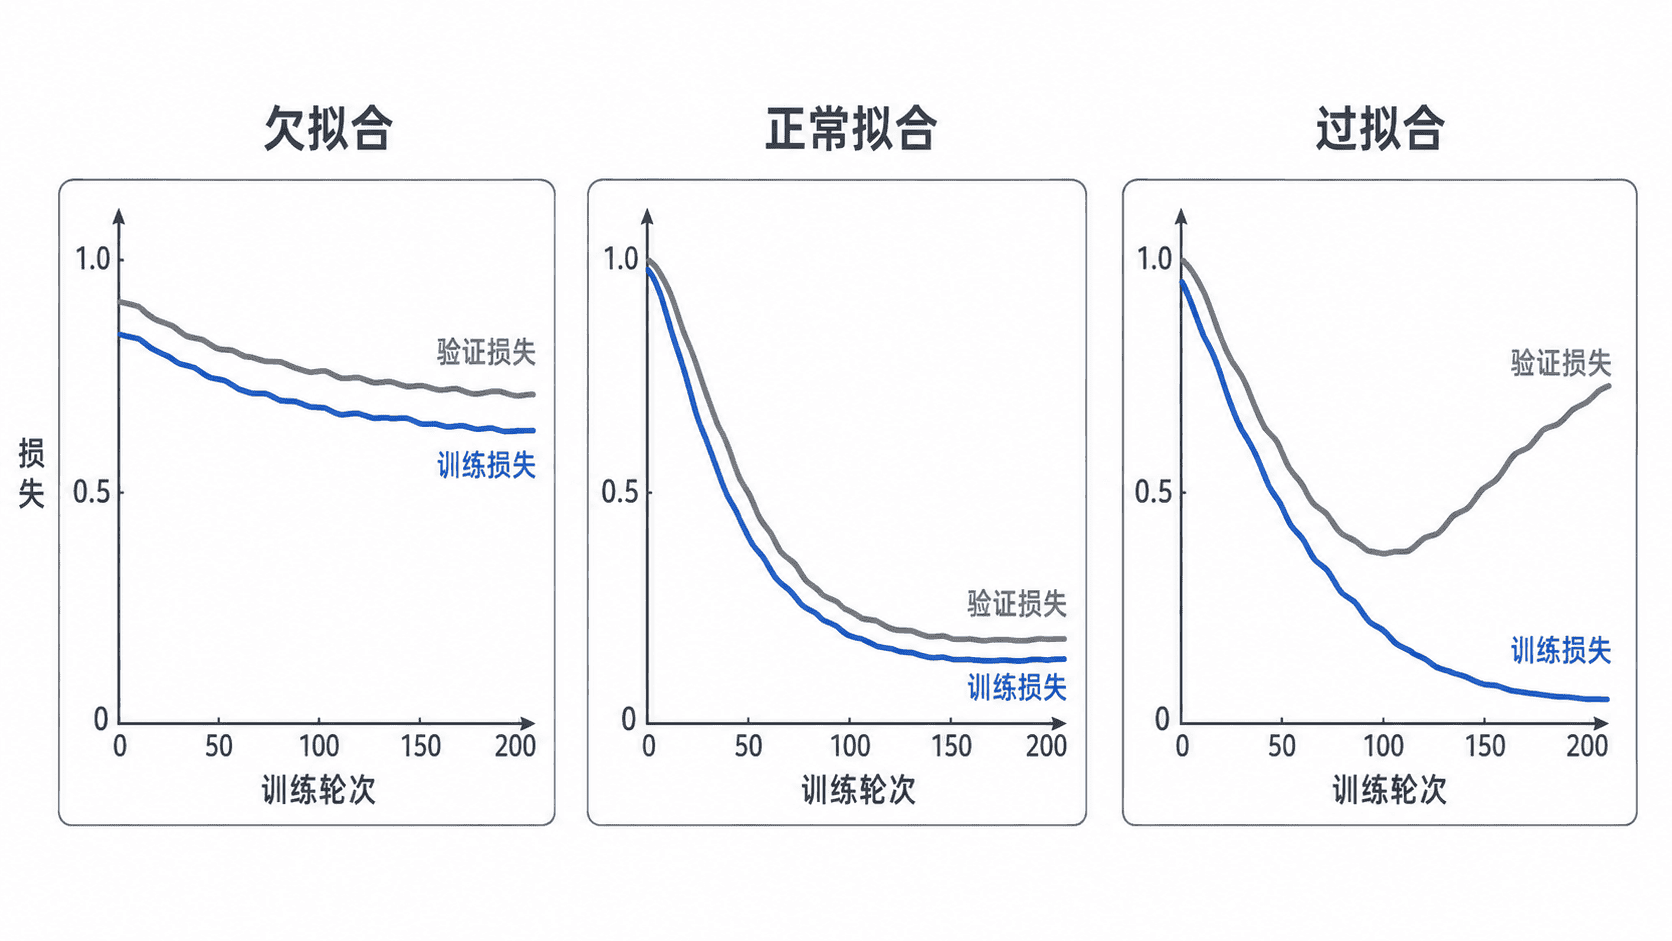
欠拟合通常表现为训练集和验证集都较差,而且两者差距不大。过拟合则表现为训练指标继续改善,但验证指标停滞或恶化,二者差距逐渐扩大。正常拟合并不要求两条曲线完全重合,而是验证表现稳定且差距可接受。
用曲线组合定位问题
| 训练表现 | 验证表现 | 常见判断 | 优先动作 |
|---|---|---|---|
| 差 | 差 | 欠拟合或训练不足 | 增加训练轮次、提高模型容量、检查特征 |
| 好 | 差 | 过拟合 | 早停、正则化、数据增强、增加数据 |
| 好 | 好 | 拟合较合理 | 固定方案并在测试集做最终评估 |
| 波动大 | 波动大 | 优化或数据不稳定 | 检查学习率、批量大小、标签质量 |
“训练表现差”不一定等于模型太小。学习率不合适、输入未归一化、标签错误或训练轮次不足,也会造成类似曲线,因此应先排除训练流程问题,再修改网络结构。
编写一个最小诊断器
下面的程序根据验证损失最低点之后的走势给出初步判断。它适合帮助阅读曲线,不应替代完整实验分析。
python
def diagnose(train_loss: list[float], val_loss: list[float]) -> tuple[str, int]:
    if len(train_loss) != len(val_loss) or not train_loss:
        raise ValueError("两组损失必须非空且长度一致")

    best_index = min(range(len(val_loss)), key=val_loss.__getitem__)

    # 验证损失明显反弹,同时训练损失仍下降,可视为过拟合信号
    if val_loss[-1] > val_loss[best_index] * 1.15 and train_loss[-1] < train_loss[best_index]:
        result = "过拟合"
    elif train_loss[-1] > 0.5 and val_loss[-1] > 0.5:
        result = "可能欠拟合"
    else:
        result = "拟合状态较合理"

    return result, best_index + 1

train = [0.92, 0.68, 0.49, 0.36, 0.28, 0.22]
validation = [0.95, 0.71, 0.55, 0.51, 0.58, 0.69]

status, best_epoch = diagnose(train, validation)
print(f"诊断结果:{status}")
print(f"最佳验证轮次:{best_epoch}")
预期输出:
text
诊断结果:过拟合
最佳验证轮次:4
实际项目中,阈值应根据指标波动和业务容忍度调整。分类任务还要同步观察准确率、F1 或 AUC,因为损失变化与业务指标变化不一定完全一致。
诊断后的处理顺序
发现欠拟合时,先确认训练是否充分、优化器是否正常和输入是否正确,再考虑增加层数、宽度或特征表达能力。直接堆大模型可能掩盖数据与训练流程问题。
发现过拟合时,优先保存验证集表现最好的检查点,并使用早停。之后再按成本从低到高尝试权重衰减、Dropout、数据增强、减少模型容量或补充高质量样本。
训练集与验证集必须保持相同的预处理口径,但验证数据不能参与参数更新、归一化统计量拟合或超参数之外的反复试错。
本课总结
- 欠拟合通常是训练与验证表现都差,过拟合通常是训练继续改善而验证恶化
- 判断应同时观察指标水平、变化趋势和泛化差距
- 修改模型前应先排除训练不足、数据错误和优化不稳定
下一课预告
下一课将设计训练集、验证集和测试集的划分方式,并系统识别样本泄漏、时间泄漏与特征泄漏。
按自己的节奏,确认真正理解。