
机器学习与深度学习 / 系统课时
概率分布与期望
概率分布与期望
深度学习既要描述数据出现的可能性,也要用平均意义上的损失衡量模型表现。本课建立随机变量、概率分布、条件概率、期望与方差之间的联系,并说明它们在分类和回归中的实际作用。
学习目标
- 区分随机变量、概率分布与概率密度
- 理解条件概率、期望和方差的计算含义
- 能把常用分布与分类、回归任务对应起来
随机变量与概率分布
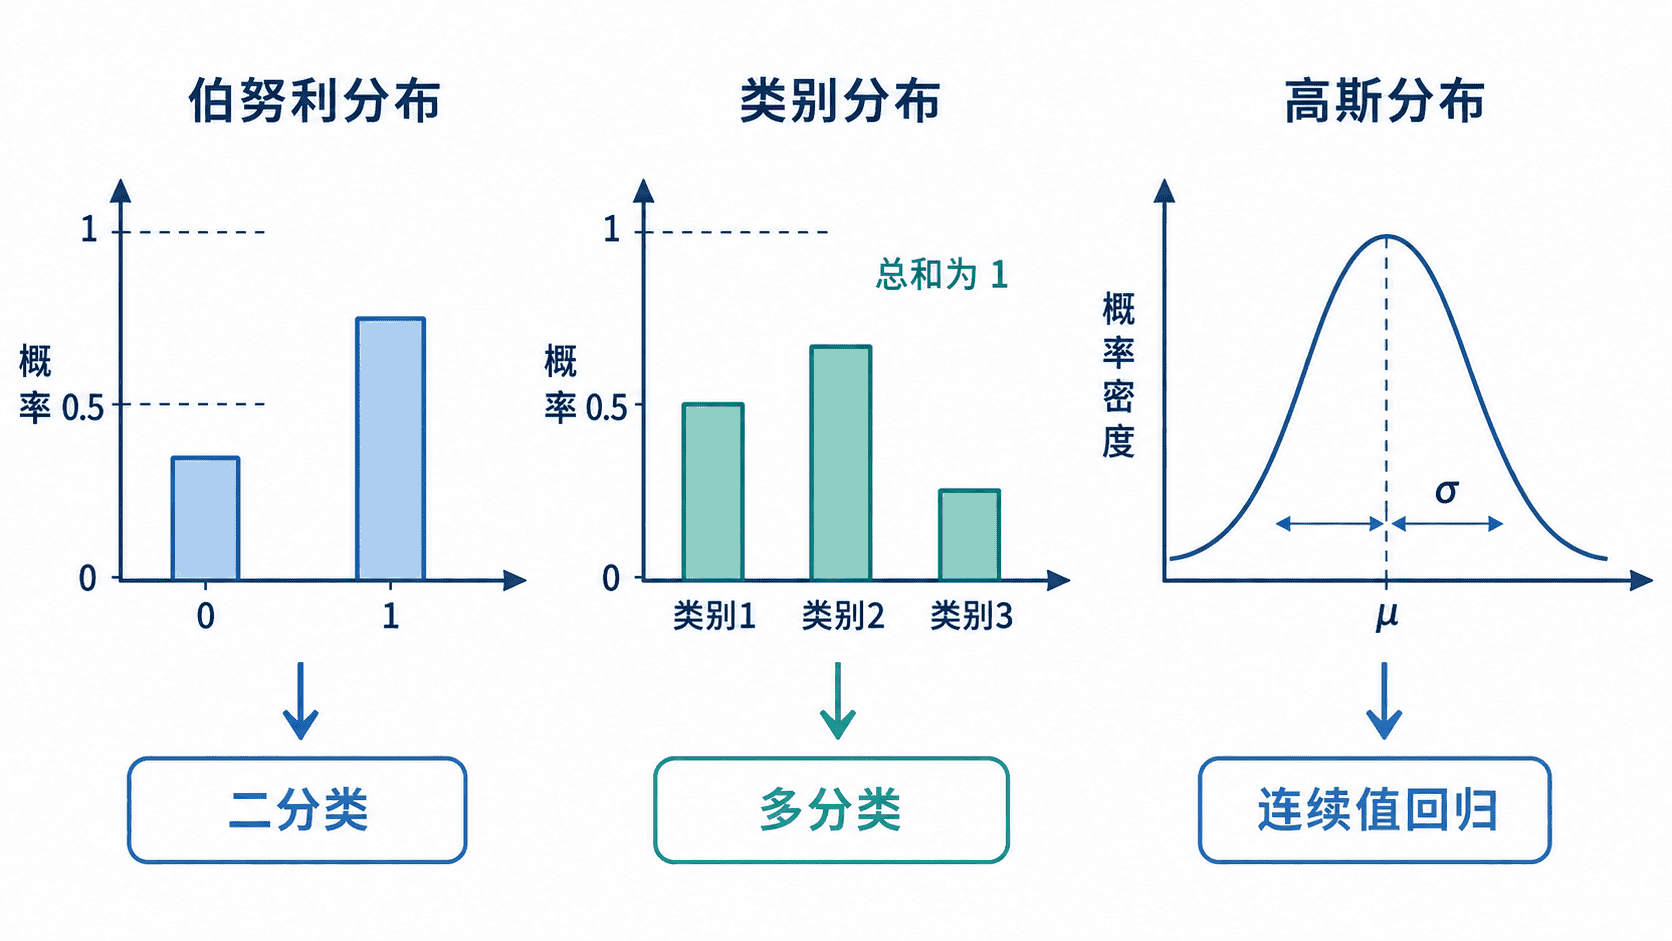
随机变量把随机结果映射为数值,概率分布描述这些数值出现的规律。离散变量使用概率质量函数 ;连续变量使用概率密度函数 ,单点密度不是概率,区间概率需要对密度积分。
常见分布与深度学习任务的关系如下:
| 分布 | 典型变量 | 关键参数 | 常见用途 |
|---|---|---|---|
| 伯努利分布 | 成功或失败 | 成功概率 | 二分类、二值特征 |
| 类别分布 | 多个类别之一 | 各类别概率 | 多分类输出 |
| 高斯分布 | 连续实数 | 均值 、方差 | 回归误差、噪声建模 |
一个合法的离散分布必须满足每个概率非负,且所有可能结果的概率之和为 1。连续分布则要求密度非负,且整个定义域上的积分为 1。
条件概率与贝叶斯关系
条件概率表示在事件 已发生时,事件 发生的概率:
它强调信息会改变概率判断。例如,模型看到输入特征 后预测类别 ,本质上是在估计条件分布 。
由条件概率可得到贝叶斯公式:
其中 是观察数据前的先验, 是似然, 是结合数据后的后验。深度学习中不一定显式计算完整后验,但“根据数据更新对参数或类别的判断”仍建立在这一概率关系上。
期望与方差
期望表示随机变量在大量重复试验中的长期平均值。离散变量的期望为:
连续变量则用积分表示。期望具有线性性质,即使变量不独立,也有 。
方差衡量随机变量围绕均值的波动程度:
以伯努利变量为例,若成功概率 ,则 ,。期望告诉我们平均水平,方差告诉我们结果是否稳定。
它们如何进入深度学习
训练目标通常是最小化数据分布下的期望损失:
真实数据分布未知,因此训练时用有限样本平均近似期望;小批量训练又用当前批次的平均损失近似全数据平均。批次越小,梯度估计通常波动越大,但计算更灵活。
不同输出假设会导出不同损失。伯努利分布对应二元交叉熵,类别分布对应多类交叉熵;若回归误差服从固定方差的高斯分布,最大似然估计会得到均方误差。这说明损失函数不是随意选择,而是隐含了对数据分布的假设。
容易混淆的边界
概率与概率密度不是同一概念。连续变量在某个精确点取值的概率通常为 0,但该点的密度可以大于 0;只有区间下的面积才表示概率。
期望也不要求一定是某个可实际取得的值。例如公平六面骰子的期望是 ,但单次结果不可能为 。它描述的是长期平均,而不是一次预测。
方差有量纲平方,不便直接与原变量比较,因此常使用标准差 。标准差与原变量单位一致,更适合解释波动范围。
本课总结
- 概率分布描述随机变量的取值规律,离散变量用概率,连续变量用密度
- 条件概率刻画已有信息下的判断,期望与方差分别描述平均水平和波动程度
- 常见损失函数对应特定概率假设,训练中的样本平均是在近似期望风险
下一课预告
下一课将把这些概率概念连接到似然、交叉熵与常见损失函数,进一步理解模型为什么要最小化特定目标。