
机器学习与深度学习 / 系统课时
模型训练的完整流程
模型训练的完整流程
本课把一次模型训练拆成可执行的闭环:数据进入模型得到预测,损失函数衡量偏差,反向传播计算梯度,优化器再更新参数。学完后,你能看懂训练日志,也能用最小代码验证每一步是否真正发生。
学习目标
- 说明数据准备、前向计算、损失评估、反向传播和参数更新的职责
- 理解梯度如何把预测误差传回各层参数
- 运行一个最小训练循环,并根据损失变化判断训练是否有效
训练闭环解决什么问题
模型开始时通常只有随机参数,无法直接给出可靠结果。训练的本质,是反复比较“当前预测”和“真实答案”,再沿着能降低误差的方向微调参数。一次完整迭代通常处理一个批次数据,多个批次组成一个训练轮次,也就是一个 epoch。
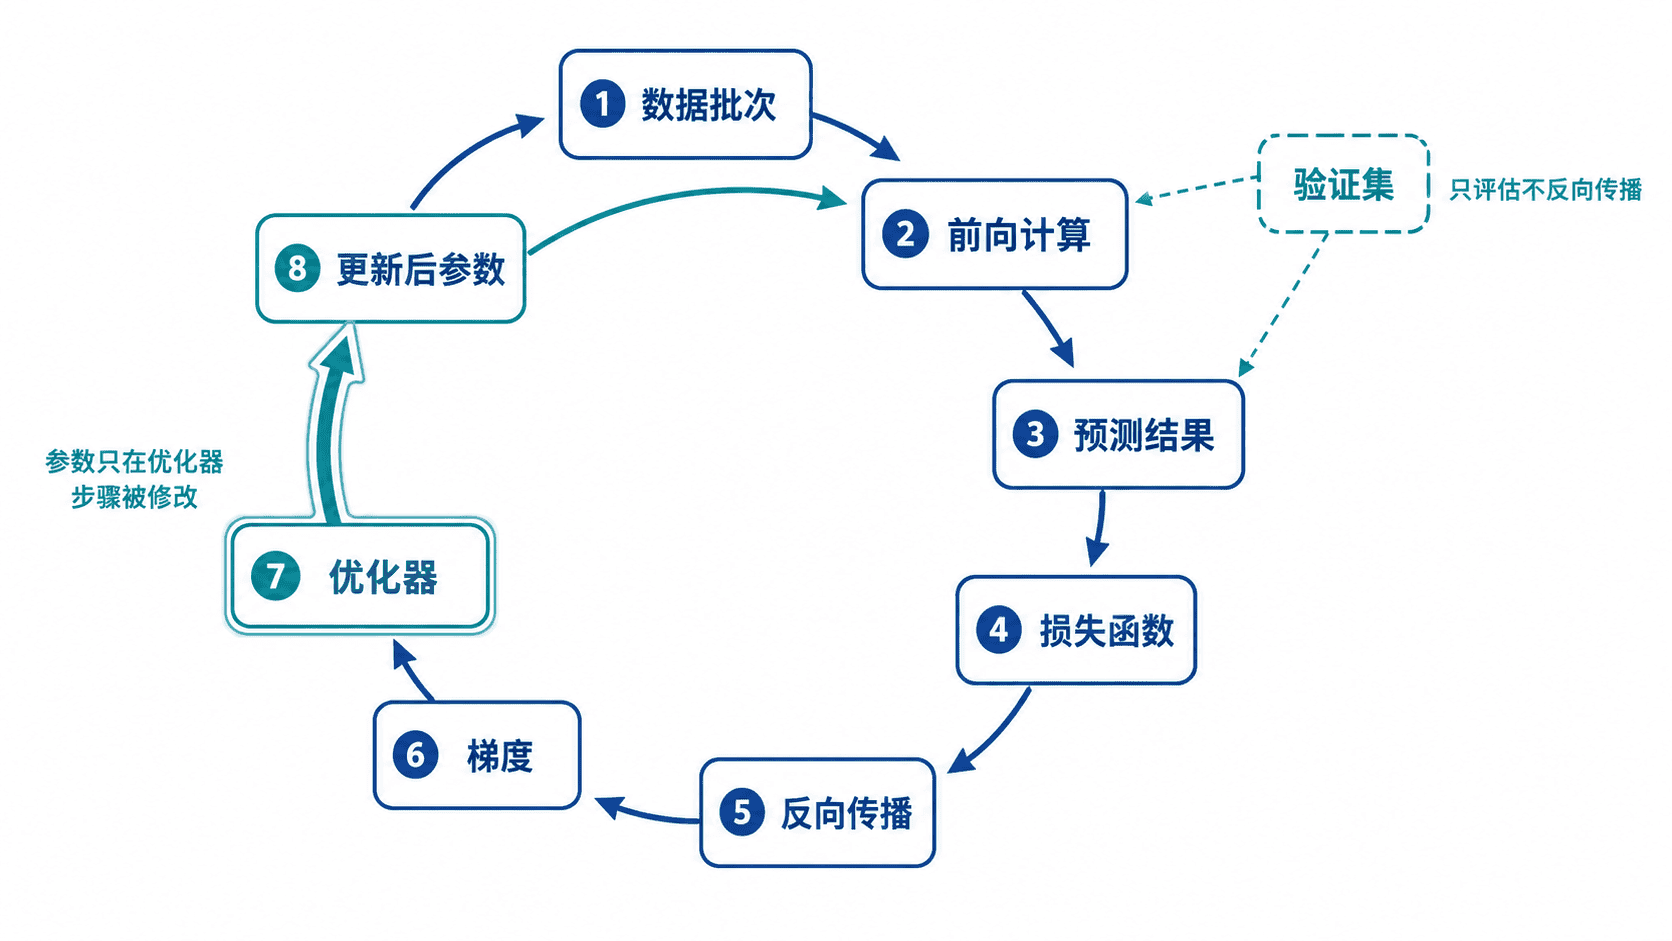
图中的箭头不是一次性流水线,而是循环。只要还没有达到停止条件,模型就会继续读取批次、计算梯度并更新参数;验证阶段则关闭参数更新,用未参与训练的数据检查泛化能力。
五个关键阶段
- 数据准备:清洗样本、划分训练集与验证集,并把样本组织成批次。输入尺度、标签编码和样本分布都会直接影响训练稳定性。
- 前向计算:模型按当前参数逐层计算,得到预测值。此时只产生结果和中间状态,不修改参数。
- 损失评估:损失函数把预测与真实标签的差异压缩成一个可优化的数值。损失越小,表示当前批次上的预测通常越接近目标。
- 反向传播:从损失出发,依据链式法则计算每个可训练参数的梯度。梯度描述参数稍微变化时,损失会向哪个方向变化。
- 参数更新:优化器根据梯度和学习率修改参数。学习率过大可能震荡,过小则收敛缓慢。
用最小示例跑通闭环
下面用纯 Python 训练线性模型 prediction = w * x + b,目标数据满足 y = 2 * x + 1。代码包含前向计算、均方误差、梯度计算和参数更新,不依赖深度学习框架。
python
x = [1.0, 2.0, 3.0, 4.0]
y = [3.0, 5.0, 7.0, 9.0]
w, b = 0.0, 0.0
learning_rate = 0.05

def mean_squared_error(weight, bias):
    predictions = [weight * value + bias for value in x]
    return sum((pred - target) ** 2 for pred, target in zip(predictions, y)) / len(x)

print(f"initial_loss={mean_squared_error(w, b):.1f}")

for _ in range(200):
    predictions = [w * value + b for value in x]
    # 梯度表示损失对参数变化的敏感程度
    grad_w = sum(2 * (pred - target) * value for pred, target, value in zip(predictions, y, x)) / len(x)
    grad_b = sum(2 * (pred - target) for pred, target in zip(predictions, y)) / len(x)
    # 参数沿梯度反方向移动,使当前损失逐步下降
    w -= learning_rate * grad_w
    b -= learning_rate * grad_b

print(f"w={w:.4f}, b={b:.4f}")
print(f"final_loss={mean_squared_error(w, b):.6f}")
预期输出:
text
initial_loss=41.0
w=2.0048, b=0.9860
final_loss=0.000033
最终参数接近 w=2、b=1,损失也从 41.0 降到接近零,说明闭环确实在学习。真实神经网络只是参数更多、计算图更复杂,但训练顺序并没有改变。
训练集、验证集与测试集
| 数据集合 | 是否更新参数 | 主要用途 |
|---|---|---|
| 训练集 | 是 | 计算梯度并学习参数 |
| 验证集 | 否 | 选择超参数、发现过拟合、决定何时停止 |
| 测试集 | 否 | 在方案确定后评估最终泛化表现 |
不要用测试集反复调参,否则测试结果会逐渐变成“参与训练的反馈”,失去客观评估价值。
常见异常的检查顺序
当损失不下降时,先确认输入和标签是否对齐,再检查损失函数是否适合任务,随后观察梯度是否为零、无穷大或非数值。最后再调整学习率、批次大小和模型容量。这个顺序能避免在数据错误尚未排除时盲目更换网络。
如果训练损失持续下降而验证损失上升,通常意味着过拟合。可以增加数据、使用正则化、降低模型复杂度,或依据验证损失执行提前停止。
本课总结
- 模型训练是“前向预测、计算损失、反向求梯度、优化器更新参数”的重复闭环
- 反向传播负责计算梯度,优化器才真正修改参数,两者职责不同
- 训练是否有效要同时观察训练损失和验证表现,不能只看单个批次的结果
下一课预告
下一课将建立常见网络架构地图,比较多层感知机、卷积网络、循环网络、Transformer 与生成模型分别适合处理什么数据和任务。
按自己的节奏,确认真正理解。