
机器学习与深度学习 / 系统课时
认识 PyTorch 项目结构
认识 PyTorch 项目结构
本课将把训练代码拆分为可维护的项目目录,说明配置、数据、模型、日志和权重文件之间如何协作。完成后,你能够从空目录搭建最小骨架,并判断一个文件应该进入源码、数据区还是运行产物区。
学习目标
- 识别 PyTorch 项目中常见目录与文件职责
- 理解训练脚本、配置、数据和输出产物的协作顺序
- 搭建一个可继续扩展的最小项目骨架
先看完整目录
下面是一套适合入门项目的结构。它不是唯一标准,但已经把可维护项目最重要的边界分开:源码可以复用,配置可以切换,数据不会混入代码,运行产物也不会污染源码目录。
deep-learning-project/
├── configs/
│   └── train.yaml
├── data/
│   ├── raw/
│   └── processed/
├── src/
│   ├── data/
│   ├── models/
│   └── utils/
├── scripts/
├── tests/
├── outputs/
│   ├── logs/
│   └── checkpoints/
├── train.py
├── evaluate.py
├── requirements.txt
├── .gitignore
└── README.md
根目录只保留项目入口和说明文件,具体实现放入 src。outputs 存放每次运行生成的内容,删除后不应影响源码本身。
各部分应该放什么
| 位置 | 主要职责 | 不建议放入 |
|---|---|---|
configs/ |
学习率、批大小、轮数、路径等可切换参数 | 训练循环实现 |
data/raw/ |
原始、未经修改的数据 | 模型权重和日志 |
data/processed/ |
清洗、切分或转换后的数据 | 临时代码 |
src/data/ |
数据集类、采样器、预处理逻辑 | 大体积数据文件 |
src/models/ |
网络结构与模型组件 | 训练日志 |
outputs/logs/ |
损失、指标、事件日志 | 需要版本控制的源码 |
outputs/checkpoints/ |
阶段权重和最佳权重 | 原始数据 |
train.py 负责组装配置、数据、模型、优化器和训练循环;evaluate.py 负责加载指定权重并计算验证或测试指标。二者应调用 src 中的模块,而不是各自复制一份相同实现。
训练时如何协作
一次训练通常按照“读取配置、准备数据、创建模型、执行训练、保存产物”的顺序运行。配置决定本次实验参数,数据模块负责产生批次,模型完成前向计算,训练入口协调反向传播,最后把日志和权重写入输出目录。
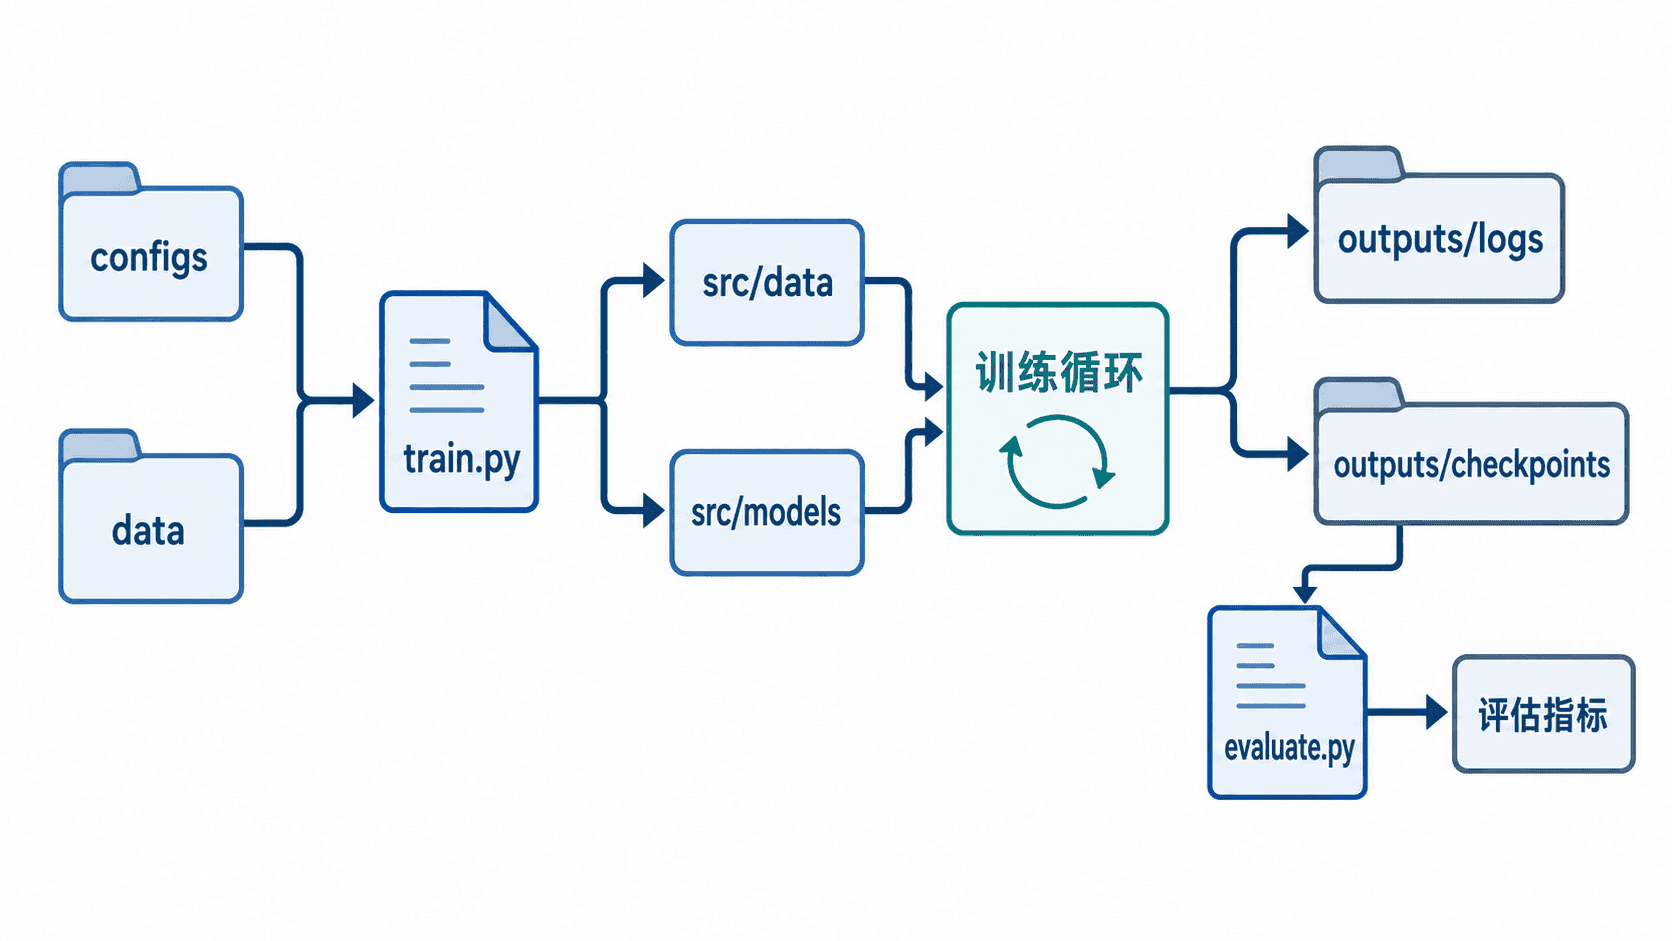
这张关系图的关键不是目录名称,而是依赖方向:配置和数据被读取,源码被调用,日志与权重被写出。运行产物不应反向成为源码的隐式依赖,否则项目会难以复现。
创建最小项目骨架
下面的脚本会创建目录和空文件,但不会覆盖已有文件。将它保存为 init_project.py,在准备放置项目的目录中执行 python init_project.py。
from pathlib import Path

def main() -> None:
    root = Path("deep-learning-project")
    directories = [
        "configs",
        "data/raw",
        "data/processed",
        "src/data",
        "src/models",
        "src/utils",
        "scripts",
        "tests",
        "outputs/logs",
        "outputs/checkpoints",
    ]
    files = [
        "configs/train.yaml",
        "src/__init__.py",
        "src/data/__init__.py",
        "src/models/__init__.py",
        "src/utils/__init__.py",
        "train.py",
        "evaluate.py",
        "requirements.txt",
        ".gitignore",
        "README.md",
    ]

    # 先创建目录,再创建文件,保证父路径始终存在
    for relative_path in directories:
        (root / relative_path).mkdir(parents=True, exist_ok=True)

    for relative_path in files:
        file_path = root / relative_path
        file_path.parent.mkdir(parents=True, exist_ok=True)
        file_path.touch(exist_ok=True)

    print(f"project_root={root}")
    print(f"directories={len(directories)}")
    print(f"files={len(files)}")

if __name__ == "__main__":
    main()
预期输出
project_root=deep-learning-project
directories=10
files=10
进入新目录后,应能看到与前文一致的核心骨架。空文件只是起点,后续再逐步填入数据集、模型和训练逻辑。
用配置隔离实验参数
把经常变化的训练参数放入 configs/train.yaml,避免每次实验都修改 Python 源码。下面是片段示例,依赖后续课程实现的 YAML 读取逻辑。
seed: 42

data:
  train_dir: data/processed/train
  validation_dir: data/processed/validation

model:
  name: simple_cnn
  num_classes: 10

training:
  epochs: 10
  batch_size: 64
  learning_rate: 0.001

outputs:
  log_dir: outputs/logs
  checkpoint_dir: outputs/checkpoints
这份配置生效后,训练入口应从 training 读取轮数、批大小和学习率,从 outputs 获取日志与权重目录。验证时可以临时修改 epochs,确认训练脚本读取到新值,而不改动模型源码。
防止目录逐渐失控
不要把所有逻辑都写进 train.py。当数据处理、模型定义或评估逻辑超过一个清晰职责时,就移动到 src 对应模块中,让入口文件只负责组装和调度。
原始数据、日志和权重通常体积较大,应通过 .gitignore 排除;配置、源码、测试和说明文档则应进入版本控制。保存权重时使用包含实验名、轮次或指标的文件名,避免反复覆盖唯一的 model.pt。
本课总结
- 项目结构的核心是分离源码、配置、数据和运行产物,而不是机械复制固定目录
train.py负责组装流程,具体数据与模型实现应沉入src复用- 日志和权重必须有明确输出位置,才能支持复现、评估和继续训练
下一课预告
下一课将进入张量基础,学习如何创建张量、理解形状与数据类型,并完成设备之间的数据迁移。