
机器学习与深度学习 / 系统课时
配置驱动训练
配置驱动训练
当数据路径、模型结构和训练超参数散落在代码里时,实验很难复现,也容易因参数拼写或取值错误而浪费计算资源。本课将把这些设置集中到 YAML 文件中,完成加载、校验、对象构建和运行验证,形成可复用的配置驱动训练入口。
学习目标
- 能把数据、模型和训练参数从 Python 代码中分离出来
- 能在训练开始前校验必填项、类型和取值范围
- 能根据配置构建数据、模型、优化器与训练循环
配置驱动训练解决什么问题
配置驱动并不是简单地把变量搬到文件里,而是建立一条稳定链路:配置文件描述实验,加载器解析内容,校验器阻止非法参数,构建器再创建训练对象。这样,同一份代码可以运行多组实验,差异只体现在配置文件和输出目录中。
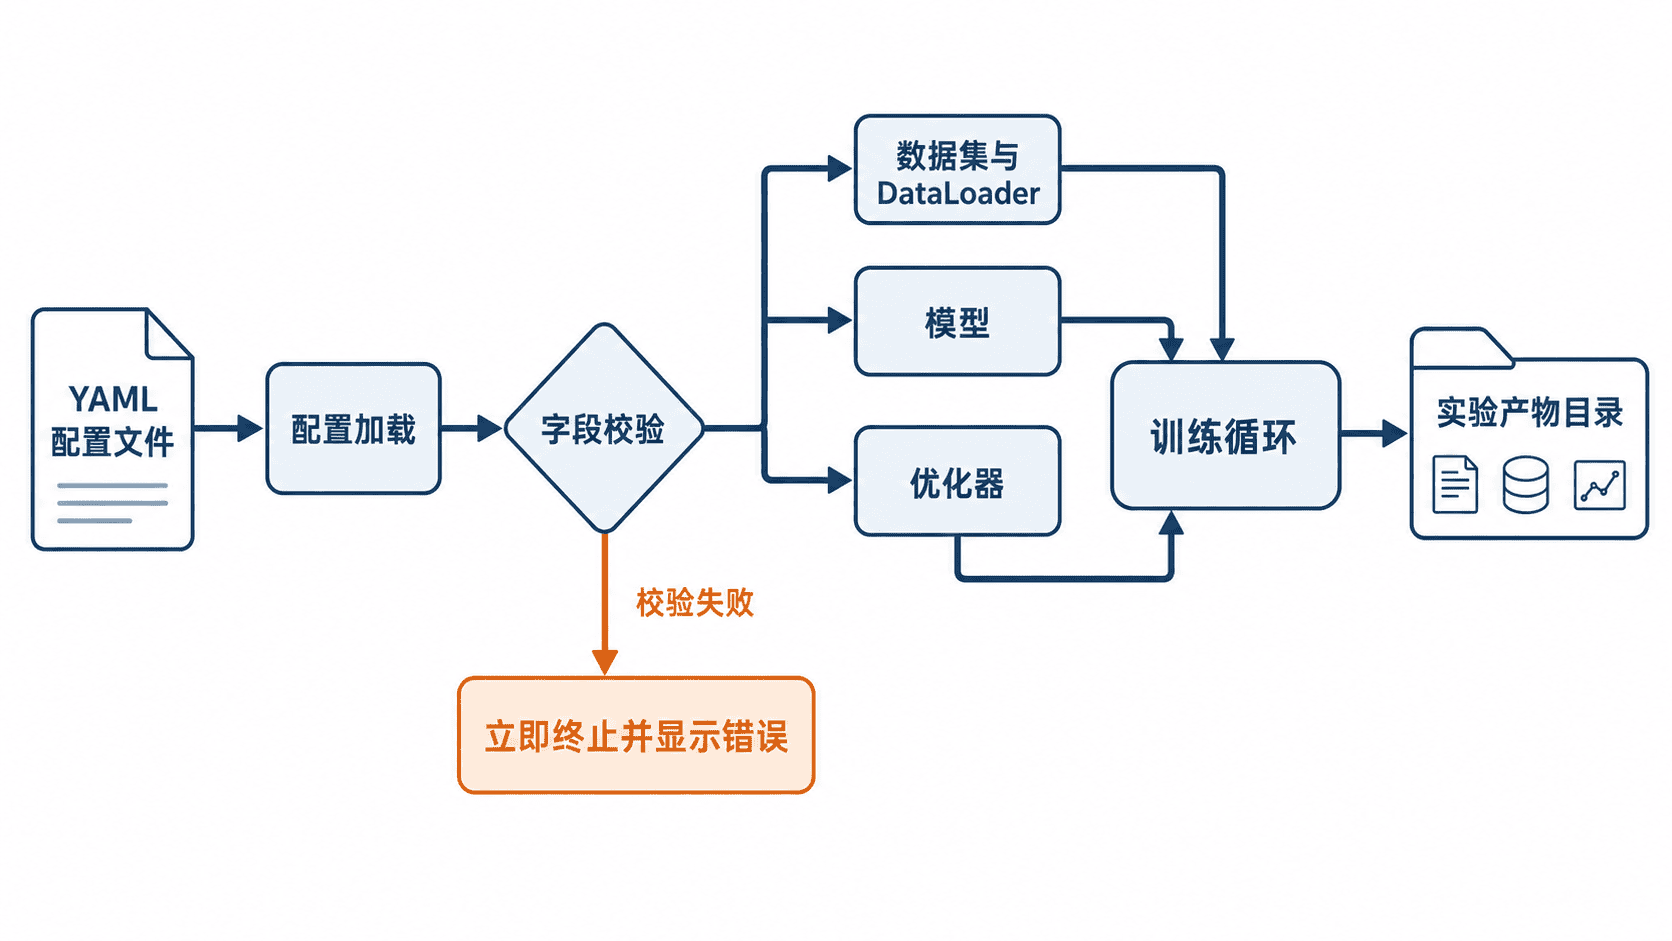
核心收益有三点:减少代码修改、提高实验可追溯性、让错误尽早暴露。配置文件本身仍然需要版本管理,否则参数虽然被分离,却依旧无法还原历史实验。
设计可校验的配置文件
下面的 config.yaml 同时描述数据规模、模型结构和训练参数。字段名应稳定、层级应清晰,数值最好使用明确单位,例如学习率直接使用小数,训练轮数使用整数。
seed: 42

data:
  num_samples: 512
  input_dim: 8
  batch_size: 64

model:
  hidden_dim: 16
  num_classes: 2

training:
  epochs: 3
  learning_rate: 0.01
  output_dir: runs/config-demo
这份配置的生效行为是:程序创建 512 条 8 维样本,使用隐藏层宽度为 16 的两分类模型训练 3 轮,并把配置快照保存到 runs/config-demo。验证时应确认目录被创建,且启动日志中的参数与文件一致。
加载、校验并构建训练对象
下面是完整的 train.py。示例使用 PyYAML 解析配置,手动校验关键字段,再根据配置创建合成数据、模型和优化器。真实项目可以继续把校验逻辑升级为 Pydantic 或 dataclass 方案,但“先校验、后分配训练资源”的顺序不应改变。
import argparse
import json
from pathlib import Path
from typing import Any

import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset
import yaml

def require_positive_int(config: dict[str, Any], path: tuple[str, ...]) -> int:
    value: Any = config
    for key in path:
        if not isinstance(value, dict) or key not in value:
            raise ValueError(f"missing config field: {'.'.join(path)}")
        value = value[key]
    if not isinstance(value, int) or value <= 0:
        raise ValueError(f"{'.'.join(path)} must be a positive integer")
    return value

def load_and_validate(path: Path) -> dict[str, Any]:
    with path.open("r", encoding="utf-8") as file:
        config = yaml.safe_load(file)

    if not isinstance(config, dict):
        raise ValueError("root config must be a mapping")

    # 在创建模型和数据之前完成结构与范围检查,避免非法实验占用资源。
    require_positive_int(config, ("data", "num_samples"))
    require_positive_int(config, ("data", "input_dim"))
    require_positive_int(config, ("data", "batch_size"))
    require_positive_int(config, ("model", "hidden_dim"))
    require_positive_int(config, ("model", "num_classes"))
    require_positive_int(config, ("training", "epochs"))

    learning_rate = config.get("training", {}).get("learning_rate")
    if not isinstance(learning_rate, (int, float)) or learning_rate <= 0:
        raise ValueError("training.learning_rate must be greater than 0")

    output_dir = config.get("training", {}).get("output_dir")
    if not isinstance(output_dir, str) or not output_dir.strip():
        raise ValueError("training.output_dir must be a non-empty string")

    return config

def build_dataset(config: dict[str, Any]) -> TensorDataset:
    sample_count = config["data"]["num_samples"]
    input_dim = config["data"]["input_dim"]
    features = torch.randn(sample_count, input_dim)

    # 用前两维的线性关系生成标签,使示例可以稳定完成二分类训练。
    labels = (features[:, 0] + 0.6 * features[:, 1] > 0).long()
    return TensorDataset(features, labels)

def build_model(config: dict[str, Any]) -> nn.Module:
    return nn.Sequential(
        nn.Linear(config["data"]["input_dim"], config["model"]["hidden_dim"]),
        nn.ReLU(),
        nn.Linear(config["model"]["hidden_dim"], config["model"]["num_classes"]),
    )

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--config", type=Path, required=True)
    args = parser.parse_args()

    config = load_and_validate(args.config)
    torch.manual_seed(config.get("seed", 42))

    # 保存解析后的配置快照,而不是依赖可能继续变化的原始文件。
    output_dir = Path(config["training"]["output_dir"])
    output_dir.mkdir(parents=True, exist_ok=True)
    (output_dir / "resolved-config.json").write_text(
        json.dumps(config, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )

    # 只有校验通过后,才创建数据、模型和优化器等训练对象。
    dataset = build_dataset(config)
    loader = DataLoader(
        dataset,
        batch_size=config["data"]["batch_size"],
        shuffle=True,
    )
    model = build_model(config)
    optimizer = torch.optim.SGD(
        model.parameters(),
        lr=float(config["training"]["learning_rate"]),
    )
    criterion = nn.CrossEntropyLoss()

    print("config validation passed")
    for epoch in range(1, config["training"]["epochs"] + 1):
        total_loss = 0.0
        for features, labels in loader:
            optimizer.zero_grad()
            loss = criterion(model(features), labels)
            loss.backward()
            optimizer.step()
            total_loss += loss.item() * features.size(0)

        # 按样本数计算整轮平均损失,避免最后一个小批次造成偏差。
        average_loss = total_loss / len(dataset)
        current_lr = optimizer.param_groups[0]["lr"]
        print(f"epoch={epoch} loss={average_loss:.4f} lr={current_lr:.6f}")

    print(f"saved_config={output_dir / 'resolved-config.json'}")

if __name__ == "__main__":
    main()
这段代码是完整示例,依赖 Python、PyTorch 和 PyYAML。它没有把环境设备、数据路径等写死在函数内部,后续增加 GPU、真实数据集或更多模型参数时,只需扩展配置结构和校验规则。
运行并验证结果
安装依赖:
python -m pip install torch pyyaml预期结果:
Successfully installed <PACKAGE_LIST><PACKAGE_LIST> 会随当前环境和已安装依赖而变化。随后把 config.yaml 与 train.py 放在同一目录并运行:
python train.py --config config.yaml预期输出:
config validation passed
epoch=1 loss=<LOSS> lr=0.010000
epoch=2 loss=<LOSS> lr=0.010000
epoch=3 loss=<LOSS> lr=0.010000
saved_config=runs/config-demo/resolved-config.json
<LOSS> 会受 PyTorch 版本和硬件实现影响,但通常应逐步下降。还要检查 resolved-config.json 是否存在;它是本次运行实际采用参数的快照,能避免“配置文件后来被修改,历史实验却无法还原”的问题。
校验边界与常见错误
配置值通过语法解析,不代表它在业务上有效。epochs: 0、负学习率、空输出目录都应在训练前直接报错。对于布尔值、枚举值和路径,还要防止 YAML 自动类型转换、大小写不一致和相对路径基准不明确。
不要在配置中保存密码、访问密钥或数据库口令。配置文件适合描述实验,不适合承载敏感信息;敏感值应从环境变量或密钥管理服务读取,并在保存配置快照时做脱敏。
本课总结
- 配置驱动训练的关键链路是“解析、校验、构建、运行、保存快照”
- 校验必须发生在创建数据、模型和加速资源之前
- 可复现不仅依赖代码,也依赖实际生效配置被持久化
下一课预告
下一课将把损失、学习率、评估指标和资源使用统一记录下来,并生成能够跨实验比较的训练曲线。