
机器学习与深度学习 / 系统课时
位置编码与掩码
位置编码与掩码
Transformer 的自注意力本身不认识先后顺序,也不会自动忽略补齐位置或未来位置。本课将构造位置编码、填充掩码和因果掩码,并说明它们分别作用于输入、注意力分数和训练目标的哪个环节。
学习目标
- 解释为什么注意力模型需要显式注入位置信息。
- 区分填充掩码与因果掩码解决的问题。
- 生成可直接用于注意力计算的位置编码和布尔掩码。
位置编码如何补充顺序信息
自注意力根据内容相似度建立关系。如果只交换两个 token 的位置而不改变内容集合,注意力计算本身无法稳定区分“谁在前、谁在后”。因此,模型通常把位置向量与词向量相加:
位置编码可以是可学习参数,也可以使用固定的正弦与余弦函数。固定编码让不同位置具有连续且可比较的模式,不增加需要训练的位置参数。相加后的形状仍为 [B, L, d_model],因此不会改变后续注意力层的接口。
两类掩码分别解决什么
填充掩码用于变长序列。批处理通常把短序列补到统一长度,补齐位置不应成为其他 token 可以关注的键,因此需要把这些位置屏蔽。
因果掩码用于自回归生成。位置 只能关注当前位置及其之前的位置,不能读取 之后的内容。它通常表现为一个上三角屏蔽矩阵。
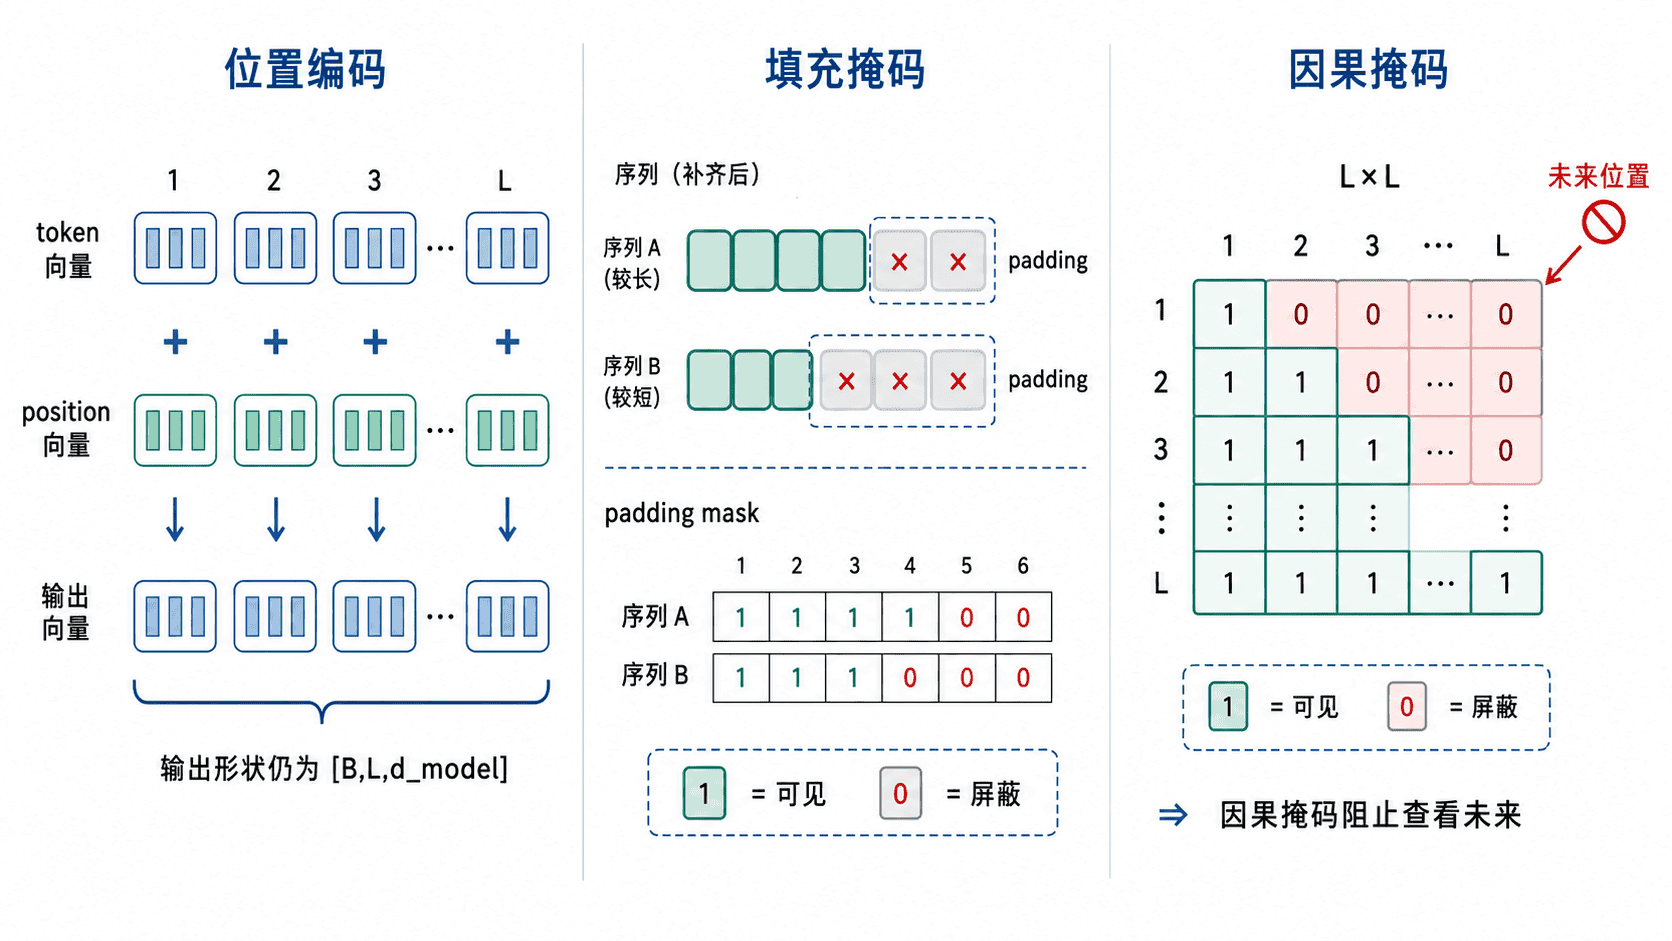
两种掩码可以同时存在。对解码器而言,因果掩码负责限制时间方向,填充掩码负责屏蔽无效键位置。它们通常在注意力分数进入 softmax 之前生效,使被屏蔽位置不再获得有效权重。
可运行示例:生成编码与掩码
下面的程序生成固定正弦位置编码,并为两个长度不同的序列创建填充掩码、因果掩码和组合掩码。示例中 1 表示该位置需要屏蔽。
import math
import torch


def sinusoidal_position_encoding(seq_len: int, d_model: int) -> torch.Tensor:
    if d_model % 2 != 0:
        raise ValueError("d_model must be even")

    positions = torch.arange(seq_len, dtype=torch.float32).unsqueeze(1)
    frequencies = torch.exp(
        torch.arange(0, d_model, 2, dtype=torch.float32)
        * (-math.log(10000.0) / d_model)
    )

    encoding = torch.zeros(seq_len, d_model)
    encoding[:, 0::2] = torch.sin(positions * frequencies)
    encoding[:, 1::2] = torch.cos(positions * frequencies)
    return encoding


def main() -> None:
    seq_len = 5
    d_model = 8
    lengths = torch.tensor([3, 5])

    position_encoding = sinusoidal_position_encoding(seq_len, d_model)

    # True 表示对应键位置是补齐内容,应被屏蔽。
    padding_mask = torch.arange(seq_len).unsqueeze(0) >= lengths.unsqueeze(1)

    # 上三角区域代表未来位置,当前查询不能访问。
    causal_mask = torch.triu(
        torch.ones(seq_len, seq_len, dtype=torch.bool),
        diagonal=1,
    )

    combined_mask = causal_mask.unsqueeze(0) | padding_mask.unsqueeze(1)

    print("position_encoding:", tuple(position_encoding.shape))
    print("padding_mask:")
    print(padding_mask.int())
    print("causal_mask:")
    print(causal_mask.int())
    print("combined_mask[0]:")
    print(combined_mask[0].int())


if __name__ == "__main__":
    main()
预期输出:
position_encoding: (5, 8)
padding_mask:
tensor([[0, 0, 0, 1, 1],
        [0, 0, 0, 0, 0]], dtype=torch.int32)
causal_mask:
tensor([[0, 1, 1, 1, 1],
        [0, 0, 1, 1, 1],
        [0, 0, 0, 1, 1],
        [0, 0, 0, 0, 1],
        [0, 0, 0, 0, 0]], dtype=torch.int32)
combined_mask[0]:
tensor([[0, 1, 1, 1, 1],
        [0, 0, 1, 1, 1],
        [0, 0, 0, 1, 1],
        [0, 0, 0, 1, 1],
        [0, 0, 0, 1, 1]], dtype=torch.int32)
padding_mask 的形状是 [B,L],causal_mask 的形状是 [L,L]。通过增加维度后执行逻辑或,得到的组合掩码形状为 [B,L,L],可以为每个样本、每个查询位置指定不可访问的键位置。
使用时的关键边界
位置编码与输入相加时,二者的最后一维必须相同。批量输入通常是 [B,L,d_model],位置编码可以保持 [L,d_model],依靠广播应用到整个批量。
不同注意力 API 对布尔值、浮点值和掩码维度的约定可能不同。接入具体接口前,应确认 True 是“保留”还是“屏蔽”,以及掩码作用在查询位置、键位置还是两者。示例采用 True 表示屏蔽的约定。
填充掩码只阻止其他位置读取补齐键,并不自动消除补齐查询位置产生的输出。训练时还需要在损失函数中忽略补齐标签,或在后续步骤中清理这些位置。
本课总结
- 位置编码把顺序信息加入 token 表示,但不改变输入张量的总体形状。
- 填充掩码屏蔽无效补齐位置,因果掩码阻止当前位置读取未来信息。
- 两类掩码可以组合,但必须核对具体注意力 API 的布尔语义和形状要求。
下一课预告
下一课将把多头注意力、残差连接、归一化和前馈网络组合起来,完整理解 Transformer 编码器层的数据流。