
机器学习与深度学习 / 系统课时
推理性能优化
推理性能优化
本课将把“模型跑得动”转化为可量化的优化流程:先建立稳定基线,再识别延迟、吞吐与并发瓶颈,最后评估批处理、量化和硬件加速是否真正带来收益。
学习目标
- 区分延迟、吞吐、并发与资源利用率,并选择合适的统计口径。
- 编写可复现的基准测试,识别预热、批量和并发带来的影响。
- 按精度、成本和收益评估量化及硬件加速方案。
性能指标与瓶颈
单次推理延迟描述一个请求从进入到返回所需的时间。不要只看平均值,应至少记录 P50、P95 和 P99;尾延迟通常更能暴露排队、内存抖动、动态形状和冷启动问题。
吞吐量表示单位时间完成的请求数或样本数。并发是同时在处理的请求数量,它本身不是性能结果。并发提高后,吞吐可能上升,但排队也可能让 P95 急剧恶化,因此必须同时观察两者。
资源侧至少记录 CPU、GPU、显存、内存、数据拷贝和设备利用率。GPU 利用率低而 CPU 满载,常见原因是预处理或数据搬运成为瓶颈;显存接近上限且延迟抖动,则要检查批量大小和内存复用。
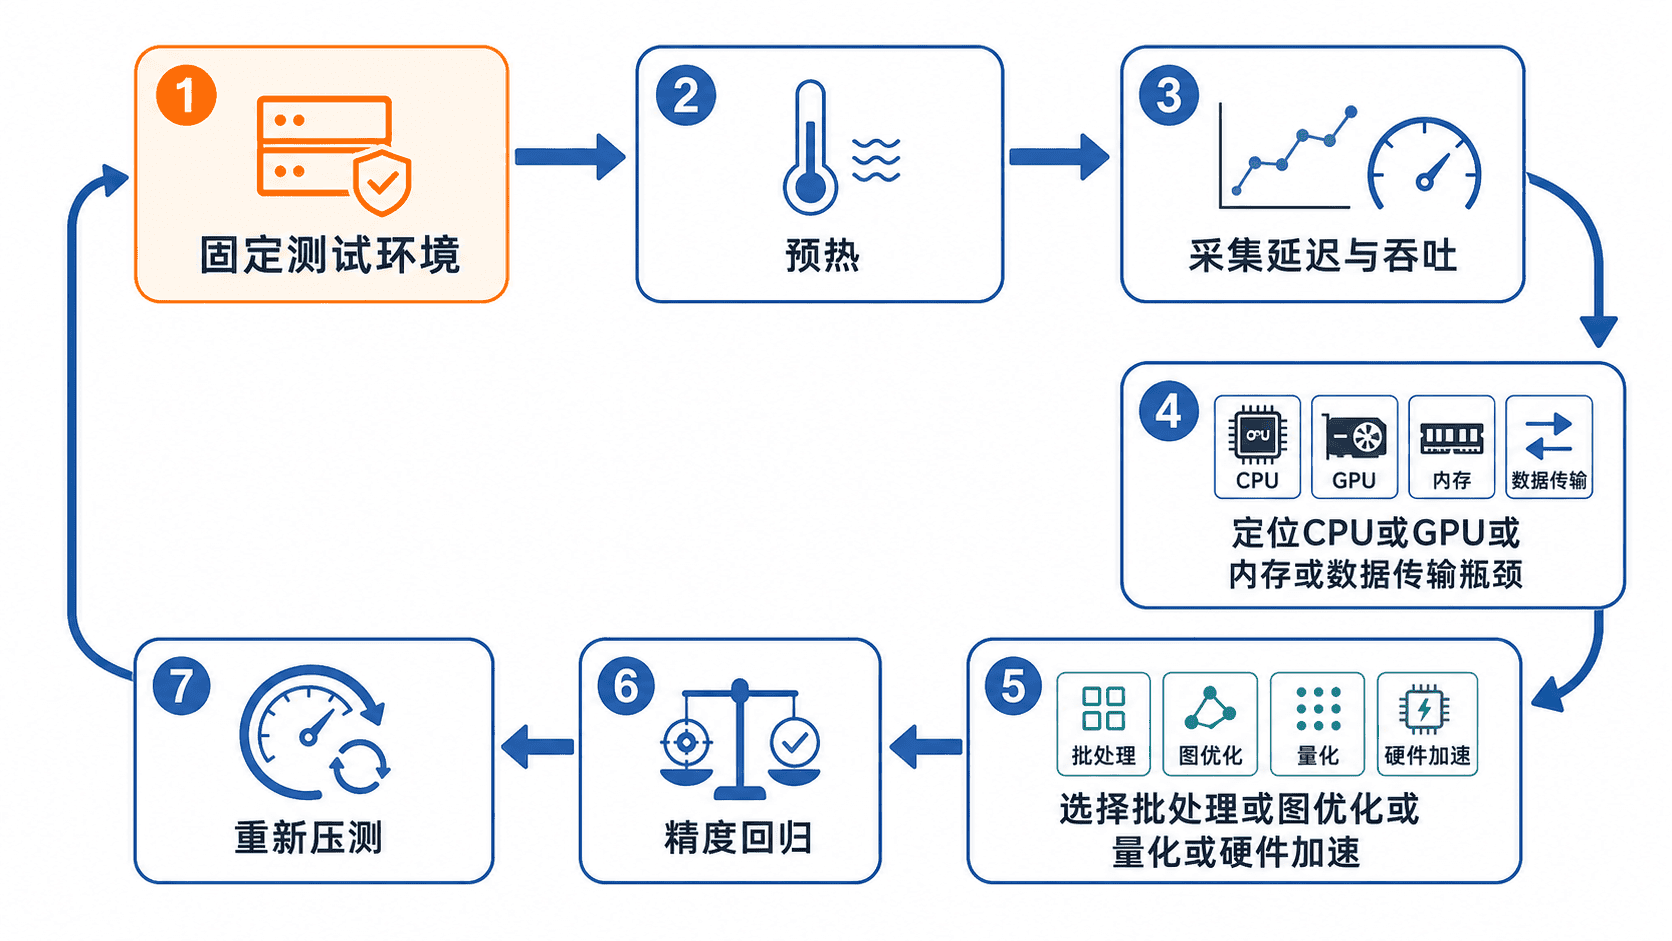
建立可复现基准
测试环境必须固定模型版本、输入形状、线程数、批量大小和硬件。正式计时前先预热,使模型权重、运行时缓存和设备上下文进入稳定状态;测试期间不要混入模型加载和首次编译时间。
下面的脚本提供一个最小可运行基准框架。示例中的 infer 是可替换的本地推理函数;接入真实模型时,只替换该函数,并保持预热、计时和并发逻辑不变。
from concurrent.futures import ThreadPoolExecutor
from math import sin
from statistics import median
from time import perf_counter
from typing import List

def infer(seed: int) -> float:
    # 模拟固定规模的推理计算,真实项目中替换为模型调用。
    value = 0.0
    for i in range(20_000):
        value += sin(seed + i * 0.001)
    return value

def percentile(values: List[float], ratio: float) -> float:
    ordered = sorted(values)
    index = min(len(ordered) - 1, int((len(ordered) - 1) * ratio))
    return ordered[index]

def run_benchmark(requests: int = 200, concurrency: int = 8) -> None:
    # 预热不计入正式结果,避免首次执行开销污染延迟。
    for i in range(20):
        infer(i)

    def timed_call(seed: int) -> float:
        start = perf_counter()
        infer(seed)
        return (perf_counter() - start) * 1000

    wall_start = perf_counter()
    with ThreadPoolExecutor(max_workers=concurrency) as pool:
        latencies = list(pool.map(timed_call, range(requests)))
    wall_seconds = perf_counter() - wall_start

    print(f"requests={requests}")
    print(f"concurrency={concurrency}")
    print(f"p50_ms={median(latencies):.2f}")
    print(f"p95_ms={percentile(latencies, 0.95):.2f}")
    print(f"p99_ms={percentile(latencies, 0.99):.2f}")
    print(f"throughput_qps={requests / wall_seconds:.2f}")

if __name__ == "__main__":
run_benchmark()预期输出如下,<VALUE> 会随 CPU、负载和运行环境变化。
requests=200
concurrency=8
p50_ms=<VALUE>
p95_ms=<VALUE>
p99_ms=<VALUE>
throughput_qps=<VALUE>
同一方案至少重复多轮,并报告中位数或稳定区间。若输入长度差异很大,应按短、中、长输入分组压测,避免平均值掩盖最差场景。
量化与硬件加速
优化应从低风险措施开始:复用模型实例、减少格式转换、合并预处理、固定常见输入形状,再考虑动态批处理和运行时图优化。批处理通常能提高 GPU 吞吐,但会增加排队时间,不适合严格的低延迟接口。
量化通过降低权重或激活精度减少内存占用和计算量。选择 INT8、FP16 或 BF16 时,必须在代表性验证集上比较准确率、召回率或业务指标;只看模型文件变小,不能证明部署收益。
硬件加速要以端到端结果为准。GPU 算子更快,不代表请求更快;如果预处理、主机到设备拷贝或后处理占比过高,整体收益会被抵消。最终比较应同时包含 P95、吞吐、峰值内存、功耗或实例成本。
验收与边界
每次只改变一个主要变量,并记录模型版本、运行时版本、硬件、批量大小和精度。优化方案只有在性能达标且精度回归通过时才能上线。
建议把验收条件写成明确阈值,例如“并发 32 时 P95 小于 80 ms、吞吐不低于 500 QPS、核心指标下降不超过 0.5%”。若无法同时满足,应先确定业务优先级,而不是继续盲目调参。
本课总结
- 延迟、吞吐和并发必须联合分析,平均延迟不能替代尾延迟。
- 基准测试要固定环境、执行预热并覆盖真实输入分布。
- 量化和硬件加速必须同时通过性能、精度与成本验收。
下一课预告
下一课将把优化后的模型接入部署监控,建立服务指标、数据漂移、预测质量和版本回滚的完整闭环。