
机器学习与深度学习 / 系统课时
数据集划分与泄漏防范
数据集划分与泄漏防范
本课解决“离线指标很好,上线却失效”的常见问题。你将建立训练、验证、测试三部分的职责边界,按随机、分组或时间方式划分数据,并在预处理、特征构造和调参过程中阻断数据泄漏。
学习目标
- 明确训练集、验证集和测试集的不同职责
- 根据样本关系选择随机、分组或时间划分
- 识别并阻止样本、时间与特征泄漏
先确定三类数据的职责
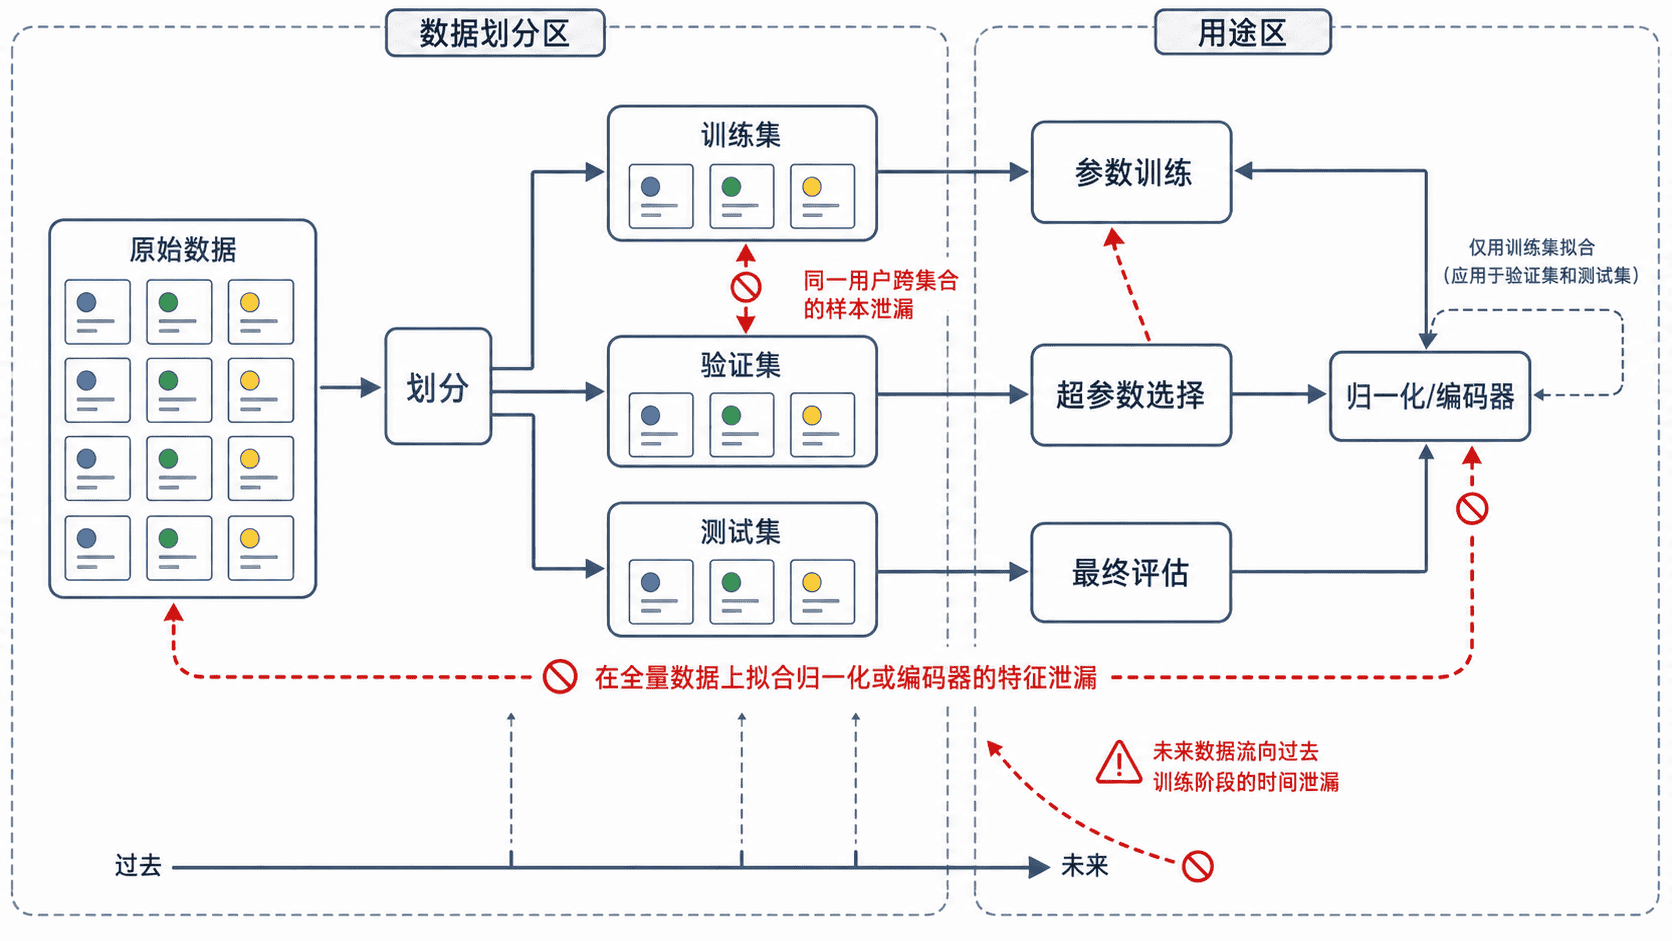
训练集用于拟合模型参数,验证集用于选择超参数、模型结构和停止轮次,测试集只用于方案确定后的最终评估。测试集一旦被反复查看,就会逐渐变成验证集,最终指标也会偏乐观。
常见比例可以从 70%/15%/15% 或 80%/10%/10% 起步,但比例不是核心。真正重要的是三部分能否代表未来数据,以及同一实体、同一事件或因果相关样本是否被错误拆散。
按数据生成方式选择划分策略
随机划分适用于样本近似独立且分布稳定的任务。用户、患者、设备或商品会产生多条记录时,应按实体分组划分,避免同一实体同时出现在训练集和验证集。预测未来行为时,应按时间先后划分,不能让未来样本进入训练阶段。
| 数据特征 | 推荐策略 | 主要防范问题 |
|---|---|---|
| 样本相互独立 | 随机划分 | 类别比例严重偏移 |
| 同一实体有多条记录 | 分组划分 | 实体信息被模型记住 |
| 目标是预测未来 | 时间划分 | 使用未来信息预测过去 |
| 类别极不均衡 | 分层划分 | 某个集合缺少少数类 |
多个条件可能同时存在。例如用户行为预测既要按用户分组,又要保证测试时间晚于训练时间,此时应先依据业务因果关系制定约束,而不是机械调用一次随机切分。
用代码验证分组互斥
下面使用标准库按用户划分数据,并显式检查三个集合的用户是否重叠。真实项目可将 user_id 替换为患者、设备、商户或会话等业务实体标识。
import random

records = [
    {"user_id": f"u{i:02d}", "time": f"2026-07-{day:02d}", "label": i % 2}
    for i in range(1, 11)
    for day in (1, 15)
]

users = sorted({row["user_id"] for row in records})
random.Random(42).shuffle(users)

train_users = set(users[:6])
val_users = set(users[6:8])
test_users = set(users[8:])

train = [row for row in records if row["user_id"] in train_users]
validation = [row for row in records if row["user_id"] in val_users]
test = [row for row in records if row["user_id"] in test_users]

# 交集必须为空,否则同一用户的信息会跨集合泄漏
assert train_users.isdisjoint(val_users)
assert train_users.isdisjoint(test_users)
assert val_users.isdisjoint(test_users)

print(f"train={len(train)}, val={len(validation)}, test={len(test)}")
print("train∩val =", sorted(train_users & val_users))
print("train∩test =", sorted(train_users & test_users))
print("val∩test =", sorted(val_users & test_users))
预期输出:
train=12, val=4, test=4
train∩val = []
train∩test = []
val∩test = []
固定随机种子可以复现实验,但不能保证划分合理。还应检查各集合的标签比例、时间范围、实体数量和关键特征分布,并将划分结果持久化,避免每次训练重新抽样导致指标不可比较。
防止预处理与特征泄漏
归一化、缺失值填充、类别编码、特征选择和降维都必须只在训练集上拟合,再将已经确定的变换应用到验证集和测试集。先对全量数据计算均值、词表或主成分,即使没有使用标签,也会把评估数据的信息带入模型。
特征构造还要检查时间可用性。例如预测订单是否退款时,“退款完成时间”“最终状态”或事后人工标签在预测时尚不存在,属于目标泄漏。判断一个特征能否使用,应问:模型做出预测的那个时刻,系统是否已经真实获得该字段。
建立交付前检查表
- 同一业务实体是否跨越训练、验证和测试集合
- 测试集时间是否真正晚于训练数据,且没有未来特征回流
- 所有预处理器是否只在训练集上执行
fit - 测试集是否只在最终方案确定后使用一次
- 去重是否在划分前完成,并覆盖近重复样本
当线上数据分布会持续变化时,还应保存划分时间边界和数据版本。这样出现指标下降时,才能区分模型退化、数据漂移和评估口径变化。
本课总结
- 数据划分首先服从业务实体关系和时间因果关系,而不是固定比例
- 验证集负责选择方案,测试集只负责最终无偏评估
- 泄漏不仅来自重复样本,也可能来自未来字段和全量预处理统计量
下一课预告
下一课将进入正则化方法,比较权重衰减、Dropout 与早停分别约束什么问题,以及它们应如何组合使用。