
机器学习与深度学习 / 系统课时
导出 TorchScript 与 ONNX
导出 TorchScript 与 ONNX
本课把一个可运行的 PyTorch 分类模型分别导出为 TorchScript 和 ONNX,并用重新加载与跨运行时推理验证结果一致,同时说明动态批次、控制流和算子兼容的处理边界。
学习目标
- 根据部署运行时选择 TorchScript 或 ONNX
- 为 ONNX 输入声明动态批次并完成结果校验
- 定位控制流、输入形状和不支持算子导致的导出失败
选择导出格式
TorchScript 将模型转换为可保存、可由 PyTorch JIT 或 LibTorch 加载的程序,适合维护已有的 PyTorch 原生部署链路。ONNX 强调框架无关的计算图,通常交给 ONNX Runtime、TensorRT 等后端执行。
| 维度 | TorchScript | ONNX |
|---|---|---|
| 主要运行时 | PyTorch JIT、LibTorch | ONNX Runtime、TensorRT 等 |
| Python 依赖 | 可脱离 Python,由 C++ 加载 | 通常可脱离 PyTorch |
| 动态能力 | 取决于 trace 或 script 的捕获方式 | 需显式声明动态形状与后端支持 |
| 适合场景 | 既有 PyTorch 部署链路 | 跨框架、跨语言或推理引擎优化 |
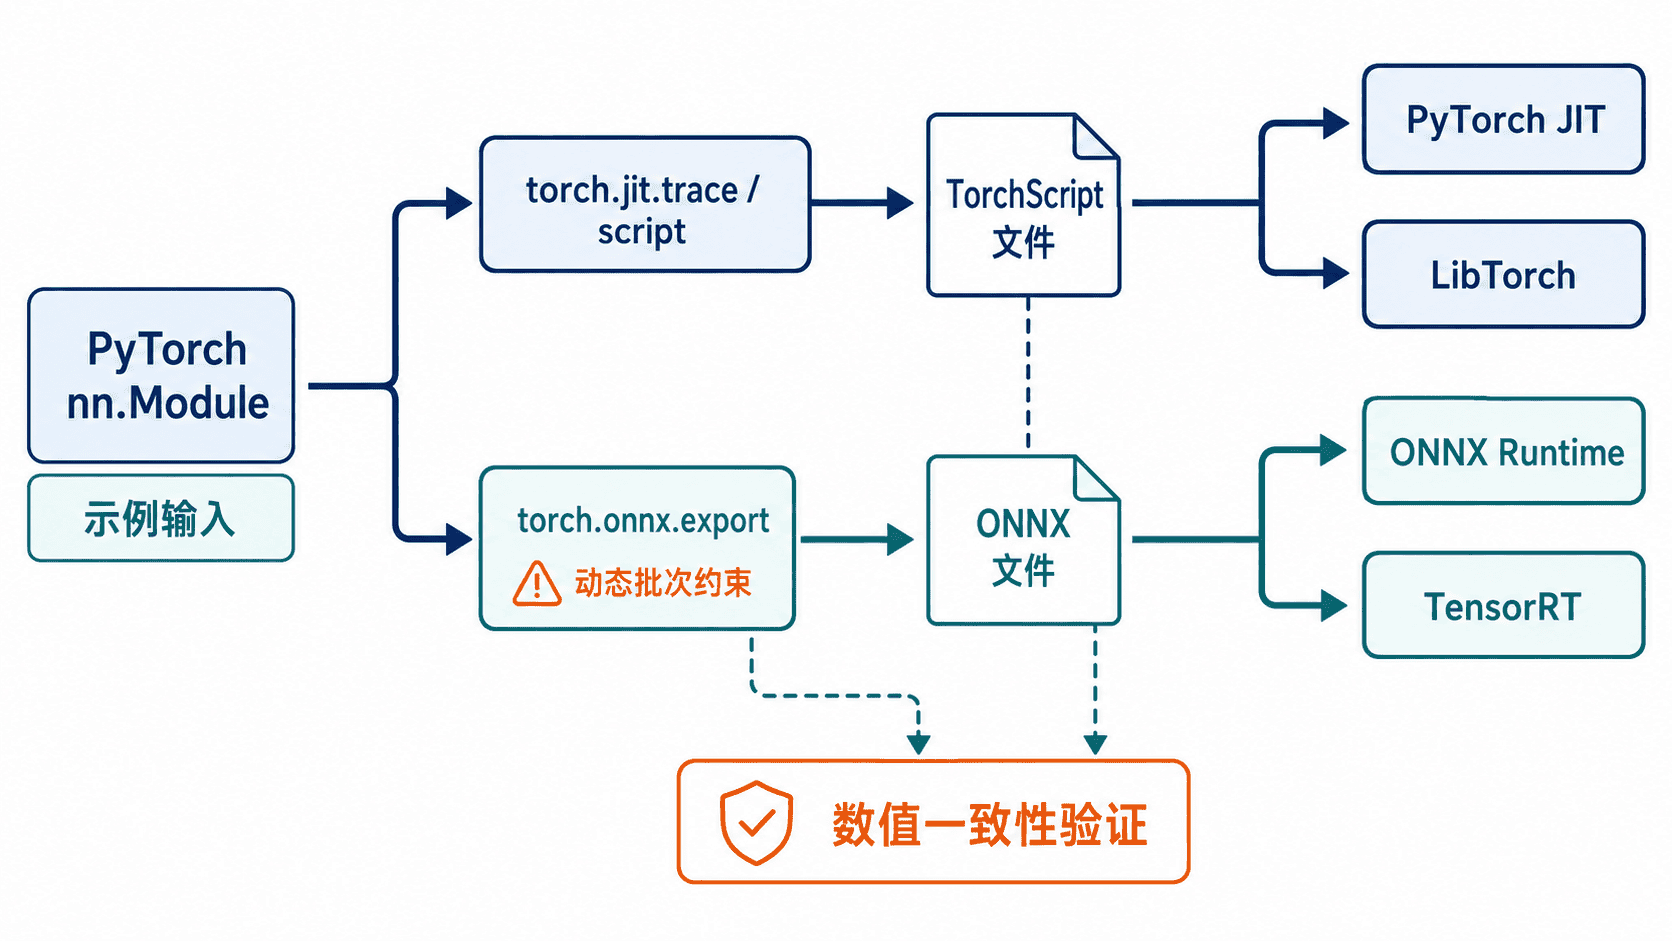
导出并验证两个模型
下面的主示例使用纯张量运算且没有数据相关分支,因此可以安全地用 torch.jit.trace。ONNX 导出使用 dynamo=True,并把 features 的第 0 维声明为 1~32 的动态批次。
from pathlib import Path

import numpy as np
import onnxruntime as ort
import torch
from torch import nn

class TinyClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(8, 16),
            nn.ReLU(),
            nn.Linear(16, 3),
        )

    def forward(self, features: torch.Tensor) -> torch.Tensor:
        return self.network(features)

def main() -> None:
    torch.manual_seed(7)
    output_dir = Path("artifacts")
    output_dir.mkdir(exist_ok=True)

    model = TinyClassifier().eval()
    example = torch.randn(2, 8)

    with torch.inference_mode():
        eager_output = model(example)

    # trace 只记录示例输入实际经过的张量运算路径。
    traced = torch.jit.trace(model, example, check_trace=True)
    torch.jit.save(traced, output_dir / "tiny_classifier.ts")

    loaded_ts = torch.jit.load(output_dir / "tiny_classifier.ts").eval()
    with torch.inference_mode():
        ts_output = loaded_ts(example)
    torch.testing.assert_close(eager_output, ts_output)

    # 仅让批次维动态,特征维仍固定为 8。
    batch = torch.export.Dim("batch", min=1, max=32)
    torch.onnx.export(
        model,
        (example,),
        output_dir / "tiny_classifier.onnx",
        input_names=["features"],
        output_names=["logits"],
        dynamic_shapes={"features": {0: batch}},
        opset_version=18,
        dynamo=True,
    )

    session = ort.InferenceSession(
        str(output_dir / "tiny_classifier.onnx"),
        providers=["CPUExecutionProvider"],
    )
    ort_output = session.run(
        ["logits"],
        {"features": example.numpy()},
    )[0]
    np.testing.assert_allclose(
        eager_output.detach().numpy(),
        ort_output,
        rtol=1e-4,
        atol=1e-5,
    )

    print("TorchScript verification: passed")
    print("ONNX Runtime verification: passed")
    print("Artifacts: artifacts/tiny_classifier.ts, artifacts/tiny_classifier.onnx")

if __name__ == "__main__":
    main()
预期结果:脚本在 artifacts 目录生成两个模型文件,并在断言通过后打印稳定的验证信息。运行环境需提前安装 torch、onnx、onnxscript、onnxruntime 和 numpy。
python export_models.py预期输出如下;导出器可能在这些关键行之前输出额外诊断日志。
TorchScript verification: passed
ONNX Runtime verification: passed
Artifacts: artifacts/tiny_classifier.ts, artifacts/tiny_classifier.onnx
理解动态批次的边界
动态批次不等于任意形状。示例只把第 0 维设为动态,因此 (1, 8)、(8, 8) 可以复用同一模型,而 (2, 10) 仍会失败,因为网络第一层固定接收 8 个特征。
采用较新的 ONNX 导出路径时优先使用 dynamic_shapes。维护旧的 dynamo=False 导出代码时可能看到 dynamic_axes,二者不要在未理解导出路径的情况下混用。动态范围也应贴近服务真实上限,避免后端为不可能出现的超大形状准备资源。
处理控制流与算子兼容
torch.jit.trace 不会理解普通 Python 分支的语义,只会记录示例输入走过的路径。模型包含由输入值决定的分支或循环时,应改写为可导出的张量控制流,或评估 torch.jit.script、torch.export 等更合适的方案。
ONNX 导出成功也不代表目标后端一定能执行。定位问题时按“最小输入复现、查看具体算子、确认 opset 与运行时支持、替换或分解不支持算子、再次做数值对比”的顺序处理。生产交付前还应使用多组正常输入和边界批次验证,而不是只验证导出时的单个样本。
本课总结
- TorchScript 更贴近 PyTorch 原生运行时,ONNX 更适合跨运行时部署
- 动态批次必须显式声明,并保留固定特征维等真实约束
- 导出完成后必须重新加载模型,用目标运行时做数值一致性验证
下一课预告
下一课将把已初始化的模型封装为批量推理服务,加入请求校验、短窗口合批、错误返回和统一响应结构。