
机器学习与深度学习 / 系统课时
分析错误样本
分析错误样本
本课建立一套可执行的错误分析方法:先筛出预测错误,再按错误类型、置信度和数据切片聚合,找到影响最大的模式,并把发现转化为数据、模型或阈值调整任务。
学习目标
- 区分假阳性、假阴性及其业务影响
- 按置信度和数据切片发现集中性问题
- 将错误统计转化为可验证的改进动作
建立三维错误视图
只浏览几条错误样本容易被偶然现象误导。更稳定的方法是同时观察三个维度:错误类型回答“错成了什么”,置信度回答“模型有多确信”,数据切片回答“错误集中在哪类输入”。
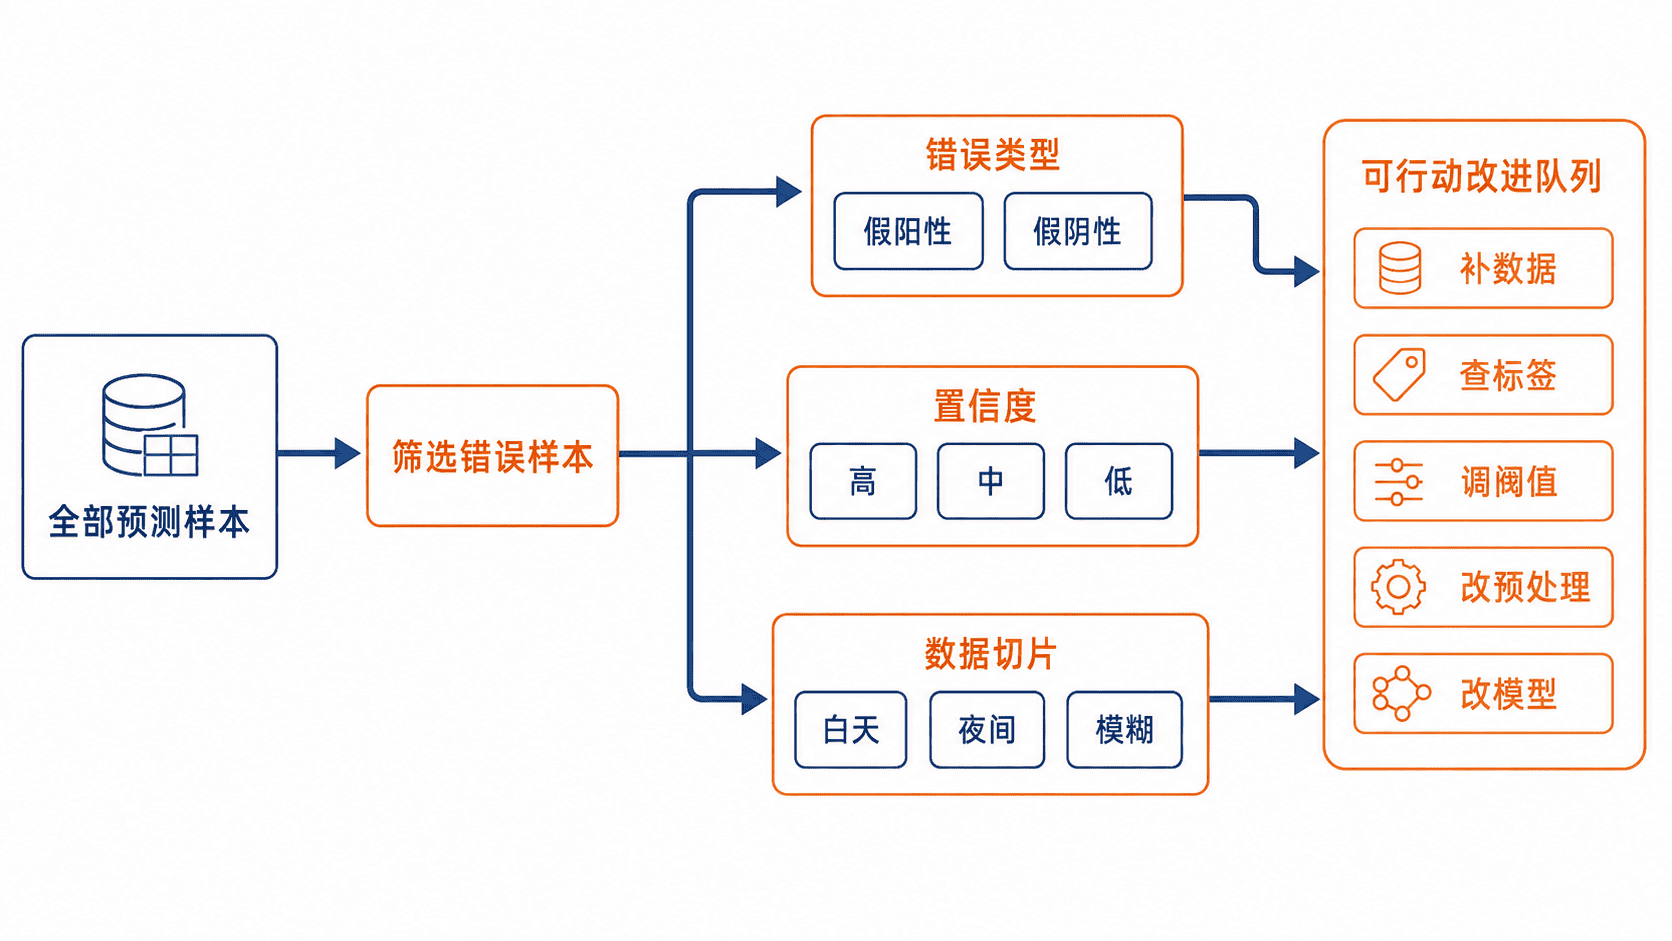
错误率必须带分母。例如“夜间有 20 个错误”不说明问题严重程度;若夜间共有 25 个样本,错误率是 80%,若共有 2000 个样本,则只有 1%。因此切片分析要同时记录样本数、错误数和错误率。
用脚本聚合错误模式
下面的完整示例对二分类预测记录进行统计。它会计算假阳性和假阴性数量、错误样本的置信度分布,以及各数据切片的错误率,并导出错误明细。
python
from collections import Counter, defaultdict
import csv

records = [
    {"id": "S01", "true": 1, "pred": 1, "confidence": 0.95, "slice": "night"},
    {"id": "S02", "true": 0, "pred": 1, "confidence": 0.92, "slice": "night"},
    {"id": "S03", "true": 1, "pred": 0, "confidence": 0.88, "slice": "blur"},
    {"id": "S04", "true": 0, "pred": 0, "confidence": 0.80, "slice": "day"},
    {"id": "S05", "true": 1, "pred": 0, "confidence": 0.61, "slice": "night"},
    {"id": "S06", "true": 0, "pred": 1, "confidence": 0.55, "slice": "blur"},
    {"id": "S07", "true": 1, "pred": 1, "confidence": 0.72, "slice": "day"},
    {"id": "S08", "true": 0, "pred": 0, "confidence": 0.67, "slice": "night"},
]

def error_type(item: dict) -> str:
    if item["true"] == 0 and item["pred"] == 1:
        return "false_positive"
    if item["true"] == 1 and item["pred"] == 0:
        return "false_negative"
    return "correct"

def confidence_bucket(value: float) -> str:
    if value >= 0.80:
        return "high"
    if value >= 0.60:
        return "medium"
    return "low"

type_counts = Counter()
confidence_counts = Counter()
slice_stats = defaultdict(lambda: {"total": 0, "errors": 0})
errors = []

for item in records:
    category = error_type(item)
    slice_stats[item["slice"]]["total"] += 1

    if category != "correct":
        enriched = {
            **item,
            "error_type": category,
            "confidence_bucket": confidence_bucket(item["confidence"]),
        }
        errors.append(enriched)
        type_counts[category] += 1
        confidence_counts[enriched["confidence_bucket"]] += 1
        slice_stats[item["slice"]]["errors"] += 1

with open("error_samples.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=errors[0].keys())
    writer.writeheader()
    writer.writerows(errors)

print("error_types", dict(type_counts))
print("confidence", dict(confidence_counts))

ranking = sorted(
    (
        (name, stat["errors"], stat["total"], stat["errors"] / stat["total"])
        for name, stat in slice_stats.items()
    ),
    key=lambda row: row[3],
    reverse=True,
)
for name, error_count, total, rate in ranking:
    print(f"slice={name}, errors={error_count}/{total}, error_rate={rate:.0%}")

print("saved=error_samples.csv")
预期输出
text
error_types {'false_positive': 2, 'false_negative': 2}
confidence {'high': 2, 'medium': 1, 'low': 1}
slice=blur, errors=2/2, error_rate=100%
slice=night, errors=2/4, error_rate=50%
slice=day, errors=0/2, error_rate=0%
saved=error_samples.csv
这里的输出说明“模糊”切片问题最集中,同时存在两个高置信度错误。由于样本很少,这只是定位线索,不能直接当作稳定结论;真实项目还应设置最小样本量,避免被极小切片误导。
把统计结果转成改进动作
高置信度错误通常优先检查标签质量、类别定义冲突和模型盲区,因为模型不仅错了,而且非常确信。低置信度错误更接近决策边界,可进一步评估阈值、概率校准或是否需要增加拒识区间。
若错误集中在某个数据切片,应先确认该切片的采集、标注和预处理是否与其他样本一致。比如模糊图像错误率高,可以补充真实模糊样本、检查缩放策略,并设计只改变一个因素的对照实验验证改进。
还要结合业务代价确定优先级。风控场景可能更重视假阴性,内容审核可能更重视假阳性。错误数量相同,并不代表修复优先级相同。
本课总结
- 错误分析应同时观察错误类型、置信度和数据切片
- 切片统计必须包含分母与最小样本量,避免错误解读
- 每个发现都要落到可验证的补数据、查标签、调阈值或改模型动作
下一课预告
下一课将把对照实验和错误分析串成完整迭代闭环,用统一验收标准判断一次模型改动是否可以保留。
按自己的节奏,确认真正理解。