
机器学习与深度学习 / 系统课时
优化数据输入管线
优化数据输入管线
本课从“GPU 算得快但经常等数据”这一现象出发,构建包含预处理缓存、多进程加载、批次预取、锁页内存和异步拷贝的输入管线,并给出可验证的 PyTorch 示例。
学习目标
- 判断性能瓶颈是否位于数据读取与预处理阶段
- 正确配置缓存、
num_workers、prefetch_factor和pin_memory - 通过批次耗时与 GPU 利用率验证优化是否有效
先定位设备等待
输入管线的目标不是让 CPU 单独更快,而是让下一批数据在 GPU 完成本批计算前准备好。若训练日志中数据等待时间接近或超过模型计算时间,或者 GPU 利用率呈周期性跌落,就应优先检查读取、解码、增强和主机到设备拷贝。
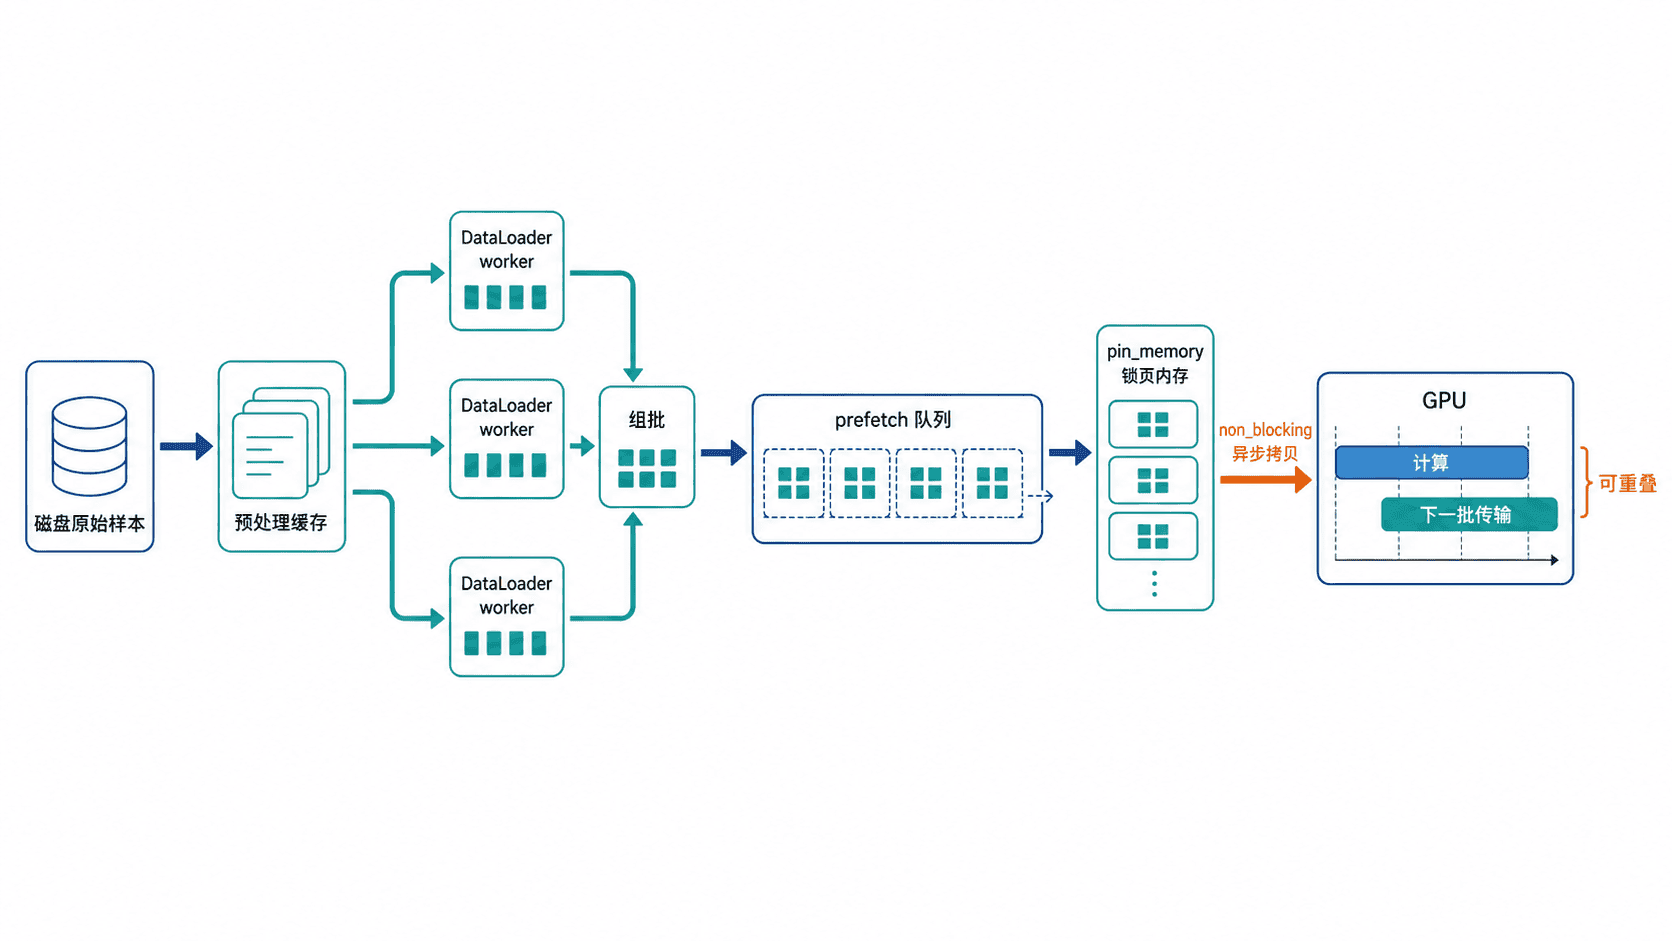
优化前先分别记录“取下一批数据耗时”和“GPU 计算耗时”。只有前者占比较高时,增加 worker 或缓存才可能带来收益;若计算本身已经占满 GPU,继续堆叠 worker 只会增加内存与进程开销。
构建可复用的高吞吐管线
下面的脚本先把确定性的预处理结果写入本地缓存,再由多个 worker 并行加载。pin_memory=True 配合 .to(..., non_blocking=True),可在 CUDA 环境中减少主机到设备传输的阻塞。
import os
import time
from pathlib import Path

import torch
from torch.utils.data import DataLoader, Dataset

class CachedTensorDataset(Dataset):
    def __init__(self, cache_dir: Path, sample_count: int = 256) -> None:
        self.cache_dir = cache_dir
        self.sample_count = sample_count

    def __len__(self) -> int:
        return self.sample_count

    def __getitem__(self, index: int) -> tuple[torch.Tensor, torch.Tensor]:
        sample = torch.load(
            self.cache_dir / f"{index:05d}.pt",
            map_location="cpu",
            weights_only=True,
        )
        return sample["image"], sample["label"]

def build_cache(cache_dir: Path, sample_count: int) -> None:
    cache_dir.mkdir(parents=True, exist_ok=True)
    generator = torch.Generator().manual_seed(42)

    # 缓存只保存稳定且可复用的预处理结果,随机增强应留在训练阶段
    for index in range(sample_count):
        target = cache_dir / f"{index:05d}.pt"
        if target.exists():
            continue
        image = torch.randn(3, 128, 128, generator=generator)
        label = torch.tensor(index % 10)
        torch.save({"image": image, "label": label}, target)

def main() -> None:
    sample_count = 256
    cache_dir = Path(".cache") / "training-samples"
    build_cache(cache_dir, sample_count)

    worker_count = min(4, os.cpu_count() or 1)
    loader_options = {
        "batch_size": 32,
        "shuffle": True,
        "num_workers": worker_count,
        "pin_memory": torch.cuda.is_available(),
    }
    if worker_count > 0:
        # 每个 worker 预取两个批次,并在多轮训练间保持进程存活
        loader_options["prefetch_factor"] = 2
        loader_options["persistent_workers"] = True

    loader = DataLoader(
        CachedTensorDataset(cache_dir, sample_count),
        **loader_options,
    )

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    started_at = time.perf_counter()
    batch_count = 0

    for images, labels in loader:
        images = images.to(device, non_blocking=True)
        labels = labels.to(device, non_blocking=True)
        _ = images.mean() + labels.float().mean()
        batch_count += 1

    elapsed = time.perf_counter() - started_at
    print(f"device={device.type}")
    print(f"workers={worker_count}, batches={batch_count}")
    print(f"elapsed_seconds={elapsed:.3f}")

if __name__ == "__main__":
    main()
执行脚本:
python optimize_loader.py预期输出如下,设备类型、worker 数量和耗时会因机器配置而变化:
device=<DEVICE>
workers=<WORKERS>, batches=8
elapsed_seconds=<SECONDS><DEVICE>、<WORKERS> 与 <SECONDS> 是动态值。固定的 batches=8 来自 256 条样本和批大小 32,可用于确认组批没有遗漏。
调参与边界
num_workers 应逐步增加,而不是直接设为 CPU 核心数。worker 太少会让 GPU 等待,太多则可能引起上下文切换、内存竞争或存储随机读取拥塞。建议从 2 或 4 开始,保持模型、批大小和数据集不变,比较稳定阶段的每秒样本数。
prefetch_factor 表示每个 worker 预取的批次数,总预取量大致为 num_workers × prefetch_factor。批次很大时,提高它会明显增加主机内存占用。persistent_workers=True 适合多轮训练,可避免每个 epoch 重建进程,但数据集状态必须能够长期保留。
缓存应保存解码、缩放或特征提取等确定性结果,不要把随机裁剪、随机翻转等增强永久缓存,否则每轮会看到相同样本。批大小也不是越大越好,应在显存可承受范围内寻找吞吐与收敛效果的平衡点。
最终验证要同时观察数据等待时间、整体 step 时间、GPU 利用率和主机内存。只有端到端训练吞吐提高,且样本与标签仍然正确,才算优化成功。
本课总结
- 输入优化应先确认 GPU 正在等待数据,再针对读取、预处理或传输瓶颈处理
- 缓存、并行 worker、预取和锁页内存需要组合使用,并通过端到端吞吐验证
- 随机增强不应永久缓存,worker 与预取数量也必须受 CPU、内存和存储能力约束
下一课预告
下一课将继续分析训练性能瓶颈,结合时间剖析结果区分计算、通信、显存和输入管线问题。