
机器学习与深度学习 / 系统课时
实验复现与版本管理
实验复现与版本管理
本课解决“同一实验为什么无法再次得到相同结果”的问题。你将为代码、数据、环境、配置、权重和指标建立统一版本记录,并生成可追溯的实验清单,使任意结果都能定位到具体输入和产物。
学习目标
- 建立一次实验所需的最小版本闭环
- 为配置、数据和权重生成稳定指纹
- 生成可检索、可审计的实验清单
复现需要锁定哪些对象
实验结果不是只由代码决定。相同脚本在不同数据快照、依赖版本、随机种子或配置下,都可能得到不同指标。因此,一次运行应绑定六类信息:代码提交、数据版本、环境清单、运行配置、模型权重和最终指标。
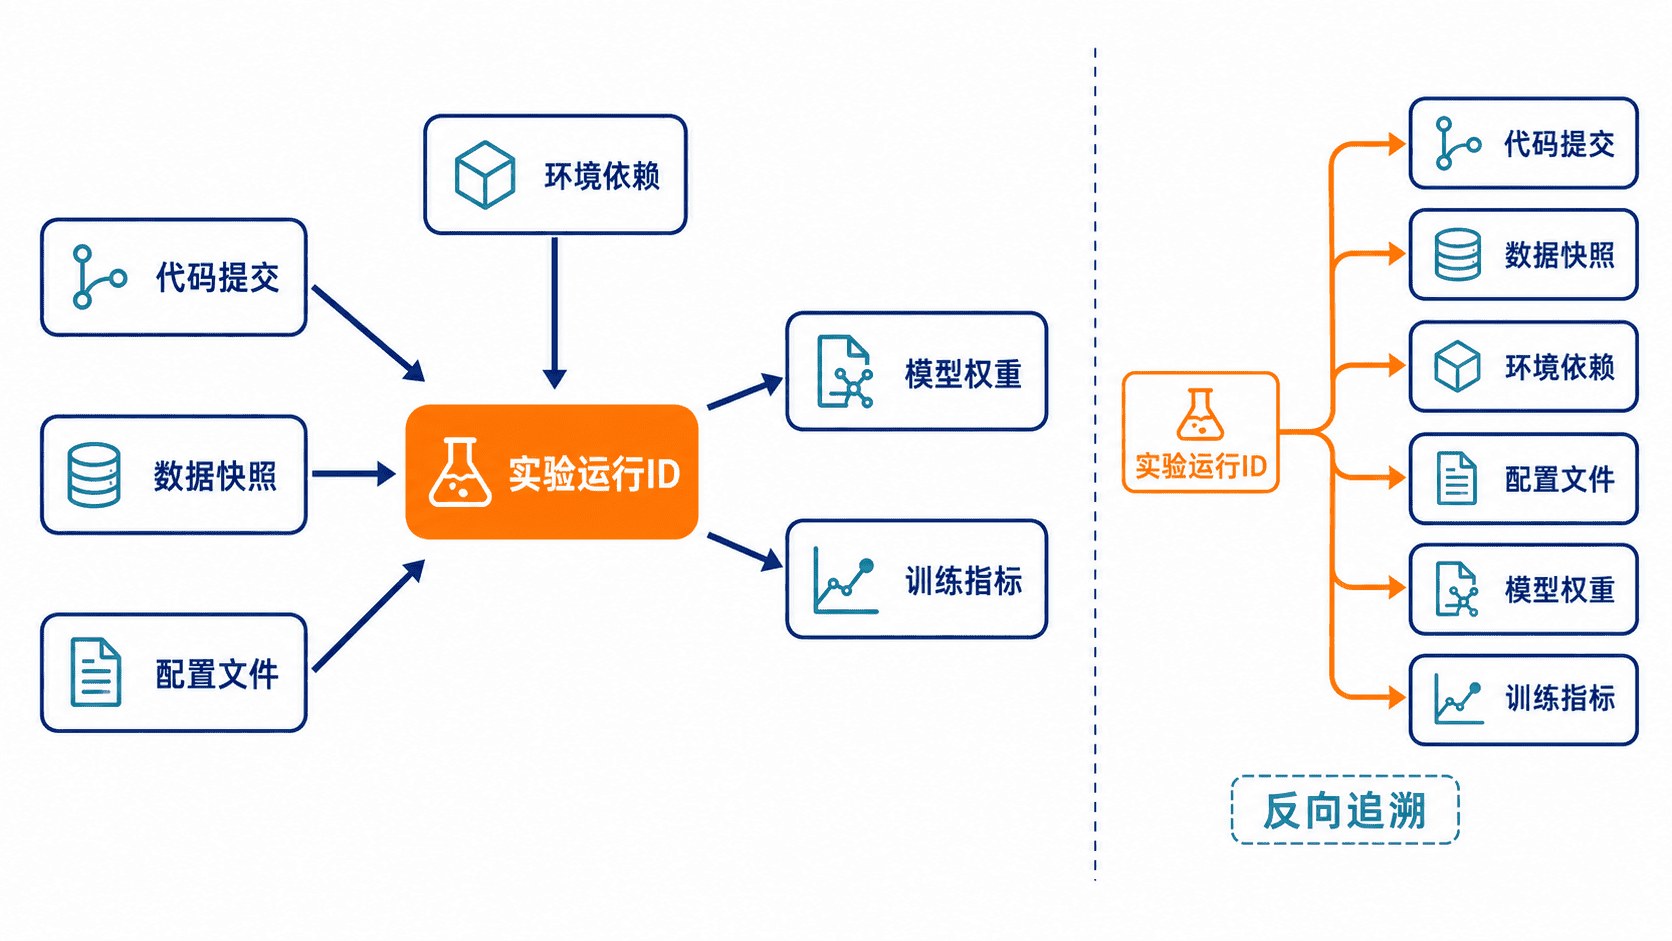
代码和小型配置适合进入 Git;大型数据与权重通常存放在对象存储或制品库,并用不可变路径和 SHA-256 摘要标识。实验目录中保存的不是“最新文件”概念,而是能唯一指向具体内容的版本信息。
建立统一实验清单
下面的程序读取配置、数据文件和权重文件,记录 Git 提交、Python 版本、依赖清单、命令行参数与文件摘要,并写入独立的运行目录。运行前需要已有 config.json、训练数据和权重文件。
import argparse
import hashlib
import json
import platform
import subprocess
import sys
from datetime import datetime, timezone
from pathlib import Path
from uuid import uuid4

def sha256_file(path):
    # 分块读取可避免大型数据或权重一次性占满内存
    digest = hashlib.sha256()
    with open(path, "rb") as file:
        for chunk in iter(lambda: file.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()

def run_command(args, fallback):
    # Git 或 pip 不可用时保留明确状态,而不是伪造版本信息
    try:
        result = subprocess.run(
            args,
            check=True,
            capture_output=True,
            text=True,
        )
        return result.stdout.strip()
    except (FileNotFoundError, subprocess.CalledProcessError):
        return fallback

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--config", required=True)
    parser.add_argument("--data", required=True)
    parser.add_argument("--weights", required=True)
    parser.add_argument("--metrics", required=True)
    parser.add_argument("--output-dir", default="runs")
    args = parser.parse_args()

    config_path = Path(args.config)
    data_path = Path(args.data)
    weights_path = Path(args.weights)
    for path in (config_path, data_path, weights_path):
        if not path.is_file():
            raise FileNotFoundError(f"missing file: {path}")

    # 排序后序列化,使相同配置内容得到稳定摘要
    config = json.loads(config_path.read_text(encoding="utf-8"))
    metrics = json.loads(args.metrics)
    config_hash = hashlib.sha256(
        json.dumps(config, sort_keys=True, ensure_ascii=False).encode("utf-8")
    ).hexdigest()

    created_at = datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%SZ")
    run_id = f"{created_at}-{config_hash[:8]}-{uuid4().hex[:6]}"
    run_dir = Path(args.output_dir) / run_id
    run_dir.mkdir(parents=True, exist_ok=False)  # 禁止覆盖已有实验目录

    git_status = run_command(["git", "status", "--porcelain"], "UNAVAILABLE")
    manifest = {
        "run_id": run_id,
        "created_at_utc": created_at,
        "git_commit": run_command(["git", "rev-parse", "HEAD"], "UNCOMMITTED"),
        "git_dirty": git_status not in ("", "UNAVAILABLE"),
        "python_version": platform.python_version(),
        "platform": platform.platform(),
        "command": sys.argv,
        "config": config,
        "config_sha256": config_hash,
        "data": {
            "path": str(data_path),
            "sha256": sha256_file(data_path),
        },
        "weights": {
            "path": str(weights_path),
            "sha256": sha256_file(weights_path),
        },
        "metrics": metrics,
        "pip_freeze": run_command(
            [sys.executable, "-m", "pip", "freeze"],
            "UNAVAILABLE",
        ).splitlines(),
    }

    manifest_path = run_dir / "manifest.json"
    manifest_path.write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )
    print(f"run_id={run_id}")
    print(f"manifest={manifest_path}")
    print(f"config_sha256={config_hash[:12]}")

if __name__ == "__main__":
    main()
运行命令中的指标使用标准 JSON 字符串传入,实际项目也可以从训练程序直接调用记录函数。
python record_run.py --config config.json --data data/train.csv --weights checkpoints/best.pt --metrics '{"val_loss":0.1842,"val_accuracy":0.931}'预期输出中的运行 ID 和哈希前缀会随文件内容与运行时间变化。
run_id=<RUN_ID>
manifest=runs/<RUN_ID>/manifest.json
config_sha256=<HASH_PREFIX>
版本管理与复现实验
复现实验时,先确认 git_dirty 为 false 并检出 git_commit,再使用清单中的环境依赖重建虚拟环境,获取摘要一致的数据和权重,最后按记录的命令与配置重新运行。若工作区未提交或任一文件摘要不一致,都应视为不同实验。
配置必须完整包含随机种子、数据切分、预处理参数、模型结构、优化器、学习率调度、批大小和训练轮数。指标文件应与对应权重放在同一运行目录,避免把“最佳指标”与另一份模型权重错误配对。
不要把大型权重直接反复提交到普通 Git 仓库。更稳妥的做法是保存不可变制品地址、内容摘要和生成它的运行 ID,再通过权限受控的存储系统获取文件。
本课总结
- 可复现实验必须同时锁定代码、数据、环境、配置、权重和指标
- 运行 ID 与内容摘要能把结果关联到唯一输入和产物
- 复现时应逐项验证版本,而不是依赖“latest”目录或人工记忆
下一课预告
下一课将继续完善训练工程,把数据管线、检查点和实验记录接入统一的自动化训练流程。