
机器学习与深度学习 / 系统课时
训练迭代与对照实验
训练迭代与对照实验
本课把“凭感觉调参”改造成可复现的实验流程:先固定基线,再只改变一个关键因素,统一记录配置与指标,最后用证据解释变化并决定下一轮实验。
学习目标
- 建立一次只改变一个因素的对照实验规则
- 用可复现脚本记录配置、指标和实验结果
- 区分真实改进、随机波动与实验污染
建立最小实验闭环
一次有效迭代应包含六个动作:提出假设、确定基线、修改单一变量、运行训练、比较结果、形成结论。数据划分、随机种子、评估代码和训练轮数都应保持不变,否则无法判断性能变化来自哪个因素。
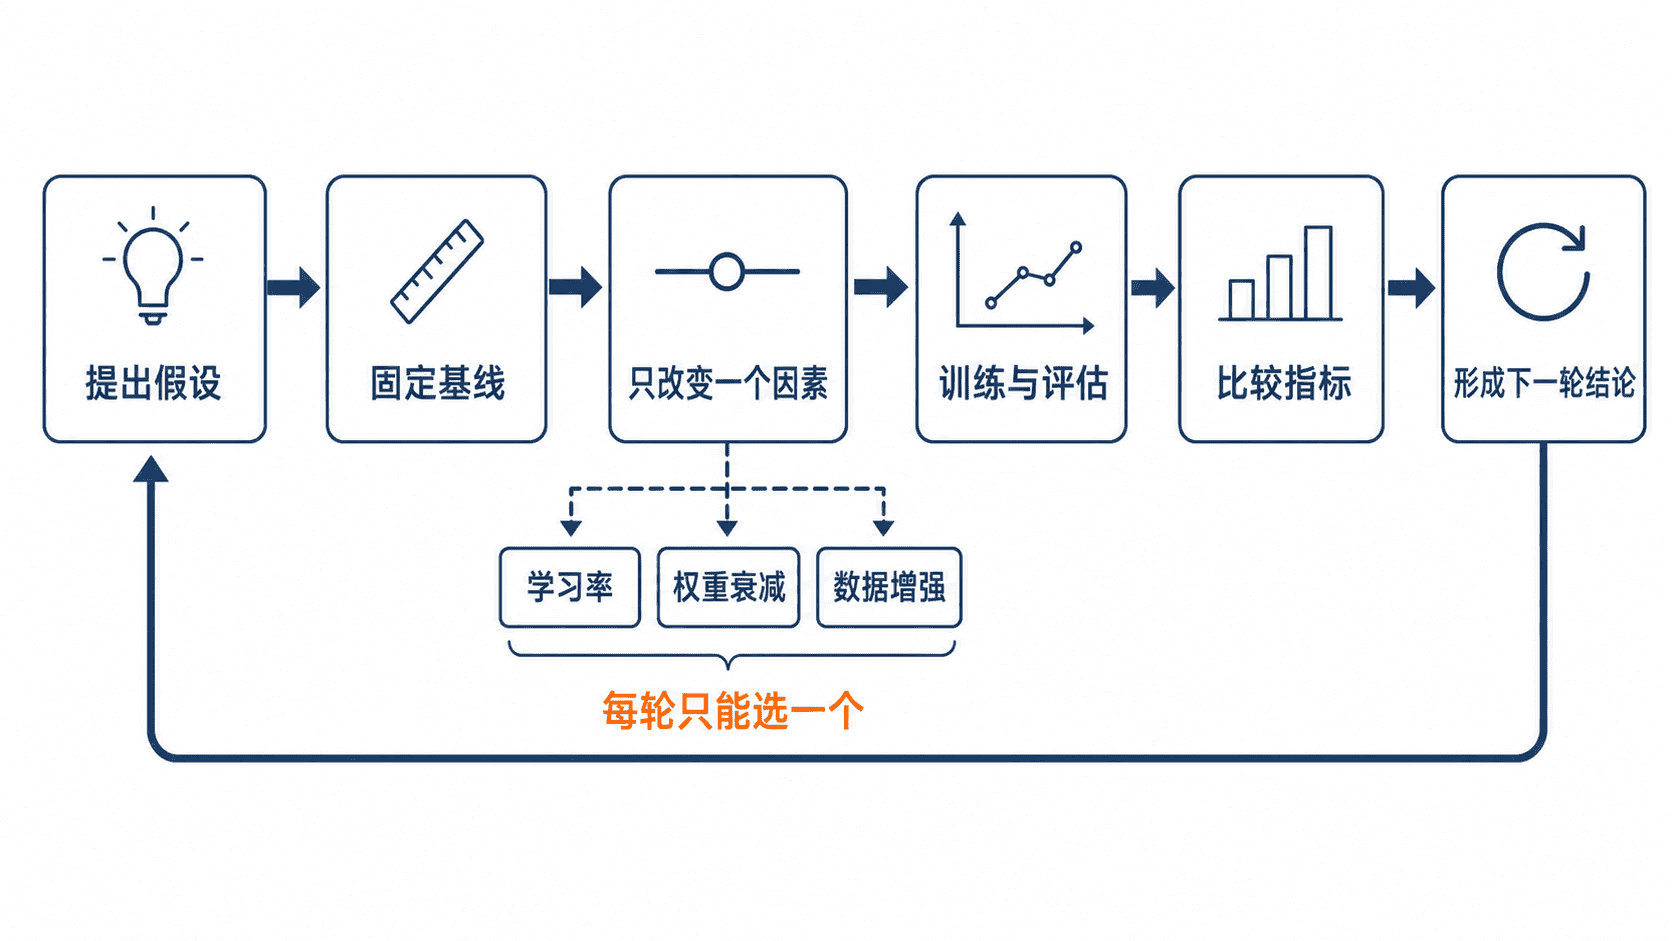
对照实验还要预先确定主指标。例如分类任务可把验证集准确率作为主指标,同时记录训练损失、验证损失和运行时间。不要在结果出来后临时更换“最重要”的指标,否则容易只挑选有利结论。
编写可复现的实验脚本
下面的完整示例在同一份合成数据上运行两个实验。第二次实验只降低学习率,模型结构、随机种子、训练轮数和权重衰减全部保持不变,并把结果写入 CSV。
python
from dataclasses import dataclass
import csv
import random

import torch
from torch import nn

@dataclass(frozen=True)
class Config:
    name: str
    lr: float
    weight_decay: float
    epochs: int = 80
    seed: int = 42

def build_data(seed: int):
    generator = torch.Generator().manual_seed(seed)
    features = torch.randn(800, 2, generator=generator)
    labels = ((0.8 * features[:, 0] + 0.4 * features[:, 1]) > 0).long()
    return features[:600], labels[:600], features[600:], labels[600:]

def run_experiment(config: Config) -> dict:
    random.seed(config.seed)
    torch.manual_seed(config.seed)
    train_x, train_y, val_x, val_y = build_data(config.seed)

    model = nn.Sequential(
        nn.Linear(2, 8),
        nn.ReLU(),
        nn.Linear(8, 2),
    )
    optimizer = torch.optim.AdamW(
        model.parameters(),
        lr=config.lr,
        weight_decay=config.weight_decay,
    )
    criterion = nn.CrossEntropyLoss()

    model.train()
    for _ in range(config.epochs):
        optimizer.zero_grad()
        loss = criterion(model(train_x), train_y)
        loss.backward()
        optimizer.step()

    model.eval()
    with torch.no_grad():
        accuracy = (model(val_x).argmax(dim=1) == val_y).float().mean().item()

    return {
        "name": config.name,
        "lr": config.lr,
        "weight_decay": config.weight_decay,
        "epochs": config.epochs,
        "seed": config.seed,
        "val_accuracy": round(accuracy, 4),
    }

baseline = Config(name="baseline", lr=0.01, weight_decay=0.01)
lower_lr = Config(name="lower_lr", lr=0.003, weight_decay=0.01)

changed = [
    field
    for field in ("lr", "weight_decay", "epochs", "seed")
    if getattr(baseline, field) != getattr(lower_lr, field)
]
if changed != ["lr"]:
    raise ValueError(f"实验必须只改变一个因素,当前变化项:{changed}")

results = [run_experiment(baseline), run_experiment(lower_lr)]

with open("experiment_results.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=results[0].keys())
    writer.writeheader()
    writer.writerows(results)

for result in results:
    print(
        f'{result["name"]}: lr={result["lr"]:.4f}, '
        f'val_accuracy={result["val_accuracy"]:.4f}'
    )
print(f"changed_factor={changed[0]}")
print("saved=experiment_results.csv")
预期输出
text
baseline: lr=0.0100, val_accuracy=<VALUE>
lower_lr: lr=0.0030, val_accuracy=<VALUE>
changed_factor=lr
saved=experiment_results.csv
<VALUE> 会因 PyTorch 版本和硬件实现略有差异,但两个实验必须使用同一数据划分与种子。生成的 CSV 应包含两行实验记录,且除 name、lr 和最终指标外,其余配置一致。
从结果形成可检验结论
若降低学习率后验证指标提高,不能直接得出“学习率越低越好”。更准确的结论是:在当前模型、数据、训练轮数和随机种子下,0.003 比 0.01 表现更好。下一轮可以继续验证相邻学习率,或增加不同随机种子的重复实验。
单次差异很小可能只是随机波动。关键实验应至少用多个种子重复,并比较均值与波动范围。若训练指标改善但验证指标下降,应优先怀疑过拟合,而不是继续追求更低训练损失。
实验记录至少应保存假设、代码版本、完整配置、数据版本、主指标、辅助指标和结论。只有配置与结果能被重新定位,实验才具备复现价值。
本课总结
- 对照实验的核心是固定基线,每轮只改变一个关键因素
- 结果必须与配置、数据版本和代码版本一起记录
- 小幅提升需要通过重复实验确认,不能把随机波动当成真实改进
下一课预告
下一课将从整体指标转向具体错误样本,按错误类型、置信度和数据切片定位模型真正需要改进的位置。
按自己的节奏,确认真正理解。