
机器学习与深度学习 / 系统课时
微调预训练 Transformer
微调预训练 Transformer
本课把一个预训练中文 Transformer 改造成二分类模型,完整走通分词、动态补齐、分类头、训练、评估和单条推理流程。完成后,你可以把同一结构替换为自己的标注数据集。
学习目标
- 理解预训练编码器与任务分类头的职责分工
- 完成文本分词、批处理、训练与验证评估
- 根据显存、类别数量和数据规模调整关键配置
微调任务的最小闭环
微调不是从零训练语言模型,而是在已有参数上继续优化。文本先经过与预训练模型配套的分词器,转换为 input_ids 和 attention_mask;编码器输出上下文表示,分类头把它映射为类别 logits,再用标签计算交叉熵损失并反向更新参数。
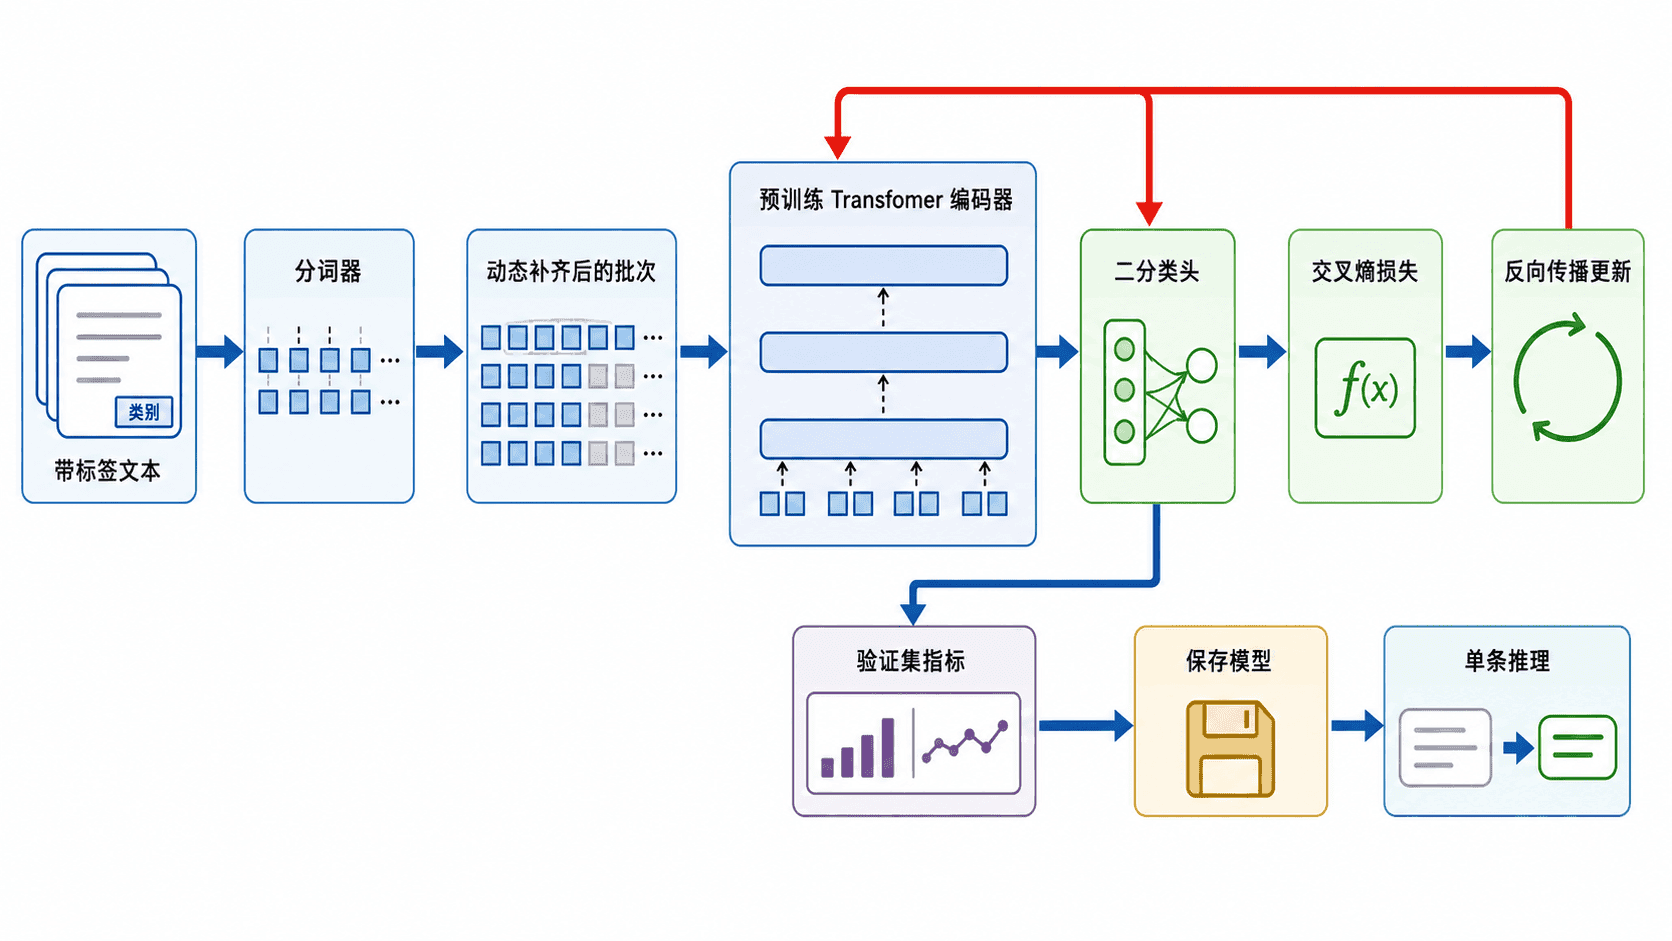
分类头的输出维度必须等于类别数量。二分类任务设置 num_labels=2,模型输出形状为 [批大小, 2]。标签使用从 0 开始的整数,并通过 id2label 与 label2id 固定业务含义,避免训练和推理阶段发生类别映射错位。
准备分词与动态批处理
分词阶段只做截断,不提前把所有样本补到统一最大长度。DataCollatorWithPadding 会在组装每个批次时,把样本补到该批次中最长序列的长度,从而减少无效填充计算。
训练集、验证集和线上推理必须使用同一个模型目录中的分词器。不要自行修改词表顺序,也不要把另一个模型的分词器与当前编码器混用,否则相同词元会被映射到错误的嵌入位置。
完整微调示例
下面使用少量演示数据走通流程。首次运行会下载预训练权重,需要可访问模型仓库的网络环境;真实项目应将演示列表替换为经过清洗、划分且类别分布可检查的数据集。
from typing import Any

import numpy as np
import torch
from torch.utils.data import Dataset
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
    DataCollatorWithPadding,
    Trainer,
    TrainingArguments,
)

MODEL_NAME = "google-bert/bert-base-chinese"

class TextClassificationDataset(Dataset):
    def __init__(
        self,
        texts: list[str],
        labels: list[int],
        tokenizer: Any,
    ) -> None:
        self.encodings = tokenizer(
            texts,
            truncation=True,
            max_length=64,
        )
        self.labels = labels

    def __len__(self) -> int:
        return len(self.labels)

    def __getitem__(self, index: int) -> dict[str, Any]:
        item = {
            key: values[index]
            for key, values in self.encodings.items()
        }
        item["labels"] = self.labels[index]
        return item

def compute_metrics(eval_prediction: Any) -> dict[str, float]:
    logits, labels = eval_prediction
    predictions = np.argmax(logits, axis=-1)
    accuracy = float((predictions == labels).mean())
    return {"accuracy": accuracy}

def main() -> None:
    train_texts = [
        "课程讲解清楚,示例很实用",
        "页面频繁报错,体验很差",
        "内容结构合理,学完有收获",
        "步骤缺失,代码无法运行",
        "模型效果稳定,部署顺利",
        "说明太模糊,找不到关键配置",
        "练习难度合适,反馈及时",
        "数据有误,结果不可信",
    ]
    train_labels = [1, 0, 1, 0, 1, 0, 1, 0]

    eval_texts = [
        "示例完整,能够直接复现",
        "接口一直失败,没有解决方案",
        "讲解简洁而且重点明确",
        "训练结果与说明不一致",
    ]
    eval_labels = [1, 0, 1, 0]

    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
    train_dataset = TextClassificationDataset(
        train_texts,
        train_labels,
        tokenizer,
    )
    eval_dataset = TextClassificationDataset(
        eval_texts,
        eval_labels,
        tokenizer,
    )
    data_collator = DataCollatorWithPadding(
        tokenizer=tokenizer,
        return_tensors="pt",
    )

    id2label = {0: "NEGATIVE", 1: "POSITIVE"}
    label2id = {"NEGATIVE": 0, "POSITIVE": 1}
    model = AutoModelForSequenceClassification.from_pretrained(
        MODEL_NAME,
        num_labels=2,
        id2label=id2label,
        label2id=label2id,
    )

    training_args = TrainingArguments(
        output_dir="./sentiment-model",
        learning_rate=2e-5,
        per_device_train_batch_size=4,
        per_device_eval_batch_size=4,
        num_train_epochs=1,
        weight_decay=0.01,
        eval_strategy="epoch",
        save_strategy="no",
        logging_strategy="no",
        report_to="none",
        seed=42,
    )

    trainer = Trainer(
        model=model,
        args=training_args,
        train_dataset=train_dataset,
        eval_dataset=eval_dataset,
        processing_class=tokenizer,
        data_collator=data_collator,
        compute_metrics=compute_metrics,
    )

    sample_batch = data_collator(
        [train_dataset[0], train_dataset[1]]
    )
    print("batch size:", sample_batch["input_ids"].shape[0])
    print("num labels:", model.config.num_labels)

    trainer.train()
    metrics = trainer.evaluate()
    print("accuracy available:", "eval_accuracy" in metrics)

    inputs = tokenizer(
        "这节课的示例很容易理解",
        return_tensors="pt",
        truncation=True,
        max_length=64,
    )
    model.eval()
    with torch.no_grad():
        predicted_id = int(model(**inputs).logits.argmax(dim=-1).item())
    print("prediction:", model.config.id2label[predicted_id])

if __name__ == "__main__":
    main()
预期输出:
batch size: 2
num labels: 2
accuracy available: True
prediction: <NEGATIVE_OR_POSITIVE>
最后一行取决于微调后的参数、运行设备和软件版本,实际值可能不同;它应当是 NEGATIVE 或 POSITIVE 之一。训练过程还可能输出进度条,但不影响上述验收项。
训练与评估要看什么
训练损失下降只说明模型更贴合训练数据,不能替代验证集指标。分类任务至少应记录验证损失和准确率;类别明显不平衡时,还应增加精确率、召回率和 F1,并查看每个类别的样本量与混淆情况。
学习率通常应小于从零训练分类器时的取值,因为预训练参数已经包含通用语言知识。显存不足时,优先缩短最大序列长度、减小单卡批大小或使用梯度累积,而不是直接删除注意力掩码或随机裁掉关键文本。
验收与常见问题
运行完成后,至少确认批次大小为 2、分类头类别数为 2、评估结果包含 eval_accuracy,并且推理标签来自配置中的两个标签之一。真实项目还应保存模型与分词器,并用独立测试集做最终验收。
如果出现分类头权重重新初始化的提示,这是因为预训练模型原本没有当前任务的二分类头,属于正常现象;该部分参数会在微调中学习。若训练损失不变,应先检查标签是否为整数、数据是否包含 labels 字段,以及优化步骤是否真的执行。
本课总结
- 微调闭环由配套分词器、动态批处理、预训练编码器、任务分类头和验证指标组成。
num_labels、标签整数和双向映射必须保持一致,训练集与验证集不能混用。- 评估应关注独立验证数据,显存问题应通过序列长度、批大小和梯度策略处理。
下一课预告
下一课将进一步讨论 Transformer 在推理阶段的性能优化,包括批量推理、混合精度、模型压缩与延迟评估。