
机器学习与深度学习 / 系统课时
记录指标与可视化
记录指标与可视化
只在终端打印最后一次损失,无法判断训练是否稳定,也无法比较两次实验的差异。本课将建立统一的指标记录格式,同时采集损失、学习率、验证准确率、CPU、内存和 GPU 显存,并把多次运行绘制为可比较曲线。
学习目标
- 能区分训练指标、评估指标和资源指标
- 能把每轮指标写入结构稳定的 CSV 文件
- 能基于多个实验日志生成可比较曲线
指标记录的最小闭环
可靠的记录链路应包含四个环节:训练循环产生数值,记录器补充时间与资源信息,持久化层写入实验目录,可视化程序再按相同字段读取多个运行。只画图而不保存原始数据,会让后续复查和二次分析变得困难。
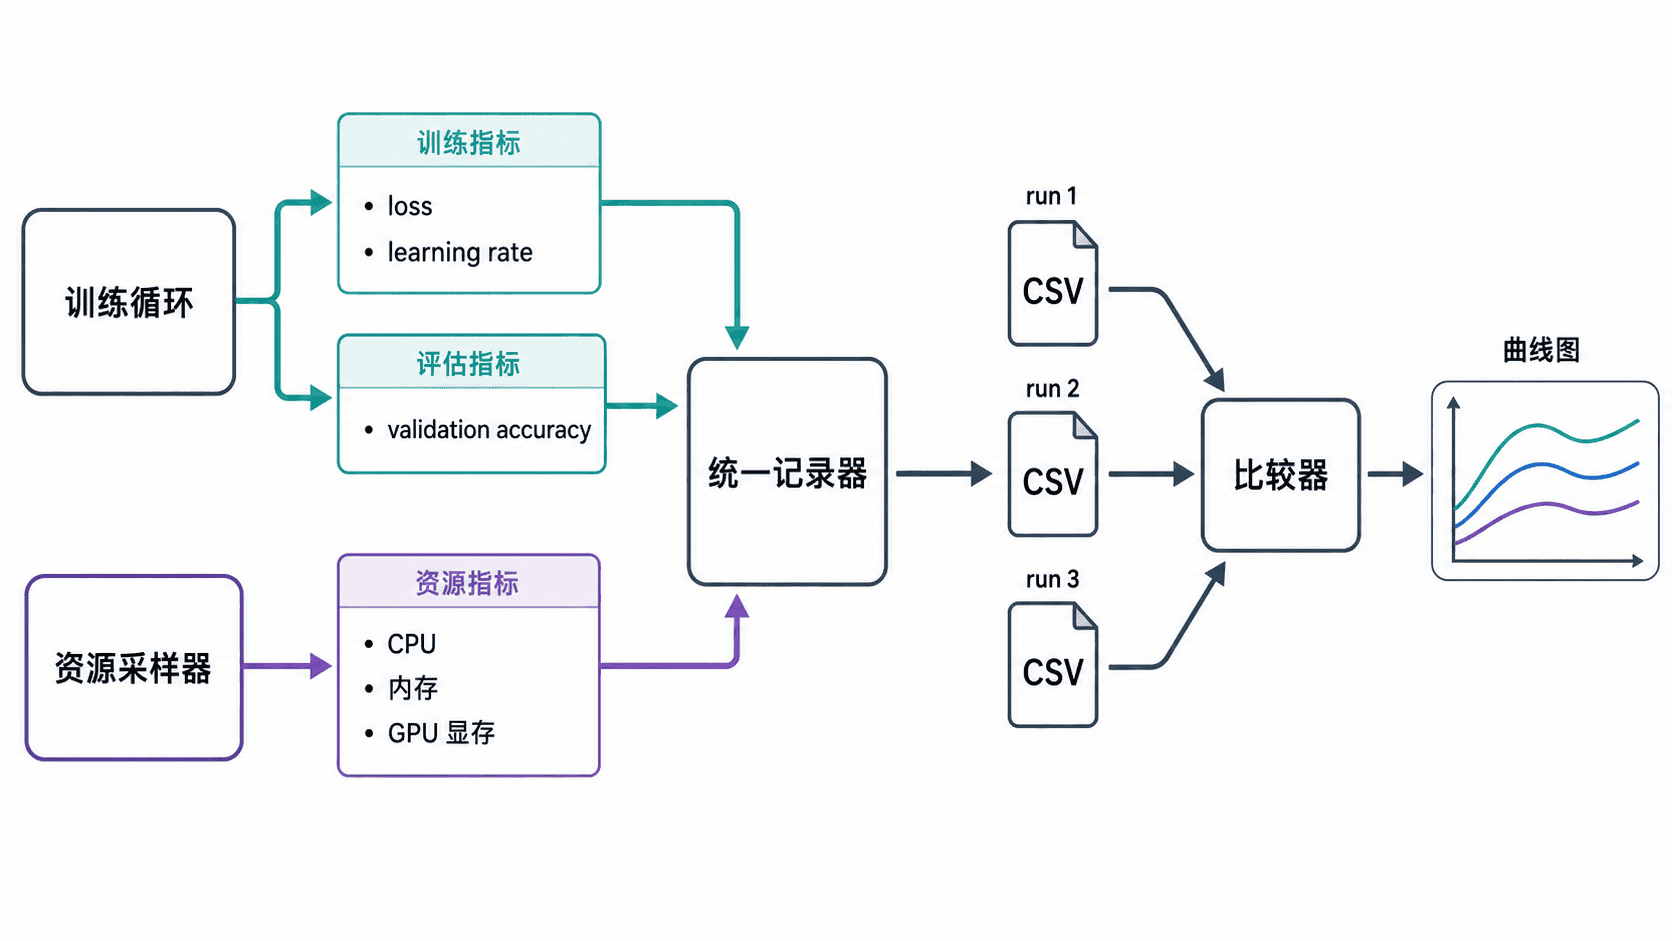
每条记录至少需要运行名称、轮次和指标值。时间戳适合审计,轮次或全局步数适合横向对齐。不同实验若使用不同字段名、不同单位或不同采样频率,即使都生成了图,也很难进行公平比较。
统一字段与采样时机
训练指标应在固定粒度上聚合,例如每轮平均损失;评估指标应在 model.eval() 与禁用梯度的环境中计算;资源指标应明确采样时机。下面的字段足以覆盖一个小型实验:
| 字段 | 含义 | 记录时机 |
|---|---|---|
train_loss |
当前轮平均训练损失 | 一轮训练结束后 |
val_accuracy |
验证集准确率 | 当前轮评估结束后 |
learning_rate |
优化器当前学习率 | 调度器更新前 |
cpu_percent |
进程采样时的 CPU 使用率 | 每轮记录时 |
memory_mb |
当前进程常驻内存 | 每轮记录时 |
cuda_memory_mb |
GPU 峰值显存 | 每轮记录时 |
资源指标容易波动,不应仅凭单个采样点下结论。生产实验通常会按更短间隔采样,再计算平均值、峰值或分位数;本课使用每轮一次的简化方案,重点是建立一致的数据结构。
实现记录与对比脚本
先安装示例依赖:
python -m pip install torch matplotlib psutil预期结果:
Successfully installed <PACKAGE_LIST><PACKAGE_LIST> 取决于当前环境。下面的 metrics_demo.py 会运行两个学习率不同的实验,每个实验生成一份 CSV,最后绘制损失、准确率、学习率和内存曲线。
import csv
from pathlib import Path
from typing import Any

import matplotlib.pyplot as plt
import psutil
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

ARTIFACT_DIR = Path("artifacts")
FIELDNAMES = [
    "run_name",
    "epoch",
    "train_loss",
    "val_accuracy",
    "learning_rate",
    "cpu_percent",
    "memory_mb",
    "cuda_memory_mb",
]

def make_dataset(seed: int) -> tuple[TensorDataset, TensorDataset]:
    generator = torch.Generator().manual_seed(seed)
    features = torch.randn(800, 8, generator=generator)
    labels = (features[:, 0] - 0.7 * features[:, 1] > 0).long()
    # 固定切分位置,让两个实验使用完全相同的训练集和验证集。
    return (
        TensorDataset(features[:640], labels[:640]),
        TensorDataset(features[640:], labels[640:]),
    )

def build_model() -> nn.Module:
    return nn.Sequential(
        nn.Linear(8, 16),
        nn.ReLU(),
        nn.Linear(16, 2),
    )

def evaluate(
    model: nn.Module,
    loader: DataLoader,
    device: torch.device,
) -> float:
    model.eval()
    correct = 0
    total = 0
    # 评估阶段关闭梯度,并确保数据与模型位于同一设备。
    with torch.no_grad():
        for features, labels in loader:
            features = features.to(device)
            labels = labels.to(device)
            predictions = model(features).argmax(dim=1)
            correct += (predictions == labels).sum().item()
            total += labels.numel()
    return correct / total

def collect_resources(process: psutil.Process) -> tuple[float, float, float]:
    cpu_percent = process.cpu_percent(interval=None)
    memory_mb = process.memory_info().rss / 1024 / 1024
    cuda_memory_mb = 0.0
    if torch.cuda.is_available():
        cuda_memory_mb = torch.cuda.max_memory_allocated() / 1024 / 1024
    return cpu_percent, memory_mb, cuda_memory_mb

def write_metrics(path: Path, rows: list[dict[str, Any]]) -> None:
    with path.open("w", newline="", encoding="utf-8") as file:
        writer = csv.DictWriter(file, fieldnames=FIELDNAMES)
        writer.writeheader()
        writer.writerows(rows)

def run_experiment(run_name: str, learning_rate: float) -> Path:
    torch.manual_seed(42)
    train_set, val_set = make_dataset(seed=42)
    train_loader = DataLoader(train_set, batch_size=64, shuffle=True)
    val_loader = DataLoader(val_set, batch_size=128)

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model = build_model().to(device)
    optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)
    scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=2, gamma=0.5)
    criterion = nn.CrossEntropyLoss()
    process = psutil.Process()
    process.cpu_percent(interval=None)

    rows: list[dict[str, Any]] = []
    for epoch in range(1, 5):
        model.train()
        total_loss = 0.0
        if torch.cuda.is_available():
            torch.cuda.reset_peak_memory_stats()

        for features, labels in train_loader:
            features = features.to(device)
            labels = labels.to(device)
            optimizer.zero_grad()
            loss = criterion(model(features), labels)
            loss.backward()
            optimizer.step()
            total_loss += loss.item() * features.size(0)

        average_loss = total_loss / len(train_set)
        val_accuracy = evaluate(model, val_loader, device)
        current_lr = optimizer.param_groups[0]["lr"]
        cpu_percent, memory_mb, cuda_memory_mb = collect_resources(process)

        # 每轮只写一条聚合记录,保证不同运行拥有相同采样粒度。
        rows.append(
            {
                "run_name": run_name,
                "epoch": epoch,
                "train_loss": f"{average_loss:.6f}",
                "val_accuracy": f"{val_accuracy:.6f}",
                "learning_rate": f"{current_lr:.6f}",
                "cpu_percent": f"{cpu_percent:.2f}",
                "memory_mb": f"{memory_mb:.2f}",
                "cuda_memory_mb": f"{cuda_memory_mb:.2f}",
            }
        )
        scheduler.step()

    # 每个运行独立保存,避免后一次实验覆盖前一次原始指标。
    output_path = ARTIFACT_DIR / f"{run_name}.csv"
    write_metrics(output_path, rows)
    return output_path

def read_metrics(path: Path) -> list[dict[str, float | str]]:
    with path.open("r", encoding="utf-8") as file:
        result: list[dict[str, float | str]] = []
        for row in csv.DictReader(file):
            result.append(
                {
                    "run_name": row["run_name"],
                    "epoch": float(row["epoch"]),
                    "train_loss": float(row["train_loss"]),
                    "val_accuracy": float(row["val_accuracy"]),
                    "learning_rate": float(row["learning_rate"]),
                    "memory_mb": float(row["memory_mb"]),
                }
            )
        return result

def plot_comparison(paths: list[Path]) -> Path:
    figure, axes = plt.subplots(2, 2, figsize=(11, 7))
    metric_specs = [
        ("train_loss", "Train Loss"),
        ("val_accuracy", "Validation Accuracy"),
        ("learning_rate", "Learning Rate"),
        ("memory_mb", "Process Memory (MB)"),
    ]

    for path in paths:
        # 比较器只依赖统一 CSV 字段,不需要了解训练代码内部实现。
        rows = read_metrics(path)
        epochs = [row["epoch"] for row in rows]
        for axis, (field, title) in zip(axes.flat, metric_specs):
            axis.plot(
                epochs,
                [row[field] for row in rows],
                marker="o",
                label=str(rows[0]["run_name"]),
            )
            axis.set_title(title)
            axis.set_xlabel("Epoch")
            axis.legend()

    figure.tight_layout()
    output_path = ARTIFACT_DIR / "comparison.png"
    figure.savefig(output_path, dpi=150)
    plt.close(figure)
    return output_path

def main() -> None:
    ARTIFACT_DIR.mkdir(parents=True, exist_ok=True)
    csv_paths = [
        run_experiment("baseline", learning_rate=0.05),
        run_experiment("lower-lr", learning_rate=0.01),
    ]
    chart_path = plot_comparison(csv_paths)

    for path in csv_paths:
        print(f"saved_metrics={path}")
    print(f"saved_chart={chart_path}")

if __name__ == "__main__":
    main()
这段代码是完整示例。CPU 百分比是瞬时采样值,首次有效采样可能接近 0;若没有可用 CUDA,cuda_memory_mb 会记录为 0。真实项目还应记录代码版本、配置快照和数据版本,才能把曲线与实验上下文对应起来。
运行并检查实验产物
执行脚本:
python metrics_demo.py预期输出:
saved_metrics=artifacts/baseline.csv
saved_metrics=artifacts/lower-lr.csv
saved_chart=artifacts/comparison.png
打开任一 CSV,应看到 4 行轮次记录以及固定表头;打开 comparison.png,应看到两个运行在四个指标上的对比曲线。数值会因 PyTorch 版本、操作系统和硬件不同而变化,但文件数量、字段名称和轮次数应保持一致。
解读曲线而不是只看终点
损失持续下降而验证准确率停滞,可能说明模型正在拟合训练集但泛化没有继续改善。学习率发生阶梯变化后,损失曲线也应出现相应响应;若完全没有变化,需要检查调度器调用顺序和优化器参数组。
资源曲线主要用于发现异常趋势。内存随轮次持续增长,可能存在张量、计算图或日志对象未释放;GPU 峰值显存突然升高,通常与批大小、输入尺寸或评估阶段没有关闭梯度有关。单点偏高不一定是故障,应结合多轮趋势和可重复实验判断。
常见记录错误
- 只保存图片,不保存原始指标,导致无法重新绘图或更换聚合方式
- 把每个批次损失直接与每轮平均损失比较,造成横轴粒度不一致
- 不记录运行名称、配置和代码版本,使曲线无法追溯到具体实验
本课总结
- 可比较实验需要统一字段、单位、采样粒度和输出目录
- 原始指标文件是事实来源,曲线只是其可视化结果
- 损失、评估指标和资源指标应结合趋势一起解释
下一课预告
下一课将继续完善实验管理,学习如何保存检查点、恢复训练,并确保模型权重、优化器状态和配置能够一致恢复。