
机器学习与深度学习 / 系统课时
课程环境与项目路线
课程环境与项目路线
本课将完成深度学习课程的起步准备:检查 Python 与基础工具、创建隔离环境、验证 PyTorch 是否可用,并明确从基础张量到完整项目的学习路线。完成后,你将拥有一个可运行、可验证、便于后续扩展的实践环境。
学习目标
- 完成 Python、虚拟环境和 PyTorch 的基础检查
- 根据 CPU 或 GPU 条件选择合适的实践方式
- 理解课程项目的阶段划分与验收标准
前置能力与硬件要求
开始课程前,应能阅读基础 Python 语法,理解变量、函数、列表、字典、循环和模块导入。暂时不会面向对象或装饰器并不影响起步,但需要具备独立运行脚本和定位基础报错的能力。
硬件方面,普通 CPU 电脑足以完成张量操作、线性回归、小型分类和推理示例。独立 GPU 能明显缩短卷积网络和较大数据集的训练时间,但不是开始学习的必要条件。前几阶段优先保证环境稳定,再决定是否迁移到 GPU。
建议至少准备一个代码编辑器、可用的 Python 解释器和稳定的磁盘空间。训练数据、虚拟环境和模型文件应放在独立项目目录中,避免与系统 Python 或其他项目依赖混用。
创建并验证项目环境
在空目录中创建项目,然后建立虚拟环境。下面以 macOS 或 Linux 终端为例;Windows PowerShell 可把激活命令替换为 .venv\Scripts\Activate.ps1。
mkdir deep-learning-course
cd deep-learning-course
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install torch torchvision
预期结果:
虚拟环境成功激活,pip 完成升级,torch 与 torchvision 安装完成。
具体下载进度、版本号和缓存路径会因系统而不同。
不要直接依据显卡型号拼接第三方安装地址。需要 GPU 加速时,应先确认驱动与运行时兼容关系,再使用 PyTorch 官方安装选择器生成对应命令;课程初期使用 CPU 版本也能完成主要练习。
新建 check_env.py,用一个脚本同时验证 Python、PyTorch、张量计算和可用设备。
import platform
import torch

def main() -> None:
    device = "cuda" if torch.cuda.is_available() else "cpu"
    x = torch.tensor([1.0, 2.0, 3.0], device=device)
    y = x * 2

    print(f"python={platform.python_version()}")
    print(f"torch={torch.__version__}")
    print(f"device={device}")
    print(f"result={y.cpu().tolist()}")

if __name__ == "__main__":
    main()
运行验证:
python check_env.py预期输出:
python=<VERSION>
torch=<VERSION>
device=cpu
result=[2.0, 4.0, 6.0]
若设备显示为 cuda 也属于正常结果。<VERSION> 会随本机安装版本变化;关键验收点是脚本无异常结束,且计算结果为 [2.0, 4.0, 6.0]。
推荐目录结构
课程项目应从第一天就区分代码、数据、模型和输出,避免所有文件堆在根目录。下面的结构足以支撑前期练习和后续小型项目。
deep-learning-course/
├── .venv/
├── data/
├── models/
├── outputs/
├── src/
│   └── check_env.py
├── requirements.txt
└── README.md
.venv 保存隔离依赖,data 放数据集,models 放训练权重,outputs 放日志、图表和预测结果,src 放可执行代码。后续使用 Git 时通常不提交 .venv、大数据集和大型模型文件。
项目路线与阶段成果
课程实践按“张量基础—模型训练—视觉任务—工程交付”推进。每个阶段都要留下可运行代码、可复现结果和一份简短记录,而不是只看完概念。
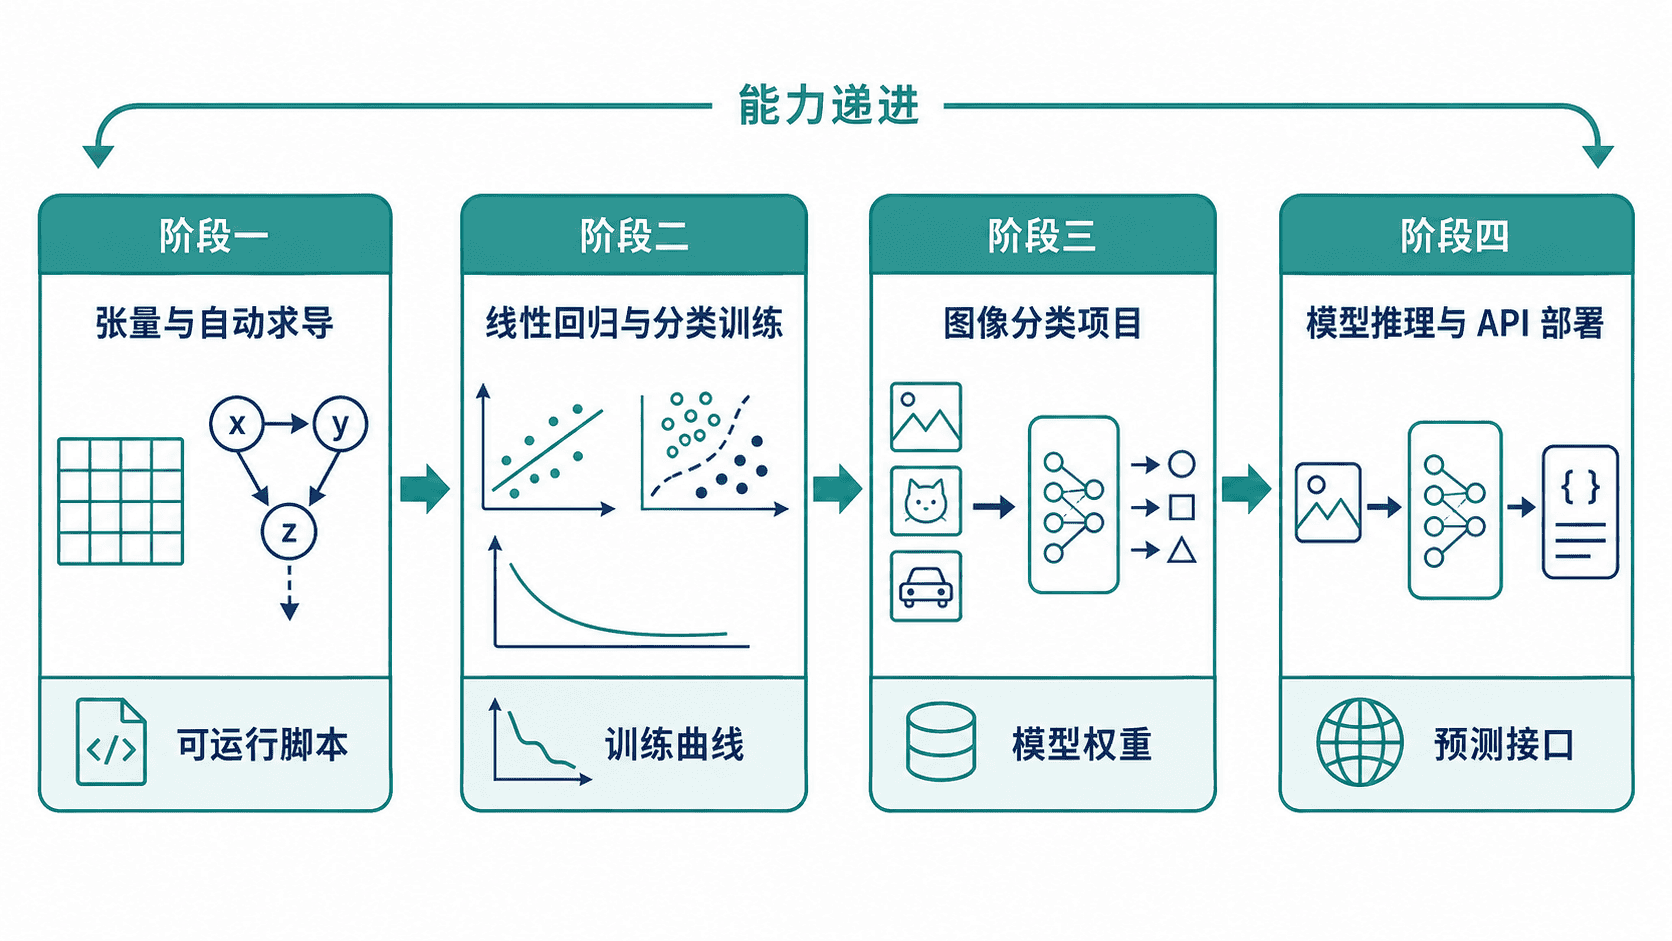
第一阶段完成张量创建、形状变换、广播和自动求导,验收产物是一组能够独立运行的小脚本。第二阶段手写训练循环,完成数据读取、前向计算、损失、反向传播和参数更新。
第三阶段实现一个小型图像分类项目,至少包含训练集与验证集、模型保存、指标记录和单张图片预测。第四阶段把模型整理为独立推理模块,再包装成简单接口,检查输入校验、响应时间、日志和错误处理。
这条路线的核心不是追求大型模型,而是反复走通“定义问题—准备数据—训练模型—评估结果—保存模型—执行推理—交付应用”的完整闭环。
典型失败与处理顺序
若命令提示找不到 python3,先检查 Python 是否已安装以及解释器是否加入环境变量。若虚拟环境无法激活,确认当前终端类型和激活脚本路径,不要在不同 Shell 中照搬同一条命令。
若 import torch 失败,先确认终端已经激活 .venv,再执行 python -m pip show torch。若安装成功但 GPU 不可用,先用 CPU 继续课程,同时检查显卡驱动、PyTorch 构建版本和运行时兼容性。
若脚本能运行但编辑器仍标红,通常是编辑器选择了错误的 Python 解释器。把解释器切换到项目 .venv 后重新加载项目即可。
本课总结
- CPU 环境足以完成课程前期实践,GPU 是加速选项而不是入门门槛
- 虚拟环境、依赖验证和清晰目录结构是后续项目可复现的基础
- 学习路线应以可运行产物和阶段验收为主,最终走通训练、推理与部署闭环
下一课预告
下一课将正式进入张量与计算图,学习深度学习框架如何表示数据、记录运算并为后续梯度计算做准备。