
机器学习与深度学习 / 系统课时
构建基线与数据审计
构建基线与数据审计
本课先建立一个能够完整跑通训练与评估链路的最小基线,再按固定顺序检查标签、类别分布、重复样本、跨集合泄漏和异常值,最终得到一份可复现的数据质量结论,而不是直接在未知数据上堆叠复杂模型。
学习目标
- 理解基线模型在项目排错和效果比较中的作用
- 按顺序审计标签、分布、重复、泄漏与异常样本
- 根据审计结果决定修复、剔除、重标或重新切分数据
先建立可运行基线
基线的首要目标不是获得最高分,而是证明数据读取、特征处理、训练、预测和评估能够闭环运行。对于分类任务,可以先使用多数类、线性模型或小型网络;对于回归任务,可以先使用均值预测或线性回归。
一个合格基线必须固定数据版本、随机种子、切分方式、评估指标和运行命令。只有这些条件稳定,后续更换模型或特征时,指标差异才有解释价值。若基线都无法重复得到相同结果,应先排查数据和流程,而不是继续调参。
按固定顺序审计数据
数据审计应从最容易破坏训练正确性的项目开始:先检查标签缺失和非法值,再看类别分布,然后检查集合内重复、训练集与验证集之间的重复,最后检查长度、数值范围和文件完整性等异常。
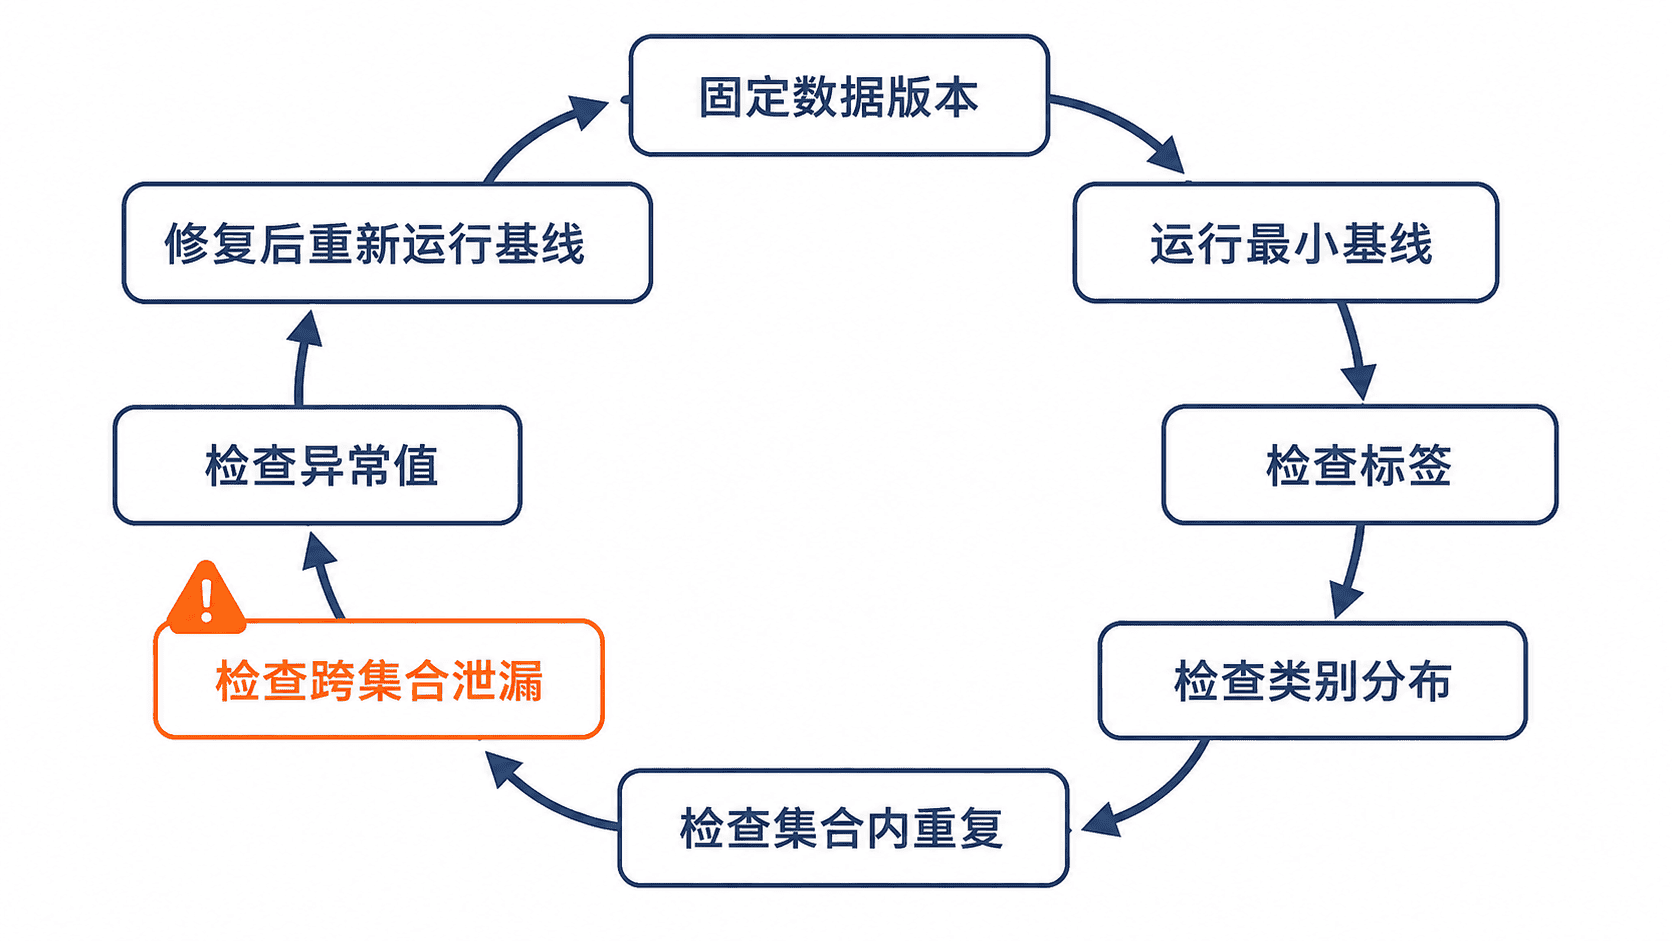
下面的完整示例使用少量内存数据演示多数类基线和五项审计。样本指纹只使用内容与标签,故即使样本 ID 不同,也能发现重复和跨集合泄漏。
from collections import Counter

train = [
    {"id": "tr-1", "text": "good", "label": 1, "length": 4},
    {"id": "tr-2", "text": "bad", "label": 0, "length": 3},
    {"id": "tr-3", "text": "good", "label": 1, "length": 4},
    {"id": "tr-4", "text": "unknown", "label": None, "length": -1},
]

valid = [
    {"id": "va-1", "text": "good", "label": 1, "length": 4},
    {"id": "va-2", "text": "ok", "label": 0, "length": 2},
]

labeled_train = [row for row in train if row["label"] is not None]
label_counts = Counter(row["label"] for row in labeled_train)
majority_class = label_counts.most_common(1)[0][0]

labeled_valid = [row for row in valid if row["label"] is not None]
correct = sum(row["label"] == majority_class for row in labeled_valid)
baseline_accuracy = correct / len(labeled_valid)

def fingerprint(row):
    # 不使用样本 ID,避免同内容换 ID 后逃过重复检查
    return row["text"], row["label"]

train_fingerprints = Counter(fingerprint(row) for row in train)
valid_fingerprints = {fingerprint(row) for row in valid}

missing_labels = sum(row["label"] is None for row in train)
train_duplicate_rows = sum(count - 1 for count in train_fingerprints.values() if count > 1)
cross_split_duplicates = len(set(train_fingerprints) & valid_fingerprints)
abnormal_lengths = [
    row["id"] for row in train + valid
    if row["length"] < 0 or row["length"] > 1000
]

print(f"majority_class={majority_class}")
print(f"baseline_accuracy={baseline_accuracy:.2f}")
print(f"label_distribution={dict(label_counts)}")
print(f"missing_labels={missing_labels}")
print(f"train_duplicate_rows={train_duplicate_rows}")
print(f"cross_split_duplicates={cross_split_duplicates}")
print(f"abnormal_lengths={abnormal_lengths}")
预期输出
majority_class=1
baseline_accuracy=0.50
label_distribution={1: 2, 0: 1}
missing_labels=1
train_duplicate_rows=1
cross_split_duplicates=1
abnormal_lengths=['tr-4']
输出表明该数据不能直接用于正式训练:存在缺失标签、训练集内重复、跨集合重复和非法长度。此时基线准确率只是管线检查结果,不能作为模型能力结论。
根据问题类型执行修复
不同问题需要不同处理,不能统一删除。缺失标签可以回到标注系统补标,无法确认时再剔除;少数类样本应先确认是真实业务分布还是采样不足,再决定重采样、加权或补充数据。
| 审计问题 | 推荐处理 | 修复后验证 |
|---|---|---|
| 标签缺失或非法 | 补标、纠错或剔除 | 缺失数为 0,标签集合合法 |
| 集合内重复 | 按业务主键或内容指纹去重 | 重复数符合预期 |
| 跨集合重复 | 先按实体分组,再重新切分 | 交集为 0 |
| 极端长度或数值 | 核对源数据并设置边界 | 异常样本有明确处置 |
| 类别严重失衡 | 分层切分、加权或补样 | 各集合分布可解释 |
跨集合重复尤其危险,因为模型可能在验证阶段看到训练过的内容,产生虚高指标。文本任务可用规范化文本哈希,图像任务可用感知哈希,用户级任务则应优先按用户或实体分组切分。
形成可复现的审计结论
审计报告至少记录数据版本、样本总数、各集合规模、标签分布、重复数、泄漏数、异常数、处理规则和处理后的新版本。不要只保留“已清洗”结论,否则后续无法判断指标变化来自模型还是数据。
修复完成后,应使用同一基线、同一指标和同一运行环境重新评估。只有审计结果通过且基线可重复,才进入特征工程、网络结构优化或超参数搜索阶段。
本课总结
- 最小基线先验证端到端链路,再作为后续改进的稳定参照
- 数据审计应优先检查标签、分布、重复、跨集合泄漏和异常值
- 每次修复都要生成新数据版本,并用同一基线重新验证
下一课预告
下一课将基于已通过审计的数据设计训练、验证与测试切分策略,并处理分层采样、实体隔离和时间泄漏等问题。