
机器学习与深度学习 / 系统课时
激活函数的作用
激活函数的作用
本课解决一个关键问题:为什么神经网络不能只不断叠加线性层。你将通过公式、函数曲线和选型规则,理解 Sigmoid、Tanh、ReLU、GELU 如何改变信号与梯度,并能根据隐藏层或输出层的任务选择合适函数。
学习目标
- 解释激活函数为神经网络引入非线性的原因
- 比较 Sigmoid、Tanh、ReLU、GELU 的输出范围与梯度特性
- 根据具体网络位置选择合适的激活函数
为什么线性层之间需要激活函数
假设两层网络都只做线性变换:
代入后可得 ,结果仍是一次线性变换。无论堆叠多少层,只要中间没有非线性激活,整个网络都无法表示弯曲的分类边界或更复杂的输入输出关系。
激活函数会对每个神经元的线性结果进行非线性变换,使不同层能够逐步组合出更复杂的特征。它不仅改变输出范围,也会直接影响梯度传播速度、训练稳定性和计算成本。
四种常见激活函数
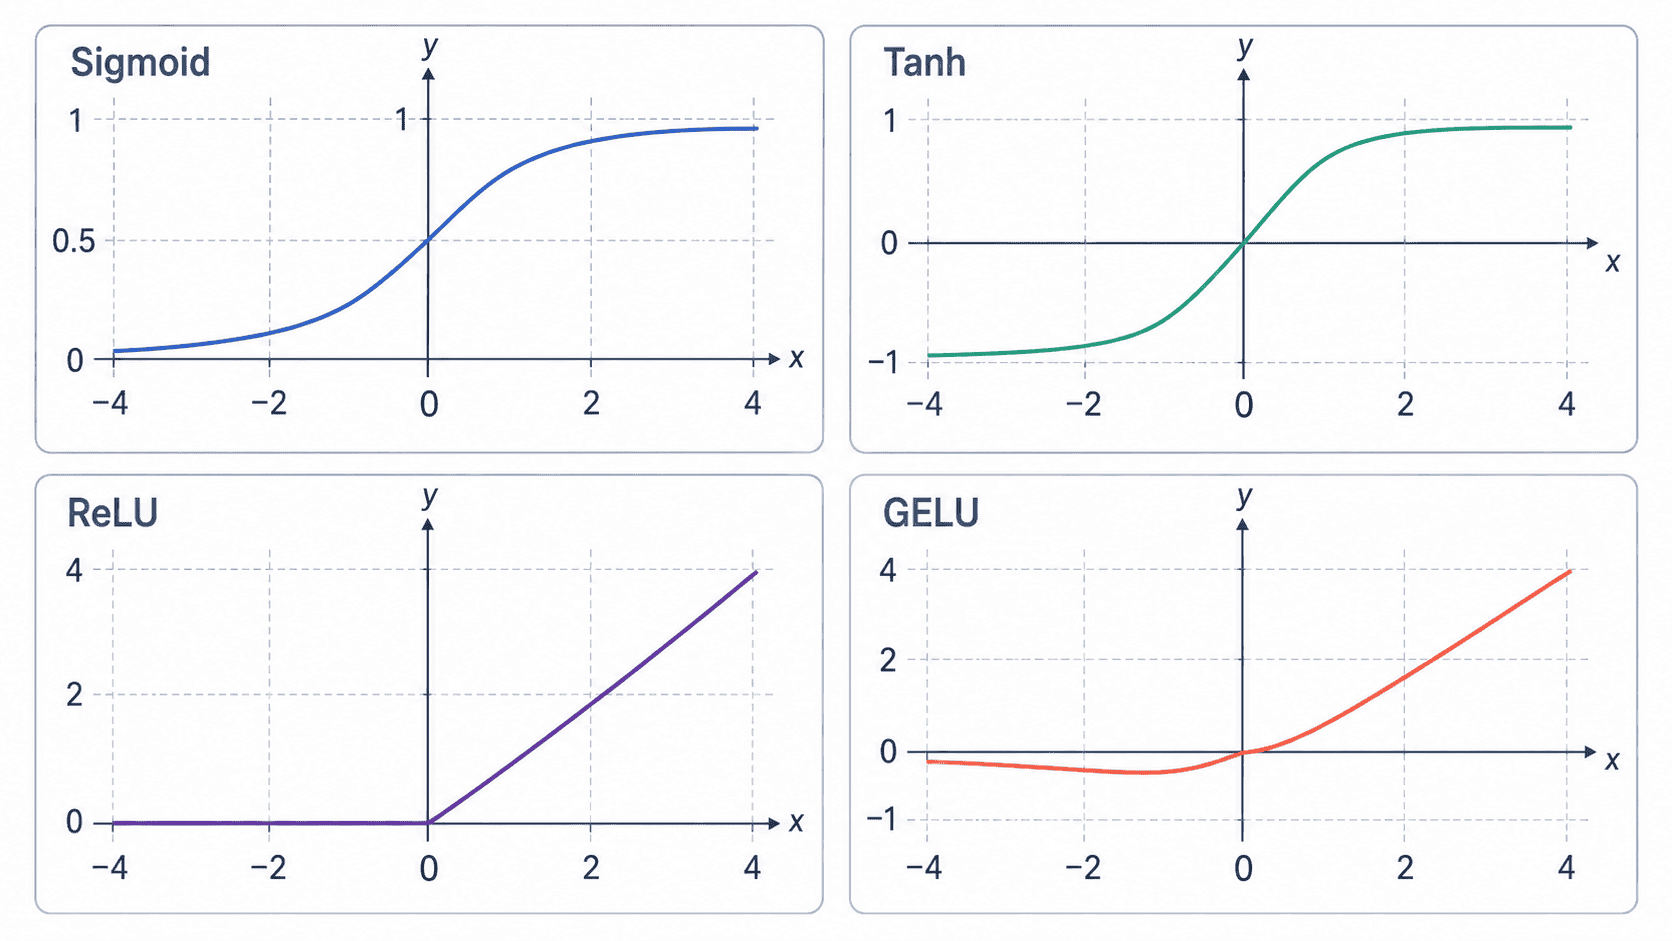
| 函数 | 主要特性 | 优点 | 局限 |
|---|---|---|---|
| Sigmoid | 输出范围为 | 可解释为概率,适合二分类输出层 | 大正值或大负值区域梯度接近 0 |
| Tanh | 输出范围为 ,以 0 为中心 | 比 Sigmoid 更利于表示正负信号 | 仍存在饱和与梯度变小问题 |
| ReLU | 时输出 ,否则输出 0 | 计算简单,正区间梯度稳定 | 负区间梯度为 0,可能出现“死亡神经元” |
| GELU | 按输入大小进行平滑门控 | 曲线平滑,常用于 Transformer | 计算比 ReLU 更复杂 |
Sigmoid 和 Tanh 都会在输入绝对值较大时进入饱和区,此时输出变化很小,反向传播的梯度也会变弱。ReLU 避免了正区间饱和,因此长期以来是隐藏层的常用默认选择。GELU 不会像 ReLU 那样直接截断所有负值,而是平滑地保留一部分负输入。
激活函数怎样影响训练
训练神经网络时,参数更新依赖梯度。如果激活函数在大量输入区域的导数接近 0,梯度经过多层传播后可能越来越小,前面层的参数就难以有效更新,这就是梯度消失的一种来源。
ReLU 在正区间的导数为 1,有利于深层网络传播梯度,但如果某个神经元长期落在负区间,它的输出和梯度都可能持续为 0。GELU 的平滑过渡减少了这种突然截断,更适合对训练稳定性要求较高的大型模型。
如何选择激活函数
隐藏层没有统一的绝对最佳答案。普通多层感知机或卷积网络通常先尝试 ReLU;Transformer 结构常见 GELU;当中间状态需要被限制在正负有限范围时,可考虑 Tanh。
输出层应由任务决定。二分类通常使用 Sigmoid,把一个数映射为正类概率;互斥的多分类通常使用 Softmax;回归任务若目标值没有固定范围,输出层往往不加激活函数。选型时必须区分“隐藏层特征变换”和“输出层结果约束”这两个目的。
常见误区
- 激活函数不是越复杂越好,计算成本和梯度性质同样重要
- ReLU 输出不受上界限制,不适合直接表示概率
- Sigmoid 适合二分类输出层,但通常不是深层隐藏层的首选
本课总结
- 没有非线性激活,多层线性网络仍等价于单层线性模型
- Sigmoid、Tanh、ReLU、GELU 的核心差异在输出范围、梯度和计算方式
- 隐藏层关注特征学习与梯度传播,输出层应匹配具体任务
下一课预告
下一课将把多个神经元组织成输入层、隐藏层和输出层,完整走一遍多层神经网络的前向传播过程。