
机器学习与深度学习 / 系统课时
图像数据管线
图像数据管线
本课将把磁盘中的分类图片变成模型可直接消费的批次张量,并完成尺寸变换、归一化、类别编号和可视化检查。最终会得到一个可运行的 ImageFolder + DataLoader 管线,以及一张用于确认标签和像素是否正确的批次预览图。
学习目标
- 使用
ImageFolder按目录名建立类别映射并读取图像 - 通过变换链统一尺寸、增强样本并完成张量归一化
- 检查批次形状、标签范围和反归一化后的可视化结果
从目录结构建立类别映射
图像分类最常见的组织方式是“一个类别一个子目录”。ImageFolder 会按子目录名称的字典序生成整数标签,因此类别编号不是手写常量,而是由数据目录决定。
data/train/
├── cat/
│   ├── cat_0.png
│   └── cat_1.png
└── dog/
    ├── dog_0.png
    └── dog_1.png
读取后应立即检查 class_to_idx。训练、验证和推理阶段必须使用同一套映射,否则模型输出编号与业务类别名称会错位。
管线中的数据流
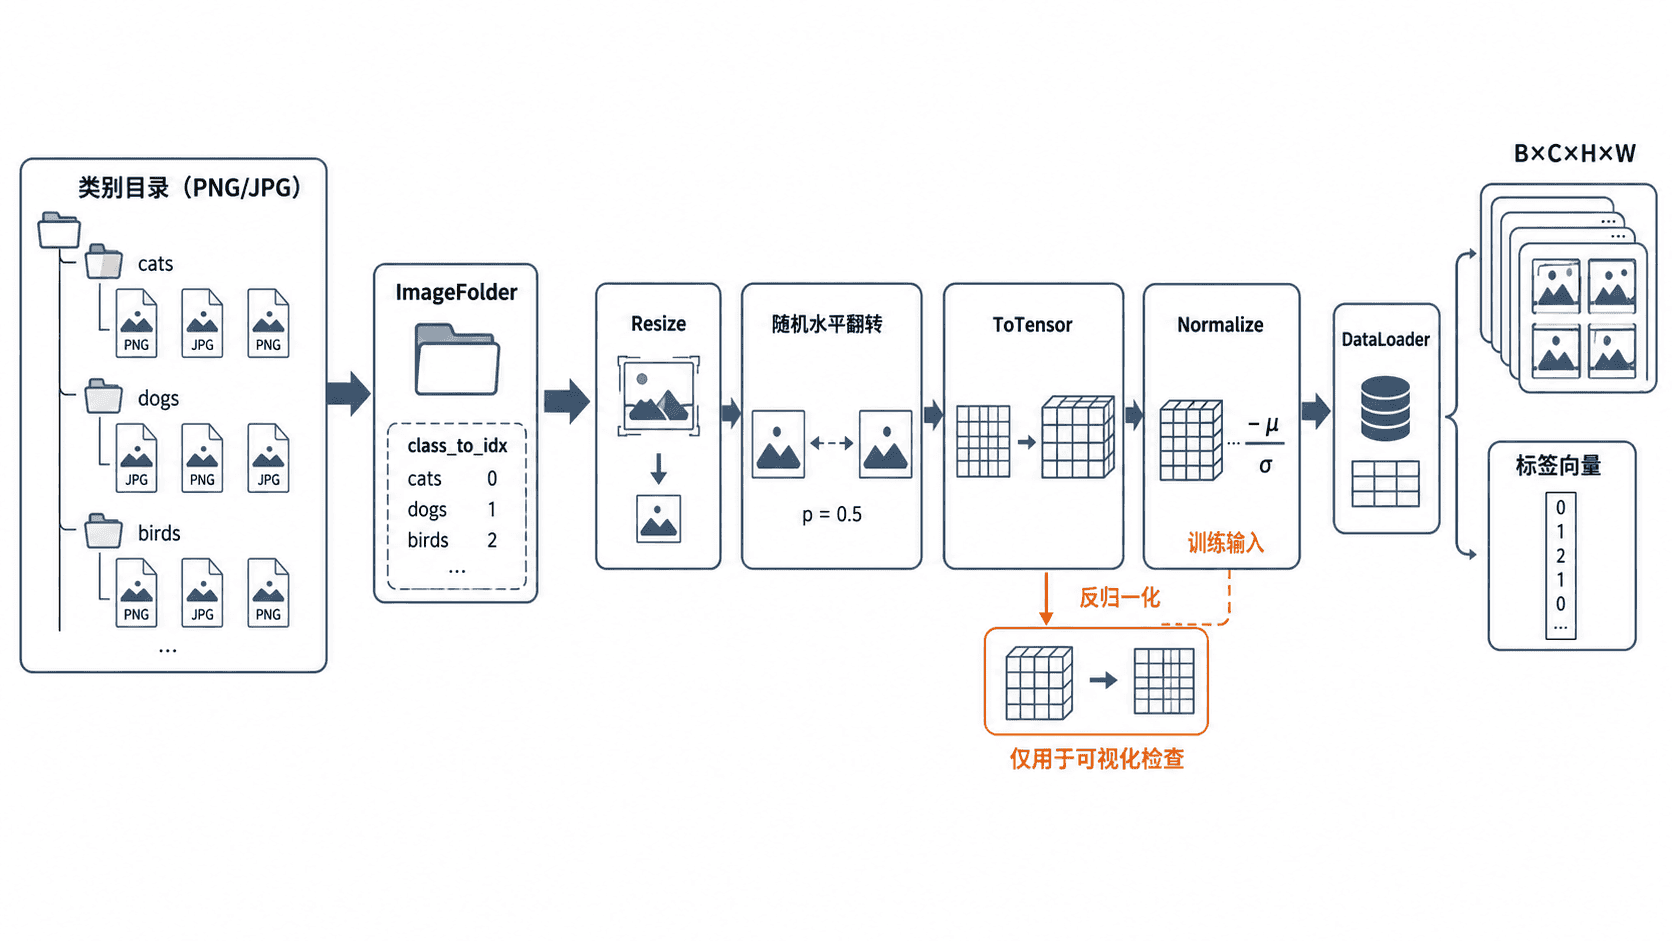
变换链的顺序会影响结果。几何增强应放在 ToTensor 前后均可,但必须确认所用变换支持对应输入类型;归一化通常放在最后,使每个通道按指定均值和标准差缩放。训练集可以使用随机增强,验证集则应只保留确定性变换。
构建并检查可运行管线
下面的程序先创建一个最小分类数据集,再读取、变换、批处理并保存预览图。实际项目只需把 root 替换为自己的训练集目录。
from pathlib import Path

import matplotlib.pyplot as plt
import torch
from PIL import Image
from torchvision import datasets, transforms
from torchvision.utils import make_grid

root = Path("demo_images/train")
class_colors = {
    "cat": [(220, 80, 80), (200, 100, 100), (230, 70, 90), (210, 90, 70)],
    "dog": [(70, 110, 220), (80, 130, 210), (60, 100, 230), (90, 120, 200)],
}

# 创建可重复运行的最小目录数据集。
for class_name, colors in class_colors.items():
    class_dir = root / class_name
    class_dir.mkdir(parents=True, exist_ok=True)
    for index, color in enumerate(colors):
        Image.new("RGB", (80, 60), color).save(class_dir / f"{class_name}_{index}.png")

mean = (0.5, 0.5, 0.5)
std = (0.5, 0.5, 0.5)
train_transform = transforms.Compose([
    transforms.Resize((64, 64)),
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.ToTensor(),
    transforms.Normalize(mean=mean, std=std),
])

dataset = datasets.ImageFolder(root=root, transform=train_transform)
loader = torch.utils.data.DataLoader(
    dataset,
    batch_size=4,
    shuffle=True,
    num_workers=0,
)

images, labels = next(iter(loader))
print("class_to_idx:", dataset.class_to_idx)
print("batch shape:", list(images.shape))
print("label range:", min(dataset.targets), "to", max(dataset.targets))

# 反归一化仅用于显示,不能把该结果送回模型训练。
preview = images * torch.tensor(std).view(1, 3, 1, 1)
preview = preview + torch.tensor(mean).view(1, 3, 1, 1)
grid = make_grid(preview.clamp(0, 1), nrow=4)

plt.figure(figsize=(10, 3))
plt.imshow(grid.permute(1, 2, 0))
plt.axis("off")
plt.tight_layout()
plt.savefig("batch_preview.png", dpi=150)
print("preview saved: batch_preview.png")
预期输出如下。批次中样本顺序会因 shuffle=True 而变化,但形状、类别映射和标签范围应保持一致。
class_to_idx: {'cat': 0, 'dog': 1}
batch shape: [4, 3, 64, 64]
label range: 0 to 1
preview saved: batch_preview.png
验证管线是否可靠
首先确认图像张量采用 B×C×H×W 排列,通道数与模型输入一致。其次检查标签最小值不小于 0、最大值小于类别数。最后打开 batch_preview.png,确认颜色、方向和类别没有明显异常。
常见问题包括灰度图与 RGB 图混用、训练集和验证集目录名称不一致、归一化参数与预训练模型要求不一致。使用预训练模型时,应优先采用其官方权重对应的输入尺寸和归一化配置。
Tips:数据增强只应用于训练集。验证集若包含随机裁剪或随机翻转,同一模型在多次评估时可能得到不同结果。
本课总结
ImageFolder通过子目录名称建立类别编号,必须保存并复用class_to_idx- 变换链负责统一输入规格,
DataLoader负责打乱、分批和并行读取 - 批次形状、标签范围和反归一化预览是数据进入模型前的三项核心检查
下一课预告
下一课将基于模型预测结果计算准确率、混淆矩阵、精确率和召回率,并通过错误样本定位模型真正的薄弱类别。