
机器学习与深度学习 / 系统课时
序列分类实践
序列分类实践
本课完成一个可运行的变长时间序列分类器:生成样本、按批次填充、用 GRU 提取序列表示、训练二分类模型,并通过混淆统计和错误样本定位模型薄弱点,形成从训练到诊断的最小闭环。
学习目标
- 能搭建支持变长输入的 GRU 分类模型
- 能完成训练、验证和分类结果统计
- 能根据错误样本特征判断数据或模型问题
明确任务与数据格式
示例把每条样本表示为形状 [length, 2] 的时间序列。第一维特征的整体均值决定类别,第二维是干扰特征;不同样本长度在 4 到 12 之间。
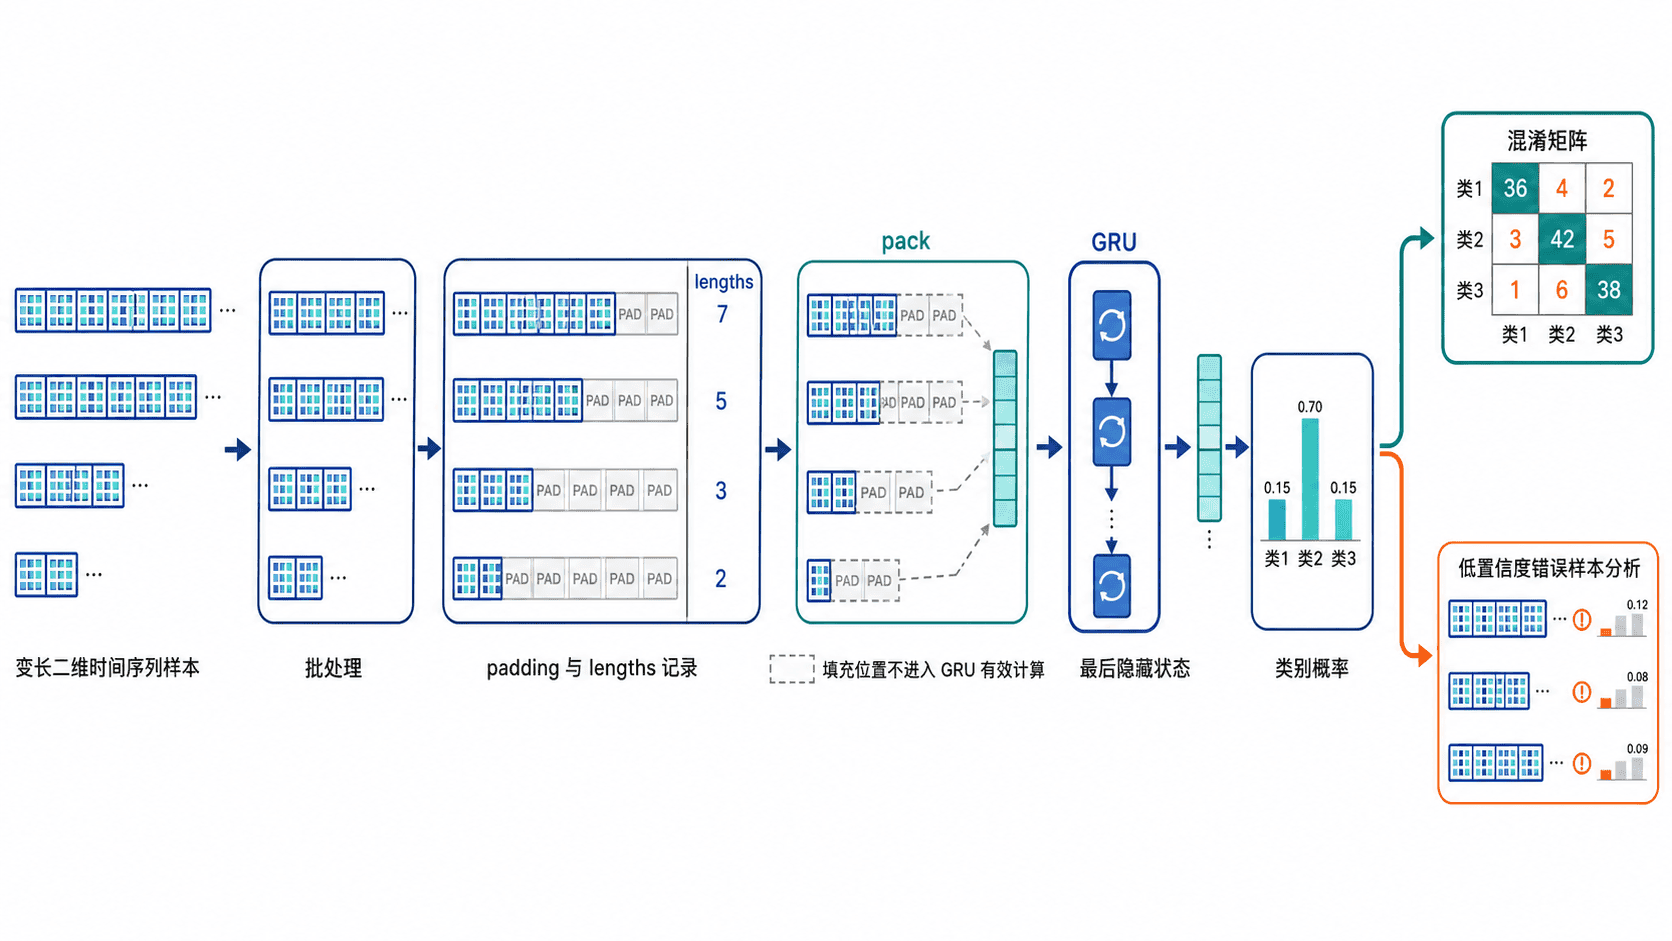
批处理函数会返回填充张量、真实长度和标签。模型先打包序列,再把 GRU 最终隐藏状态送入线性分类层,因此填充位置不会参与序列表示。
实现并训练分类模型
下面代码只依赖 PyTorch。随机种子固定,但不同设备和版本的具体损失值仍可能略有差异。
import random

import torch
from torch import nn
from torch.nn.utils.rnn import pack_padded_sequence, pad_sequence
from torch.utils.data import DataLoader, Dataset

torch.manual_seed(7)
random.seed(7)

class SequenceDataset(Dataset):
    def __init__(self, size: int):
        self.samples = []
        for _ in range(size):
            label = random.randint(0, 1)
            length = random.randint(4, 12)
            center = 0.9 if label == 1 else -0.9

            first = center + 0.7 * torch.randn(length, 1)
            second = torch.randn(length, 1)
            sequence = torch.cat([first, second], dim=1)
            self.samples.append((sequence, label))

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, index):
        return self.samples[index]

def collate_batch(batch):
    sequences, labels = zip(*batch)
    lengths = torch.tensor([len(item) for item in sequences])
    padded = pad_sequence(sequences, batch_first=True)
    return padded, lengths, torch.tensor(labels)

class GRUClassifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.gru = nn.GRU(input_size=2, hidden_size=16, batch_first=True)
        self.classifier = nn.Linear(16, 2)

    def forward(self, padded, lengths):
        packed = pack_padded_sequence(
            padded,
            lengths.cpu(),
            batch_first=True,
            enforce_sorted=False,
        )
        _, hidden = self.gru(packed)
        return self.classifier(hidden[-1])

train_loader = DataLoader(
    SequenceDataset(320),
    batch_size=32,
    shuffle=True,
    collate_fn=collate_batch,
)
test_loader = DataLoader(
    SequenceDataset(96),
    batch_size=32,
    shuffle=False,
    collate_fn=collate_batch,
)

model = GRUClassifier()
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
criterion = nn.CrossEntropyLoss()

for epoch in range(1, 21):
    model.train()
    total_loss = 0.0

    for padded, lengths, labels in train_loader:
        optimizer.zero_grad()
        logits = model(padded, lengths)
        loss = criterion(logits, labels)
        loss.backward()
        optimizer.step()
        total_loss += loss.item() * labels.size(0)

    if epoch in {1, 20}:
        average_loss = total_loss / len(train_loader.dataset)
        print(f"epoch {epoch:02d} loss: {average_loss:.4f}")

model.eval()
confusion = torch.zeros(2, 2, dtype=torch.int64)
errors = []

with torch.no_grad():
    for padded, lengths, labels in test_loader:
        logits = model(padded, lengths)
        probabilities = logits.softmax(dim=1)
        predictions = probabilities.argmax(dim=1)

        for truth, prediction in zip(labels, predictions):
            confusion[truth, prediction] += 1

        for index in (predictions != labels).nonzero(as_tuple=False).flatten():
            valid = padded[index, : lengths[index]]
            errors.append(
                (
                    int(labels[index]),
                    int(predictions[index]),
                    float(probabilities[index].max()),
                    int(lengths[index]),
                    float(valid[:, 0].mean()),
                )
            )

accuracy = confusion.diag().sum().item() / confusion.sum().item()
print("confusion matrix:")
print(confusion)
print(f"test accuracy: {accuracy:.3f}")
print("first errors:", errors[:3])
预期输出
epoch 01 loss: <LOSS>
epoch 20 loss: <LOWER_LOSS>
confusion matrix:
tensor([[<TN>, <FP>],
        [<FN>, <TP>]])
test accuracy: <ACCURACY>
first errors: <ERROR_LIST>
实际数值可能因 PyTorch 版本和硬件不同而变化。正确运行时,第二十轮损失应明显低于第一轮,测试准确率通常较高;若错误样本为空,最后一行会显示 first errors: []。
读取评估结果
混淆矩阵的行表示真实类别,列表示预测类别。左上角和右下角是正确数量,右上角是假阳性,左下角是假阴性。单看准确率无法判断模型偏向哪一类,因此至少要同时查看这四个计数。
错误记录包含真实标签、预测标签、最大置信度、序列长度和第一维特征均值。若错误集中在均值接近 0 的样本,说明样本位于类别边界;若高置信度错误较多,优先检查标签、数据生成规则或训练集分布是否一致。
改进模型的顺序
先验证数据与标签,再调整模型。可以打印若干原始序列,确认填充前长度和标签正确;然后观察训练损失与测试准确率是否同时改善,排除只记住训练集的情况。
模型容量不足时可增加隐藏维度或堆叠 GRU 层;长距离依赖明显时可尝试双向 GRU、LSTM 或注意力机制。类别不平衡时,应使用加权损失并补充精确率、召回率和 F1,而不是只追求总体准确率。
本课总结
- 变长分类模型应把真实长度传给打包操作,避免填充位置污染隐藏状态
- 训练闭环至少包含损失下降、测试集评估和混淆统计
- 错误样本的置信度、长度与关键特征有助于区分边界样本、数据问题和模型不足
下一课预告
下一课将进一步讨论更长序列中的信息保留问题,并比较循环网络与注意力机制在依赖建模上的差异。