
机器学习与深度学习 / 系统课时
生成模型路线选择
生成模型路线选择
选择生成模型时,不能只比较“谁生成得更好”,还要同时考虑能否稳定采样、输出清晰度、训练难度、推理速度、条件控制和算力预算。本课建立一套可复用的判断顺序,帮助你在自编码器、VAE、GAN 与扩散模型之间做出取舍。
学习目标
- 区分四类模型的核心目标与生成方式
- 比较生成质量、训练稳定性、推理成本和可控性
- 根据任务约束快速筛选合适的技术路线
四条路线分别解决什么问题
普通自编码器由编码器和解码器组成,核心目标是把输入压缩后再重建。它擅长表示学习、降维和去噪,但潜在空间没有天然的概率约束,随意采样一个向量通常不能稳定得到合理新样本,因此不应把它直接等同于完整生成模型。
VAE 在自编码器结构上为潜在变量加入概率分布约束,使潜在空间连续且可以采样。它通常训练较稳定,也便于做插值和表示分析;代价是重建目标与分布约束需要权衡,生成细节常不如对抗式或扩散式方法锐利。
GAN 让生成器与判别器进行对抗训练。生成器一次前向计算即可得到结果,推理速度快,并且能够产生清晰样本;但训练过程可能不稳定,还可能出现模式坍塌,即模型只覆盖真实数据分布中的少数模式。
扩散模型通过多步去噪生成样本,训练目标相对规整,生成质量、分布覆盖和条件控制能力通常较强。它的主要代价是采样步骤多、推理延迟高,并需要更多训练与部署资源。
用统一维度比较能力与成本
| 路线 | 主要优势 | 主要限制 | 更适合的任务 |
|---|---|---|---|
| 自编码器 | 表示紧凑、重建直接、结构简单 | 潜在空间难以直接随机采样 | 降维、压缩、异常检测、去噪 |
| VAE | 可采样、潜在空间连续、训练较稳定 | 细节可能偏平滑 | 表示学习、数据补全、可解释潜变量 |
| GAN | 输出锐利、单次生成快 | 训练敏感、可能模式坍塌 | 低延迟图像生成、图像翻译、超分辨率 |
| 扩散模型 | 质量高、覆盖较好、条件控制灵活 | 采样慢、计算成本高 | 文生图、图像编辑、高质量多模态生成 |
表格展示的是整体倾向,不能代替项目判断。例如,GAN 推理快,但若团队缺少对抗训练经验,调试成本可能超过它节省的推理成本;扩散模型质量高,但在端侧实时生成场景中,多步采样的延迟可能直接使方案不可用。
按任务约束完成路线筛选
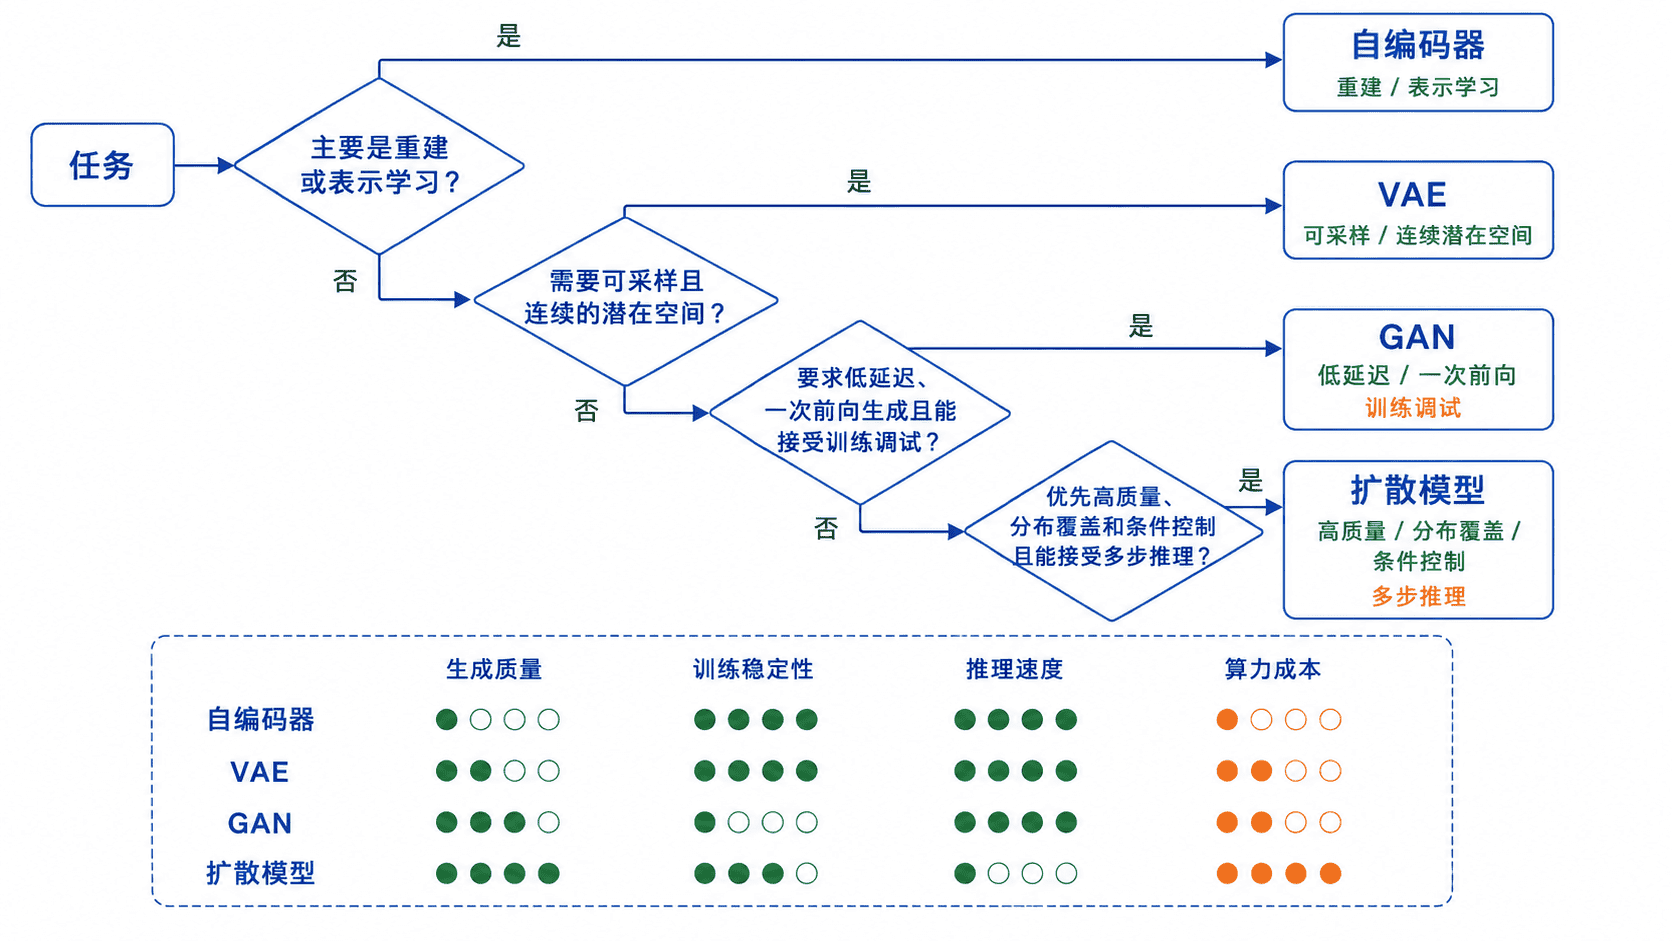
第一步先确认目标是不是“生成新样本”。若主要需求是压缩、特征提取、去噪或异常检测,普通自编码器往往已经足够,不必为随机生成能力引入更复杂的训练机制。
第二步判断是否需要结构化潜在空间。需要连续插值、概率采样或潜变量解释时,VAE 通常比普通自编码器更合适;若最重要的是视觉锐利度和低推理延迟,并且团队能够处理对抗训练,可优先评估 GAN。
第三步判断是否愿意用推理成本换取质量与控制。文本条件、局部编辑、多条件组合以及更好的样本覆盖是核心要求时,扩散模型更有优势;若系统必须以极低延迟批量生成,则应评估 GAN、经过加速的扩散方案或其他轻量模型。
不要只看公开演示中的最佳样本。路线评估还应检查平均质量、失败率、多样性、推理耗时、显存占用、数据规模和维护难度。最终应在统一数据与指标下做小规模验证,而不是仅凭模型名称决定架构。
本课总结
- 自编码器、VAE、GAN 与扩散模型的目标、采样方式和失败模式各不相同
- 路线选择要同时比较质量、稳定性、速度、控制能力和资源成本
- 最终决策应由任务约束与小规模验证共同完成
下一课预告
下一课将进入生成模型的训练与评估,重点讨论如何用重建质量、样本多样性、分布覆盖和人工检查判断模型是否真正有效。