
机器学习与深度学习 / 系统课时
词元、词表与嵌入
词元、词表与嵌入
神经网络不能直接处理单词或字符,本课将建立从原始文本到稠密向量的完整输入链路。你将完成词元切分、词表编号和未知词处理,并用 PyTorch 嵌入层验证相同词元如何共享同一组可训练参数。
学习目标
- 理解词元、词表和词元编号之间的关系
- 正确处理未知词、填充符号和词表大小
- 使用
nn.Embedding将离散编号映射为稠密向量
从词元到编号
词元是文本模型处理的基本单位,可以是字符、完整单词或子词。字符词表较小,但序列通常更长;完整单词直观易懂,却容易产生庞大词表和大量未知词;子词在词表规模与表达能力之间取得了较好平衡。
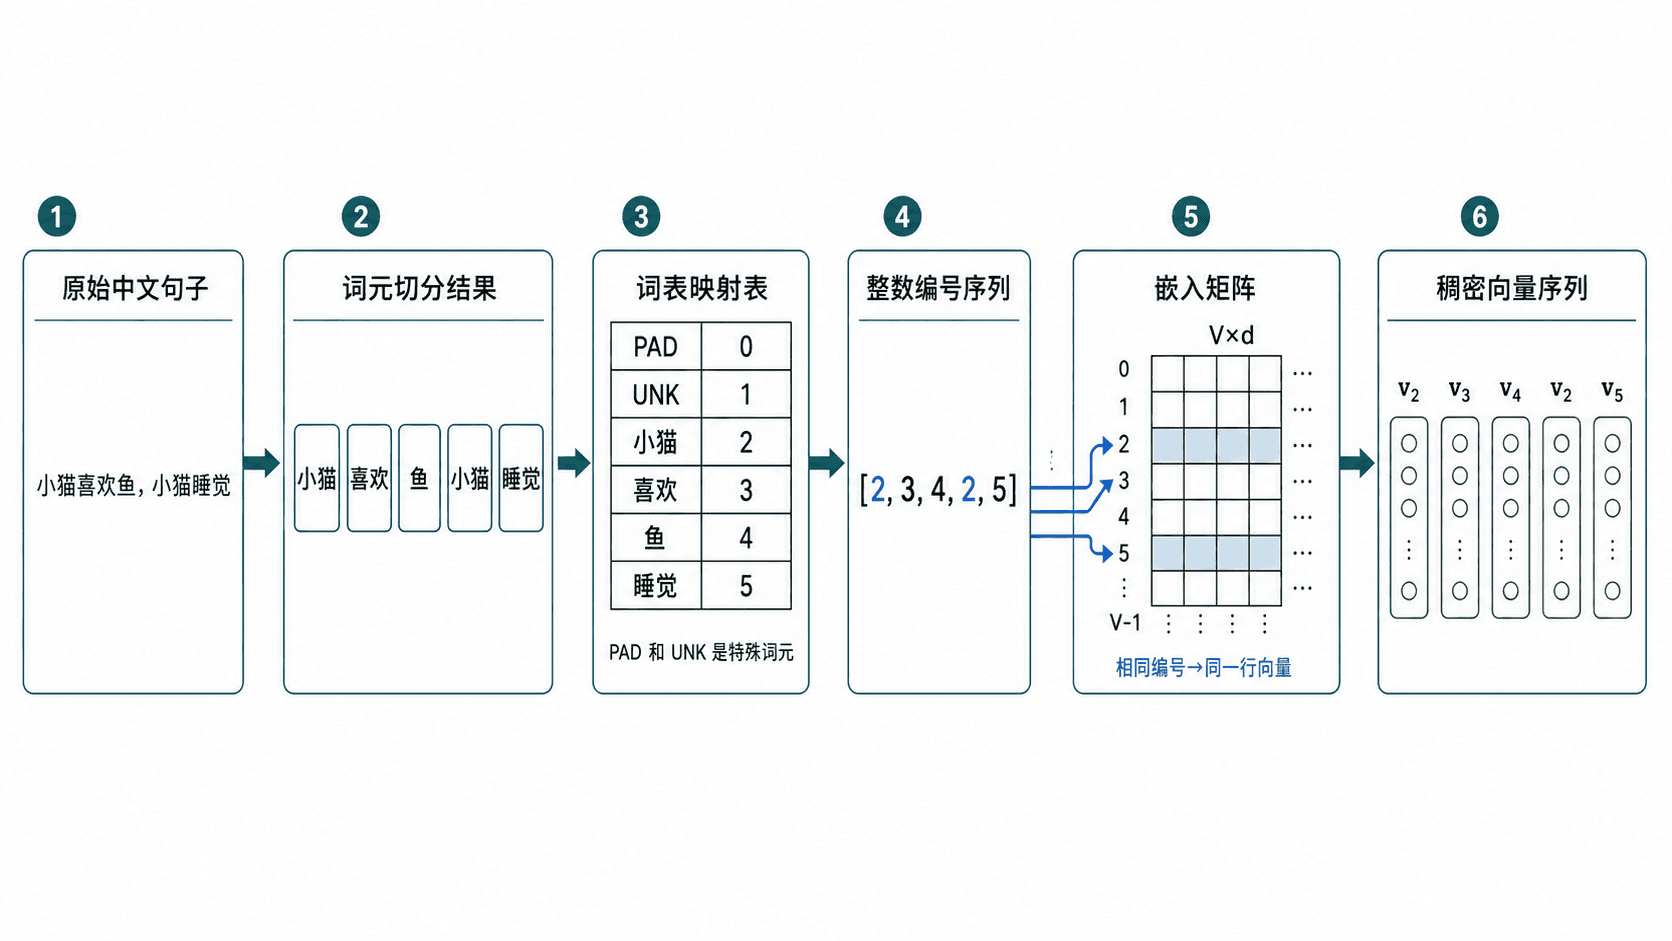
完成切分后,需要建立词元到整数编号的映射。例如,词表可以规定 [PAD] 为 0、[UNK] 为 1、深度为 2、学习为 3。句子“深度 学习”便可编码为 [2, 3]。
编号本身只用于索引,不表示大小关系。编号 3 并不意味着对应词元比编号 2 更重要,也不能直接把这些整数当作连续数值特征输入模型。
词表如何处理未知项
词表通常从训练数据统计得到,并按频率筛选词元。低频词元可以统一映射到 [UNK],从而限制参数规模。推理阶段遇到未收录词元时,也必须使用同一个 [UNK] 编号,不能临时扩充词表,否则模型没有对应的已训练参数。
批量训练要求同一批序列具有一致长度,因此短序列一般使用 [PAD] 补齐。填充位置不属于原始文本,后续计算注意力、损失或池化结果时需要通过掩码排除。
词表一旦用于训练,就应与模型权重一起保存。若部署时重新排序词表,即使词元数量相同,编号与嵌入向量也会错位,模型输出将失去意义。
嵌入层如何工作
独热编码会为词表中的每个词元创建一个长度等于词表大小的稀疏向量,词表较大时会浪费大量存储与计算。嵌入层则维护一个形状为“词表大小 × 嵌入维度”的参数矩阵。
输入编号会选择矩阵中的对应行。例如编号 2 会读取第 2 行向量。相同词元无论出现在哪个句子或位置,都会读取同一行参数;训练时,梯度会逐步调整这些向量,使具有相似使用环境的词元形成更接近的表示。
嵌入维度是模型超参数。维度过小可能无法保存足够语义信息,维度过大则会增加参数量和过拟合风险。实际选择应结合词表规模、数据量、任务复杂度和验证结果。
用 PyTorch 验证嵌入
下面创建一个包含 5 个词元、每个词元使用 4 维向量的嵌入层。编号 0 被指定为填充项,因此其向量初始化为零,并且训练时不会更新。
import torch
from torch import nn

torch.manual_seed(7)

embedding = nn.Embedding(
    num_embeddings=5,
    embedding_dim=4,
    padding_idx=0,
)

token_ids = torch.tensor([
    [1, 2, 0],
    [3, 1, 4],
])

vectors = embedding(token_ids)

print("token_ids shape:", tuple(token_ids.shape))
print("vectors shape:", tuple(vectors.shape))
# 两个位置都使用编号 1,因此读取到完全相同的嵌入向量
print("same token shares vector:", torch.equal(vectors[0, 0], vectors[1, 1]))
print("padding vector sum:", vectors[0, 2].abs().sum().item())
预期输出:
token_ids shape: (2, 3)
vectors shape: (2, 3, 4)
same token shares vector: True
padding vector sum: 0.0
输入形状为“批量大小 × 序列长度”,经过嵌入层后新增嵌入维度,因此输出形状变为“批量大小 × 序列长度 × 嵌入维度”。嵌入层不会改变词元顺序,只负责把每个编号替换成对应向量。
使用时的关键边界
传入嵌入层的编号必须是整数张量,并且每个编号都处于 0 到 num_embeddings - 1 的范围内。编号越界会直接触发索引错误,因此数据编码使用的词表必须与嵌入层配置一致。
padding_idx 只能避免填充向量被更新,不能自动阻止后续网络使用填充位置。处理变长序列时,仍需把真实长度或掩码传递给循环网络及损失计算逻辑。
嵌入矩阵属于模型参数,训练、保存和加载都由模型状态管理。部署时必须同时固定分词规则、词表文件、特殊符号编号和模型权重,才能复现训练阶段的输入表示。
本课总结
- 词元必须先通过固定词表转换为整数编号,编号本身不包含大小或语义关系
- 嵌入层通过查表把离散编号转换为可训练的稠密向量
- 分词规则、词表编号、特殊符号和模型权重必须保持一致
下一课预告
下一课将把嵌入后的向量序列送入循环神经网络,理解隐藏状态如何沿时间步传递并汇总历史信息。