
机器学习与深度学习 / 系统课时
高效使用 DataLoader
高效使用 DataLoader
本课将把 Dataset 组织成稳定、高吞吐且可复现的批量输入管线。你会配置批大小、打乱、多进程、固定内存和随机种子,并通过一个可运行示例验证两次加载顺序一致且没有遗漏样本。
学习目标
- 理解
DataLoader中采样、并行读取与组批的执行关系 - 正确配置
batch_size、shuffle、num_workers和pin_memory - 使用生成器与工作进程种子获得可复现实验
DataLoader 如何组织数据
DataLoader 不改变 Dataset 的样本定义,而是在其外层增加索引采样、并行取样、批量拼接和内存传输优化。启用 shuffle=True 后,主进程先生成索引顺序,再把取样任务交给工作进程;样本返回后由 collate_fn 组装成批次。
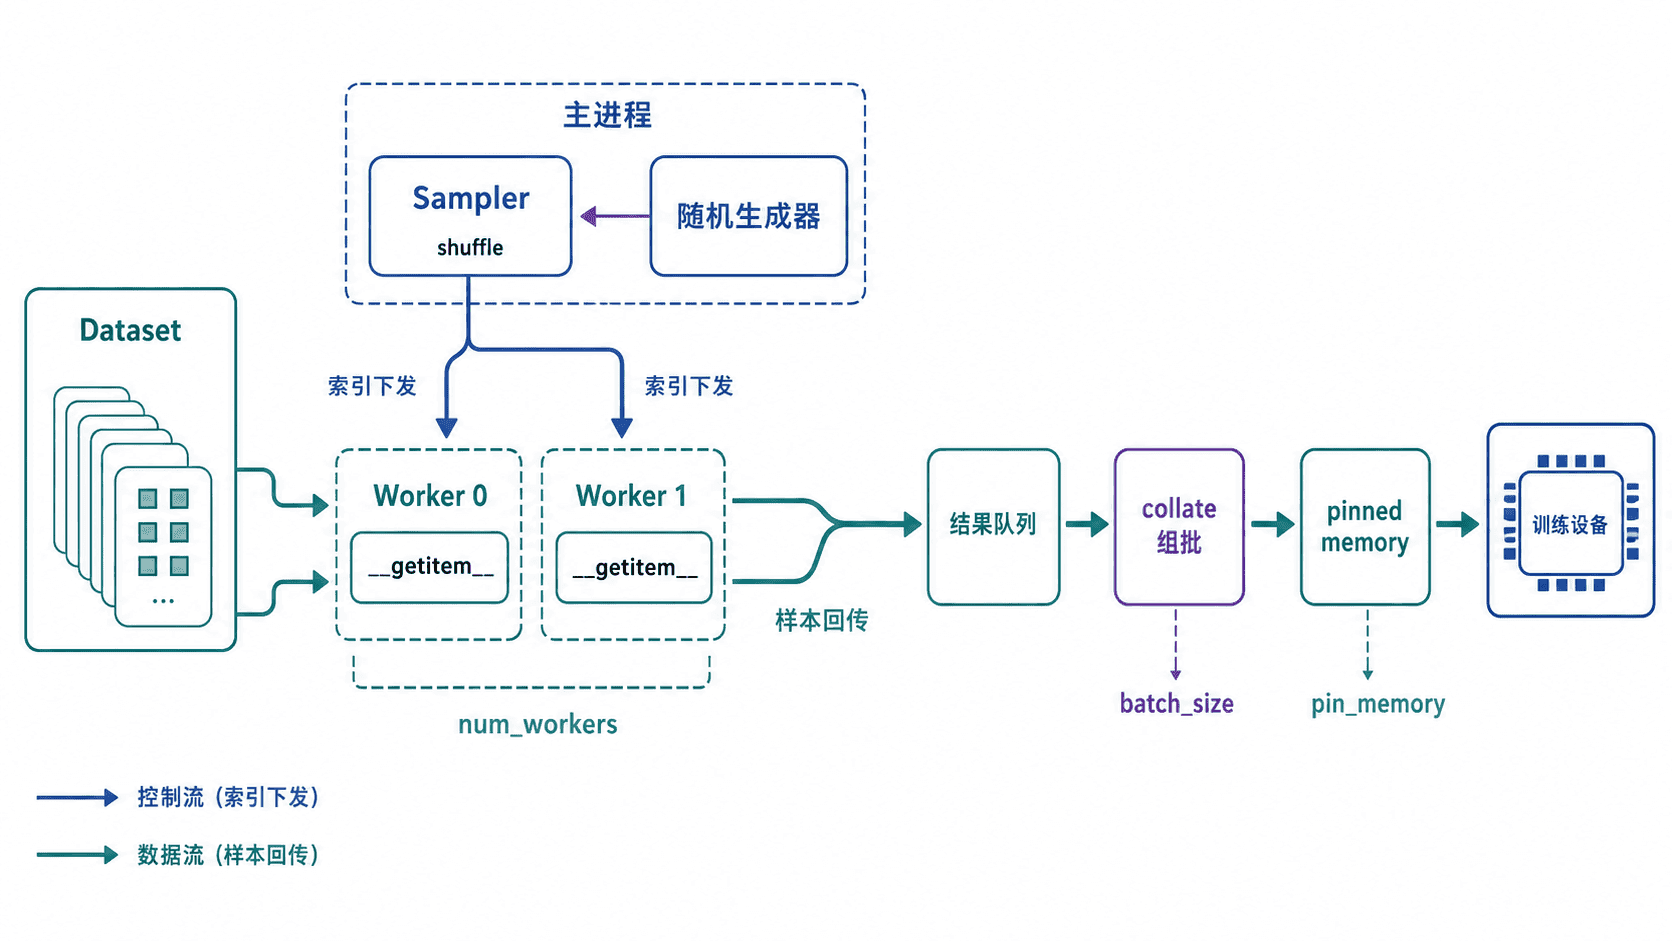
batch_size 决定每次迭代返回多少个样本;drop_last=True 会丢弃不足一个完整批次的尾批,常用于依赖固定批大小的训练。num_workers 控制子进程数量,并不是越大越快,应结合 CPU 核数、存储速度、单样本预处理成本和内存占用测试。
pin_memory=True 主要用于把 CPU 张量放入固定内存,以便更高效地异步复制到 CUDA 设备。CPU 训练通常没有收益,因此可以根据 torch.cuda.is_available() 条件启用。
配置可复现的批量加载
下面的示例创建两个配置完全相同的 DataLoader。两者使用同一个种子但各自持有独立生成器,因此打乱后的顺序一致;同时验证全部样本只出现一次,并检查尾批形状。
import random

import numpy as np
import torch
from torch import Tensor
from torch.utils.data import DataLoader, Dataset

class ToyDataset(Dataset):
    def __len__(self) -> int:
        return 8

    def __getitem__(self, index: int) -> tuple[Tensor, int]:
        return torch.tensor([float(index)]), index

def seed_worker(worker_id: int) -> None:
    # torch.initial_seed 已包含基础种子和 worker_id,再同步给其他随机库。
    worker_seed = torch.initial_seed() % (2**32)
    random.seed(worker_seed)
    np.random.seed(worker_seed)

def build_loader(seed: int, workers: int = 2) -> DataLoader:
    generator = torch.Generator()
    generator.manual_seed(seed)

    return DataLoader(
        ToyDataset(),
        batch_size=3,
        shuffle=True,
        num_workers=workers,
        pin_memory=torch.cuda.is_available(),
        drop_last=False,
        worker_init_fn=seed_worker,
        generator=generator,
        persistent_workers=workers > 0,
    )

def collect(loader: DataLoader) -> tuple[list[int], list[tuple[int, ...]]]:
    order: list[int] = []
    shapes: list[tuple[int, ...]] = []

    for features, sample_ids in loader:
        order.extend(sample_ids.tolist())
        shapes.append(tuple(features.shape))

    return order, shapes

def main() -> None:
    first_order, first_shapes = collect(build_loader(seed=2026))
    second_order, _ = collect(build_loader(seed=2026))

    print("same_order:", first_order == second_order)
    print("covers_all:", sorted(first_order) == list(range(8)))
    print("batch_shapes:", first_shapes)

if __name__ == "__main__":
    main()
预期输出:
same_order: True
covers_all: True
batch_shapes: [(3, 1), (3, 1), (2, 1)]
具体打乱顺序不需要写死,因为不同 PyTorch 版本的内部实现可能变化;这里验证的是相同环境、相同配置和相同种子下,两次结果保持一致。尾批形状为 (2, 1),说明 drop_last=False 保留了最后两个样本。
参数选择与性能验证
初始配置可从 num_workers=0 开始,先确认数据正确,再逐步增加到 2、4 或更高,并用完整 epoch 耗时而不是单个批次判断收益。若数据位于机械硬盘或网络存储,过多工作进程可能造成随机读取竞争,反而降低吞吐。
persistent_workers=True 会在多个 epoch 之间保留工作进程,减少反复创建进程的开销,但会持续占用内存,而且仅在 num_workers>0 时可用。交互式 Notebook 或受限运行环境若无法启动子进程,可先改为 num_workers=0;正式训练脚本再恢复并行配置。
训练到 GPU 时,可将批次复制写成 batch = batch.to(device, non_blocking=True)。只有来源张量位于固定内存且设备支持时,non_blocking=True 才可能带来异步传输收益,仍需通过性能分析确认。
常见错误
只设置全局 torch.manual_seed 并不能完整覆盖多进程中的 Python random 和 NumPy 随机状态。应同时传入 generator,并在 worker_init_fn 中同步各随机库。
另一个常见问题是在 Windows 或 macOS 的 spawn 模式下,把启动代码写在模块顶层。多进程示例应放入 if __name__ == "__main__": 保护中,否则子进程可能重复执行入口代码。
本课总结
DataLoader在Dataset外层负责采样、并行读取、组批与传输优化- 性能参数必须通过完整训练吞吐测试,而不是盲目增大工作进程数
- 可复现加载需要同时管理主生成器和各工作进程中的随机库
下一课预告
下一课将进入实验管理,统一记录超参数、指标、模型检查点和运行环境,使训练结果能够比较、复现与回滚。