
机器学习与深度学习 / 系统课时
排查安装与显卡问题
排查安装与显卡问题
本课建立一条从环境到驱动、再到显存和动态库的排查链路。完成后,你可以先收集证据再修复,而不是反复卸载重装,并能判断问题究竟来自包冲突、错误解释器、CUDA 驱动还是运行时资源不足。
学习目标
- 使用诊断命令确认 Python、PyTorch 与 CUDA 状态
- 按现象区分包冲突、驱动、显存和动态库问题
- 完成修复后用同一组检查项验证环境
先记录现象,再按顺序检查
不要从“重装所有软件”开始。先记录完整报错、执行命令、当前解释器路径和是否在虚拟环境中,然后按“解释器 → Python 包 → PyTorch 构建 → 显卡驱动 → 动态库 → 运行参数”的顺序检查。这个顺序能避免把上层配置问题误判成硬件故障。
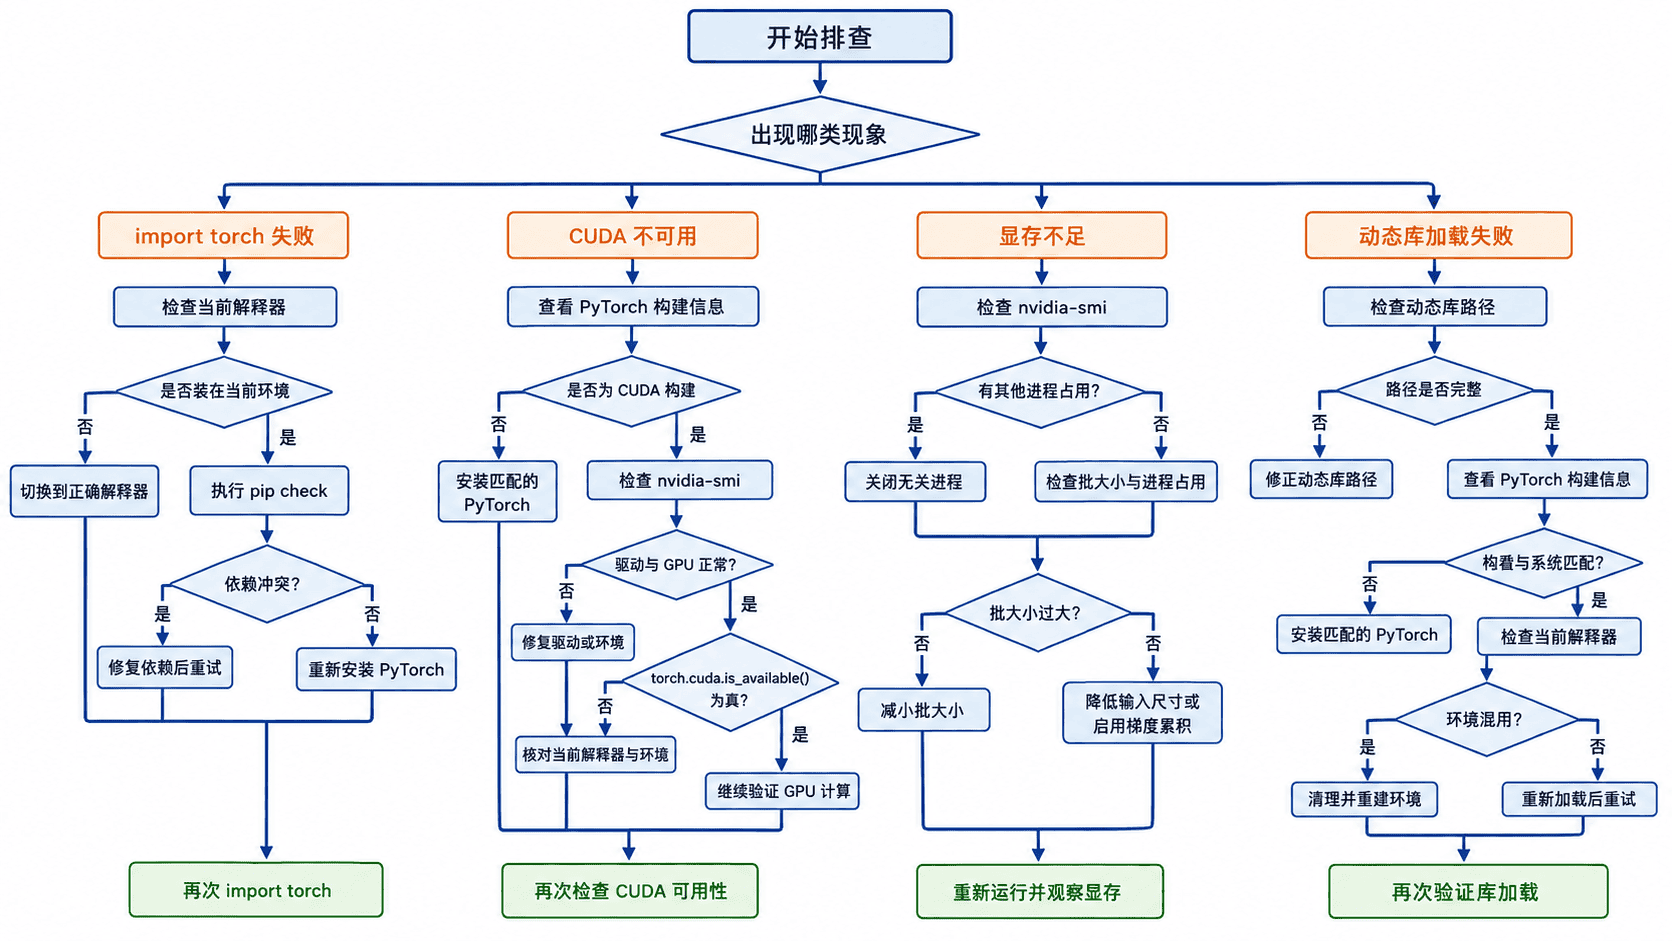
先运行下面的完整诊断脚本。它不会强制调用 GPU,因此即使 CUDA 不可用也能输出结果。
import sys

import torch

def main() -> None:
    print(f"python={sys.executable}")
    print(f"torch={torch.__version__}")
    print(f"torch_cuda={torch.version.cuda}")
    print(f"cuda_available={torch.cuda.is_available()}")
    print(f"device_count={torch.cuda.device_count()}")

    if torch.cuda.is_available():
        print(f"gpu={torch.cuda.get_device_name(0)}")
    else:
        print("gpu=NOT_AVAILABLE")

if __name__ == "__main__":
    main()
预期输出
python=<PATH>
torch=<VERSION>
torch_cuda=<CUDA_VERSION_OR_NONE>
cuda_available=<True_OR_False>
device_count=<N>
gpu=<GPU_NAME_OR_NOT_AVAILABLE>
实际版本、路径和设备数量可能不同。关键是把输出保存下来,并确认运行脚本的解释器与安装 PyTorch 时使用的解释器一致。
根据症状定位根因
| 现象 | 常见根因 | 第一检查项 |
|---|---|---|
ModuleNotFoundError: No module named 'torch' |
包安装在其他解释器中 | sys.executable 与 python -m pip show torch |
torch.cuda.is_available() 为 False |
CPU 版 PyTorch、驱动不可用或设备不可见 | torch.version.cuda 与 nvidia-smi |
CUDA out of memory |
批大小过大、张量仍被引用或其他进程占用显存 | 当前进程、批大小和显存占用 |
DLL load failed 或无法加载 .so |
动态库缺失、架构不匹配或搜索路径错误 | 完整报错中的库文件名 |
包冲突应先执行 python -m pip check。正常环境的预期输出如下。
python -m pip check预期输出
No broken requirements found.若输出依赖版本冲突,优先在新的虚拟环境中按项目依赖重新安装,不要在同一环境里不断覆盖不同来源的包。安装 PyTorch 时应使用项目确定的安装方式,并避免同时混用多个包管理器维护同一套二进制依赖。
CUDA 不可用的定位顺序
首先运行 nvidia-smi。命令不存在或无法连接驱动,说明问题位于驱动层;命令正常但 torch.version.cuda 为 None,通常表示当前安装的是不含 CUDA 支持的构建;两者都有值但仍不可用,则继续检查设备是否被环境变量隐藏、容器是否映射 GPU,以及当前进程是否有访问权限。
nvidia-smi预期输出
NVIDIA-SMI <VERSION>
Driver Version: <DRIVER_VERSION>
CUDA Version: <CUDA_VERSION>
GPU 0: <GPU_NAME>
这里显示的 CUDA Version 是驱动可支持的版本上限,不等于项目一定安装了同版本的 CUDA 工具包。判断 PyTorch 构建应以诊断脚本中的 torch.version.cuda 为准。
显存不足与动态库失败
遇到显存不足,先关闭占用 GPU 的无关进程,再逐步减小 batch size、输入尺寸或模型规模。推理代码应关闭梯度记录;训练时可在硬件支持的前提下使用混合精度。torch.cuda.empty_cache() 只能释放缓存分配器中未被引用的显存,不能清除仍被变量持有的张量。
动态库错误要读取报错中明确缺失的 .dll、.so 或 .dylib 名称。确认 Python 与包的位数、CPU 架构一致,并避免把旧 CUDA、cuDNN 或其他运行库目录长期置于搜索路径最前面。修复后重新打开终端,使环境变量生效,再执行原诊断脚本验证。
修复后的验收清单
修复完成后,应在同一个终端中依次确认:python -m pip check 无冲突、诊断脚本能导入 PyTorch、cuda_available 与预期一致、能够创建一个小张量并完成简单运算。最后重启 Jupyter 内核或 IDE,防止旧进程继续使用修复前的动态库和解释器。
本课总结
- 排查顺序应从解释器和包开始,再进入驱动、动态库与显存层
nvidia-smi反映驱动状态,torch.version.cuda反映 PyTorch 构建信息- 修复后必须在新进程中重复同一组诊断,不能只以“安装成功”作为验收
下一课预告
下一课将进入 PyTorch 的张量基础,学习张量创建、形状、数据类型和设备迁移,为后续模型计算做好准备。