
机器学习与深度学习 / 系统课时
手工验证反向传播
手工验证反向传播
自动微分能快速得到梯度,但只有亲手算过一次,才能真正理解梯度如何沿计算图逐层传回。本课使用一个单输入、单隐藏单元的小网络,完成前向计算、链式求导,并与 PyTorch 结果逐项核对。
学习目标
- 写出小型网络中每个节点的局部梯度
- 使用链式法则计算所有参数的梯度
- 将手工结果与 PyTorch 自动微分结果进行对照
定义一个最小网络
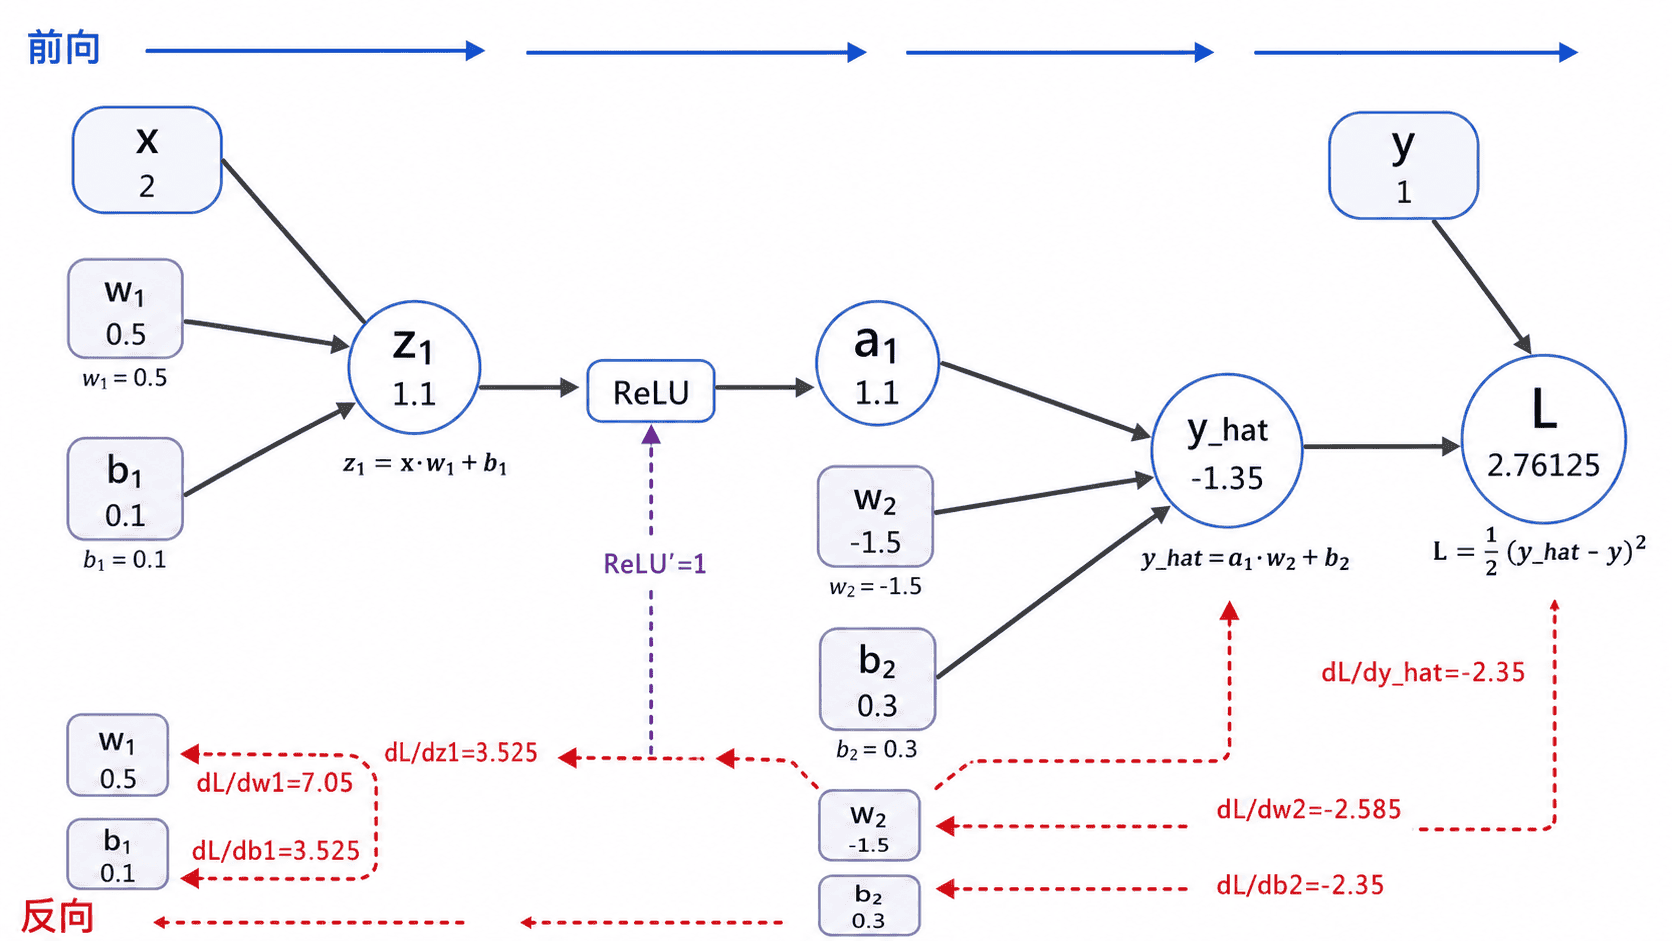
设输入 ,目标 。网络只有一个隐藏单元,激活函数为 ReLU:
损失使用带有 系数的平方误差:
取参数 、、、。这个例子足够小,可以完整追踪每一步,又包含线性层、非线性激活和损失节点。
完成前向计算
先计算隐藏层:
因为 ,所以 ReLU 不改变该值,得到 。继续计算输出:
最终损失为:
前向计算的作用不仅是得到损失,还要保存反向传播需要的中间值,例如 、 和 。
按链式法则反向求导
从损失节点开始:
输出层的局部梯度为 、,因此:
传回隐藏单元的梯度为:
由于 ,ReLU 在此处的导数为 1,所以 。继续传到第一层参数:
这就是反向传播的核心:每个节点只计算自己的局部导数,再乘以上游传来的梯度。
与自动微分逐项对照
下面使用同一组数值构建计算图。backward() 从标量损失开始反向遍历,并把结果累加到各叶子张量的 grad 属性。
python
import torch

x = torch.tensor(2.0)
y = torch.tensor(1.0)

w1 = torch.tensor(0.5, requires_grad=True)
b1 = torch.tensor(0.1, requires_grad=True)
w2 = torch.tensor(-1.5, requires_grad=True)
b2 = torch.tensor(0.3, requires_grad=True)

z1 = w1 * x + b1
a1 = torch.relu(z1)
y_hat = w2 * a1 + b2
loss = 0.5 * (y_hat - y) ** 2

loss.backward()

print(f"loss = {loss.item():.6f}")
print(f"w1.grad = {w1.grad.item():.6f}")
print(f"b1.grad = {b1.grad.item():.6f}")
print(f"w2.grad = {w2.grad.item():.6f}")
print(f"b2.grad = {b2.grad.item():.6f}")
预期输出:
text
loss = 2.761250
w1.grad = 7.050000
b1.grad = 3.525000
w2.grad = -2.585000
b2.grad = -2.350000
自动微分结果与手工计算一致,说明前向公式、局部梯度和链式乘法都正确。实际浮点输出末位可能因运行环境存在极小差异。
对不上时怎样定位
先核对损失定义。若代码使用普通均方误差 ,而手工公式带 ,所有梯度会相差 2 倍。
再检查激活函数所在区间。当前 ,ReLU 导数为 1;若 ,梯度会被截断为 0。恰好在 时,框架采用的约定可能与手工假设不同。
最后检查梯度是否被累加。PyTorch 默认把多次 backward() 的结果累加到 grad 中,训练循环里通常要在下一轮反向传播前调用优化器的 zero_grad()。
本课总结
- 反向传播等于上游梯度乘以当前节点的局部梯度
- 中间值决定局部导数,因此前向计算与反向计算紧密关联
- 手工梯度与自动微分逐项对照,是排查公式和实现错误的可靠方法
下一课预告
下一课将把单个神经元扩展为完整训练过程,观察梯度如何被优化器转换为参数更新,并理解学习率对收敛速度的影响。
按自己的节奏,确认真正理解。