
机器学习与深度学习 / 系统课时
检查点与断点续训
检查点与断点续训
本课解决训练中断后如何从正确位置继续的问题。你将保存模型、优化器、调度器、训练进度与随机状态,并通过原子写入和恢复校验,避免“看似续训、实际重新开始”或文件损坏。
学习目标
- 识别一个可续训检查点必须包含的状态
- 使用 PyTorch 完成安全保存、加载与继续训练
- 通过步数、学习率和参数校验确认恢复有效
为什么不能只保存模型权重
模型权重只描述当前参数,却不包含优化器的动量、调度器的阶段、已经完成的轮次和随机数生成器状态。仅恢复权重时,后续梯度更新路径会改变,学习率也可能回到初始值,训练结果通常无法与原运行连续衔接。
一个实用检查点至少应包含 model、optimizer、scheduler、epoch、global_step 和随机状态。若训练支持混合精度,还要保存梯度缩放器;若要在一个 epoch 中间精确恢复,还需记录采样器位置或已消费的批次索引。
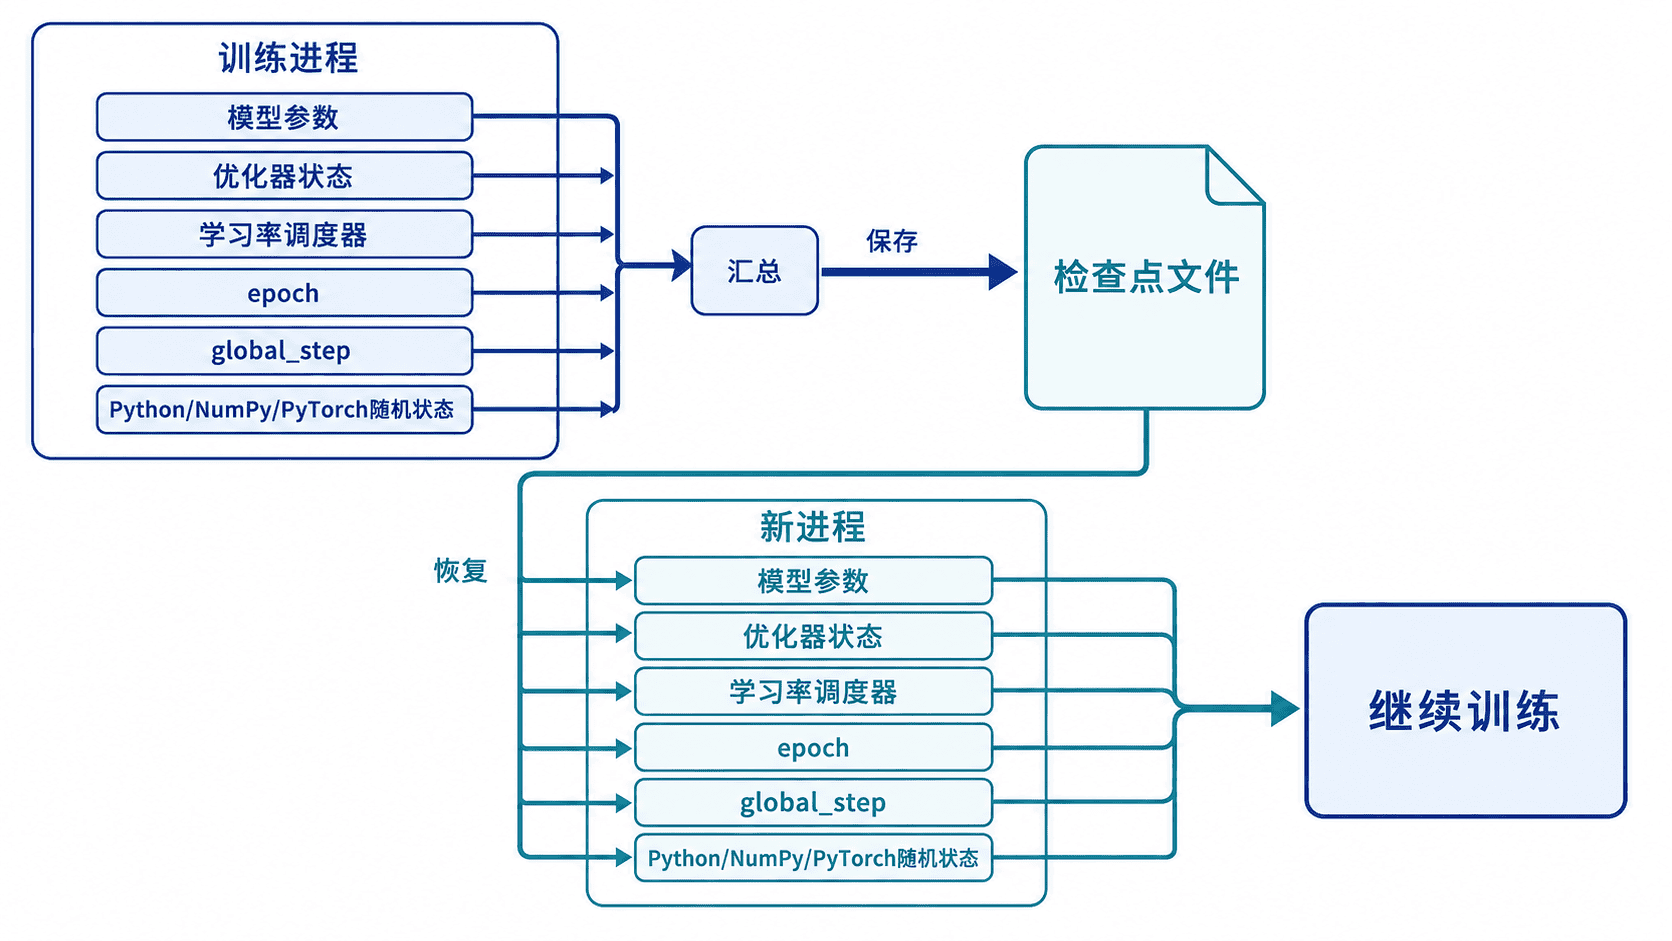
保存完整训练状态
下面的程序在合成数据上训练两步,使用临时文件加 os.replace 原子替换检查点,再创建一套新对象加载状态并继续训练。torch.load(..., weights_only=False) 只应用于自己生成且可信的检查点,因为其中包含 Python 和 NumPy 状态。
import os
import random
from pathlib import Path

import numpy as np
import torch
from torch import nn
from torch.optim import Adam
from torch.optim.lr_scheduler import StepLR

def save_checkpoint(path, model, optimizer, scheduler, epoch, global_step):
    checkpoint = {
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "scheduler": scheduler.state_dict(),
        "epoch": epoch,
        "global_step": global_step,
        "python_rng": random.getstate(),
        "numpy_rng": np.random.get_state(),
        "torch_rng": torch.get_rng_state(),
    }
    if torch.cuda.is_available():
        checkpoint["cuda_rng"] = torch.cuda.get_rng_state_all()

    path = Path(path)
    temp_path = path.with_suffix(path.suffix + ".tmp")
    torch.save(checkpoint, temp_path)
    os.replace(temp_path, path)  # 同一文件系统内原子替换,避免半写入文件

def load_checkpoint(path, model, optimizer, scheduler, device):
    # 仅对自己生成且可信的文件关闭 weights_only 限制
    checkpoint = torch.load(path, map_location=device, weights_only=False)
    model.load_state_dict(checkpoint["model"])
    optimizer.load_state_dict(checkpoint["optimizer"])
    scheduler.load_state_dict(checkpoint["scheduler"])

    random.setstate(checkpoint["python_rng"])
    np.random.set_state(checkpoint["numpy_rng"])
    # map_location 可能把随机状态张量映射到 GPU,恢复前转回 CPU
    torch.set_rng_state(checkpoint["torch_rng"].cpu())
    if device.type == "cuda" and "cuda_rng" in checkpoint:
        cuda_rng = [state.cpu() for state in checkpoint["cuda_rng"]]
        torch.cuda.set_rng_state_all(cuda_rng)

    return checkpoint["epoch"], checkpoint["global_step"]

def train_step(model, optimizer, x, y):
    optimizer.zero_grad()
    loss = nn.functional.mse_loss(model(x), y)
    loss.backward()
    optimizer.step()
    return loss.item()

def main():
    # 三套随机源必须使用同一实验种子并分别保存
    random.seed(7)
    np.random.seed(7)
    torch.manual_seed(7)

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    x = torch.tensor([[1.0], [2.0], [3.0]], device=device)
    y = torch.tensor([[2.0], [4.0], [6.0]], device=device)

    model = nn.Linear(1, 1).to(device)
    optimizer = Adam(model.parameters(), lr=0.01)
    scheduler = StepLR(optimizer, step_size=1, gamma=0.9)

    global_step = 0
    for _ in range(2):
        train_step(model, optimizer, x, y)
        global_step += 1
    scheduler.step()
    save_checkpoint("checkpoint.pt", model, optimizer, scheduler, epoch=1, global_step=global_step)

    # 新建对象模拟进程退出后重新启动,而不是复用内存中的旧对象
    resumed_model = nn.Linear(1, 1).to(device)
    resumed_optimizer = Adam(resumed_model.parameters(), lr=0.01)
    resumed_scheduler = StepLR(resumed_optimizer, step_size=1, gamma=0.9)

    epoch, global_step = load_checkpoint(
        "checkpoint.pt",
        resumed_model,
        resumed_optimizer,
        resumed_scheduler,
        device,
    )
    loss = train_step(resumed_model, resumed_optimizer, x, y)
    global_step += 1

    print(f"resumed_epoch={epoch}")
    print(f"global_step={global_step}")
    print(f"learning_rate={resumed_optimizer.param_groups[0]['lr']:.4f}")
    print(f"loss={loss:.6f}")

if __name__ == "__main__":
    main()
预期输出中损失值可能因 PyTorch 版本和运行设备略有差异,但恢复后的轮次、步数和学习率应一致。
resumed_epoch=1
global_step=3
learning_rate=0.0090
loss=<LOSS>
安全恢复与验证
恢复顺序应先创建相同结构的模型、优化器和调度器,再分别加载状态。加载到不同设备时使用 map_location;恢复后不要额外调用一次 scheduler.step(),否则学习率会提前推进。
验证时先检查 epoch、global_step 和当前学习率,再比较恢复前后的关键参数。生产训练还应保留最近检查点与最佳检查点两个独立文件,并在保存完成后更新“latest”指针,避免覆盖唯一可用副本。
若模型结构、参数组或调度策略已经改变,不应强行断点续训。此时应把旧权重作为预训练参数加载,并重新初始化优化器和调度器。
本课总结
- 可续训检查点必须覆盖参数、优化状态、训练进度和随机状态
- 临时文件加原子替换能降低检查点半写入风险
- 恢复后应校验步数、学习率与参数,而不是只看文件加载成功
下一课预告
下一课将把一次训练扩展为可追溯实验,统一记录代码、数据、环境、配置、权重和指标版本。