
机器学习与深度学习 / 系统课时
数据增强与早停
数据增强与早停
数据增强负责扩大训练样本的有效变化范围,早停和检查点负责控制训练何时结束、最终保留哪个模型。本课将两者组合成一条可验证的训练控制链路,避免增强破坏标签,也避免保存最后一轮而丢失最佳参数。
学习目标
- 根据任务语义选择不会改变标签的数据增强
- 实现基于验证损失的早停与最佳检查点保存
- 建立训练集、验证集和最终模型之间的正确使用顺序
先判断增强是否保持标签
数据增强不是随机变化越多越好,而是要模拟部署阶段可能出现、同时不改变目标含义的变化。增强只应用于训练集;验证集和测试集应保持确定性,才能真实比较不同轮次的模型。
| 任务 | 可优先尝试 | 需要谨慎 |
|---|---|---|
| 图像分类 | 裁剪、轻微翻转、颜色扰动 | 可能改变类别方向的旋转或镜像 |
| 检测与分割 | 缩放、裁剪、翻转 | 图像变换后未同步框和掩码 |
| 时间序列 | 小幅噪声、时间平移 | 打乱时间顺序或破坏峰值语义 |
| 文本分类 | 同义改写、受控遮盖 | 任意删词导致语义或标签翻转 |
增强强度应通过验证集结果决定。若训练准确率下降但验证指标改善,说明增强可能在发挥正则化作用;若训练和验证同时明显恶化,应先降低增强概率或幅度。
训练控制流程
早停关注验证指标是否持续改善,检查点则在每次出现新最佳结果时保存参数。二者必须配合:停止训练时应恢复最佳检查点,而不是直接使用触发停止的最后一轮参数。
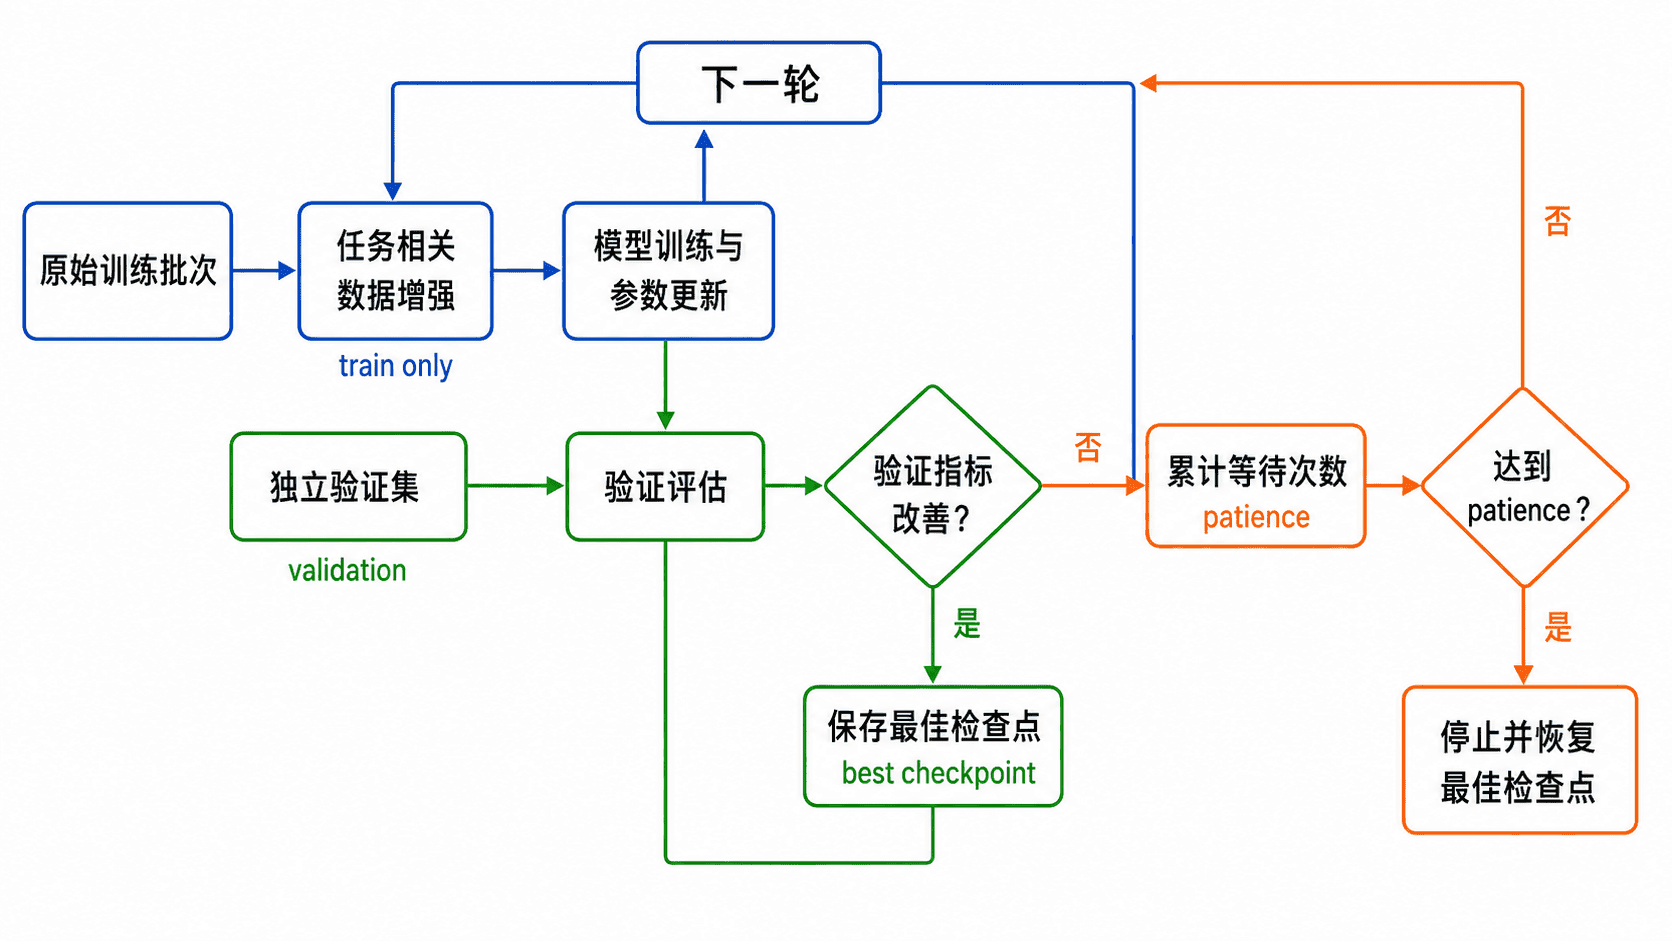
patience 表示允许连续多少轮没有改善,min_delta 表示至少改善多少才算真正进步。验证指标波动较大时,可适当增加 patience;训练成本高或过拟合出现很快时,应缩短等待窗口。
主示例:增强、检查点和早停
下面用张量翻转与轻微噪声模拟图像增强,并用一组固定验证损失演示最佳模型保存和早停。真实训练时,把 validation_losses 替换为每轮验证得到的损失即可。
import os

import torch
from torch import nn

torch.manual_seed(7)

def augment_batch(images: torch.Tensor) -> torch.Tensor:
    """只对训练批次使用的轻量增强。"""
    result = images.clone()
    if torch.rand(()) < 0.5:
        result = torch.flip(result, dims=[-1])
    noise = 0.01 * torch.randn_like(result)
    return (result + noise).clamp(0.0, 1.0)

class EarlyStopping:
    def __init__(self, patience: int, path: str, min_delta: float = 0.0):
        self.patience = patience
        self.path = path
        self.min_delta = min_delta
        self.best_loss = float("inf")
        self.wait = 0

    def step(self, val_loss: float, model: nn.Module) -> str:
        # 只有达到最小改善幅度时才覆盖最佳检查点
        if val_loss < self.best_loss - self.min_delta:
            self.best_loss = val_loss
            self.wait = 0
            torch.save(model.state_dict(), self.path)
            return "saved"

        self.wait += 1
        return "stop" if self.wait >= self.patience else "wait"

model = nn.Linear(4, 2)
images = torch.zeros(2, 3, 8, 8)
augmented = augment_batch(images)
stopper = EarlyStopping(patience=2, path="best-model.pt")

print("augmented shape:", tuple(augmented.shape))

validation_losses = [0.62, 0.51, 0.49, 0.50, 0.52, 0.54]
for epoch, val_loss in enumerate(validation_losses, start=1):
    state = stopper.step(val_loss, model)
    if state == "saved":
        print(f"epoch={epoch} val_loss={val_loss:.2f} checkpoint=saved")
    elif state == "wait":
        print(f"epoch={epoch} val_loss={val_loss:.2f} wait={stopper.wait}/2")
    else:
        print(f"epoch={epoch} val_loss={val_loss:.2f} early_stop=True")
        break

print("checkpoint exists:", os.path.exists("best-model.pt"))
os.remove("best-model.pt")
预期输出
augmented shape: (2, 3, 8, 8)
epoch=1 val_loss=0.62 checkpoint=saved
epoch=2 val_loss=0.51 checkpoint=saved
epoch=3 val_loss=0.49 checkpoint=saved
epoch=4 val_loss=0.50 wait=1/2
epoch=5 val_loss=0.52 early_stop=True
checkpoint exists: True
示例在第 3 轮保存最低验证损失对应的参数,第 5 轮累计两次未改善后停止。正式训练结束后,应重新加载 best-model.pt 再评估或部署;示例最后删除文件,只是为了避免留下临时产物。
验收与常见错误
先确认增强只出现在训练数据管道中,并抽样检查增强后的图像、框、掩码或文本标签是否仍然一致。对于检测和分割任务,几何变化必须同步作用于标注。
再确认监控指标与保存规则一致。若以验证损失早停,就应在损失降低时保存;若以准确率或 F1 分数早停,则判断方向要改为数值升高。
最后用最佳检查点在未参与调参的测试集上评估一次。不要根据测试集结果反复修改增强和 patience,否则测试集会逐渐变成隐藏的验证集。
本课总结
- 数据增强必须保持标签语义,并且只应用于训练集
- 早停依据验证指标控制训练长度,检查点负责保存最佳参数
- 停止后应恢复最佳检查点,而不是直接使用最后一轮模型
下一课预告
下一课将继续讨论泛化评估,重点分析训练集、验证集与测试集的职责,以及如何识别数据泄漏和分布偏移。