
机器学习与深度学习 / 系统课时
搭建基础卷积网络
搭建基础卷积网络
本课将把卷积、批归一化、激活函数、池化与分类头连接成一个可运行的图像分类模型,并通过随机输入验证张量形状和参数规模。
学习目标
- 理解基础卷积分类网络从图像到类别得分的数据流。
- 使用 PyTorch 组合卷积、归一化、激活、池化和分类头。
- 通过输出形状、参数量与数值检查完成结构验收。
网络结构如何连接
图像张量通常采用 [批量, 通道, 高度, 宽度] 排列。特征提取部分逐步增加通道数、压缩空间尺寸,分类头再把二维特征汇总成固定长度向量,最终输出每个类别的 logits。
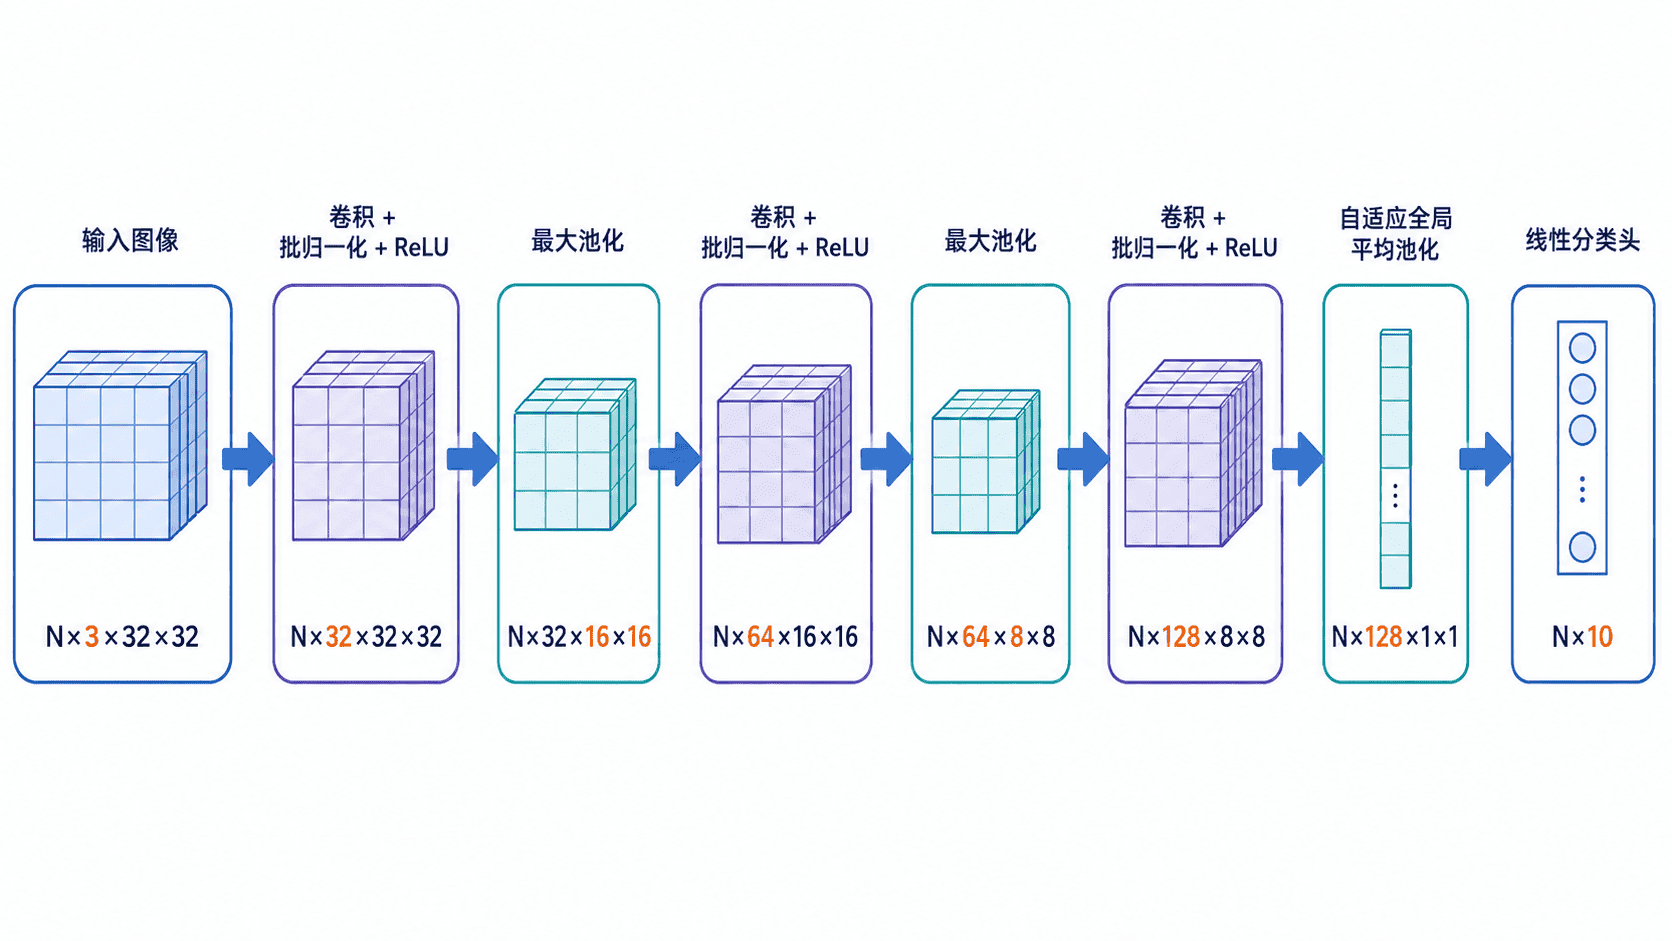
前两次最大池化把 32×32 依次缩小为 16×16 和 8×8。最后使用自适应平均池化,不再把分类头绑定到某个固定输入尺寸,因此同一模型也能接收其他合理尺寸的图像。
实现可运行模型
下面的程序定义一个三阶段卷积网络。它不依赖真实数据集,而是先用随机图像完成结构检查;确认输入输出和参数都正常后,再接入训练数据。
import torch
from torch import nn

class BasicCNN(nn.Module):
    def __init__(self, num_classes: int = 10) -> None:
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(32),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2),
            nn.Conv2d(32, 64, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2),
            nn.Conv2d(64, 128, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(128),
            nn.ReLU(inplace=True),
        )
        # 自适应池化把任意空间尺寸压缩为 1×1,避免手工计算展平维度。
        self.pool = nn.AdaptiveAvgPool2d((1, 1))
        self.classifier = nn.Linear(128, num_classes)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = self.pool(x)
        x = torch.flatten(x, start_dim=1)
        return self.classifier(x)

def main() -> None:
    torch.manual_seed(42)
    model = BasicCNN(num_classes=10)
    images = torch.randn(4, 3, 32, 32)

    logits = model(images)
    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)

    print(f"logits shape: {tuple(logits.shape)}")
    print(f"trainable parameters: {trainable}")
    print(f"all logits finite: {torch.isfinite(logits).all().item()}")

if __name__ == "__main__":
    main()
预期输出
logits shape: (4, 10)
trainable parameters: 94762
all logits finite: True
这里的 10 表示类别数量,而不是概率。训练时应把 logits 直接交给 nn.CrossEntropyLoss,不要在模型末尾额外添加 Softmax;推理展示概率时再单独调用 torch.softmax。
读懂关键组件
卷积层负责在局部区域内提取边缘、纹理和更高层特征。连续阶段把通道数从 3 提升到 128,让网络拥有更多特征表达能力。
批归一化放在卷积之后、激活之前,用于稳定中间特征分布;ReLU 引入非线性,否则多层线性运算仍可合并成一次线性变换。最大池化降低空间分辨率,也减少后续计算量。
自适应平均池化把每个通道汇总为一个值,线性层只负责把 128 维特征映射到类别数。这样的分类头参数少,也比直接展平整张特征图更不容易过拟合。
运行验收与常见错误
结构验收至少检查三件事:输出第一维是否等于批量大小,第二维是否等于类别数,以及输出中是否存在 NaN 或无穷值。真实训练前还应拿一个数据批次运行一次前向传播和反向传播。
常见问题包括输入通道不是模型要求的 3、标签类别数与分类头不一致,以及使用固定展平尺寸导致更换图片大小后报错。推理时还要调用 model.eval(),避免批归一化继续使用当前批次统计量。
本课总结
- 基础卷积分类器由特征提取、空间汇总和线性分类三部分组成。
- 自适应平均池化可以解除分类头对固定图像尺寸的依赖。
- 随机输入的形状、参数量和有限值检查能在训练前发现多数结构错误。
下一课预告
下一课将对比 VGG 的规则堆叠、ResNet 的残差连接和深度可分离卷积,理解经典 CNN 如何在深度、精度与计算成本之间取舍。