
机器学习与深度学习 / 系统课时
设计推理预处理流程
设计推理预处理流程
本课把原始图像到最终标签之间的推理链路固定下来,统一输入尺寸、数值范围、归一化参数和标签顺序,并用一个可运行示例验证预处理、模型调用与后处理能够稳定衔接。
学习目标
- 定义可校验的模型输入与输出契约
- 实现与训练阶段一致的预处理和标签映射
- 识别常见的训练推理偏差并完成验收
先定义推理契约
推理代码不能只约定“传入一张图片”。至少要固定通道顺序、张量形状、数据类型、像素范围、缩放方式、归一化参数和批次维度。输出侧还要固定标签列表的顺序,以及是否执行 Softmax、Top-K 或阈值过滤。
| 环节 | 本课约定 | 校验目的 |
|---|---|---|
| 原始输入 | CHW、3 通道、float32、取值 [0, 1] |
防止把 HWC、灰度图或 0~255 数据直接送入模型 |
| 空间处理 | 双线性缩放到 224×224 |
保证模型收到固定尺寸 |
| 数值处理 | 使用训练时相同的均值和标准差 | 避免特征分布发生偏移 |
| 模型输出 | 未归一化的 logits | 不在模型内部重复执行 Softmax |
| 后处理 | Softmax、Top-K、标签映射 | 将类别索引转换为稳定的业务结果 |
这些值应与模型版本一起发布,而不是分别硬编码在训练脚本、服务代码和客户端中。只要其中一处参数变化,就应同步提升预处理配置版本。
串起完整推理链路
一条完整链路依次经过输入校验、尺寸调整、归一化、批次扩展、模型前向计算、概率转换和标签映射。把这些步骤显式拆开,才能在结果异常时判断偏差发生在哪一层。
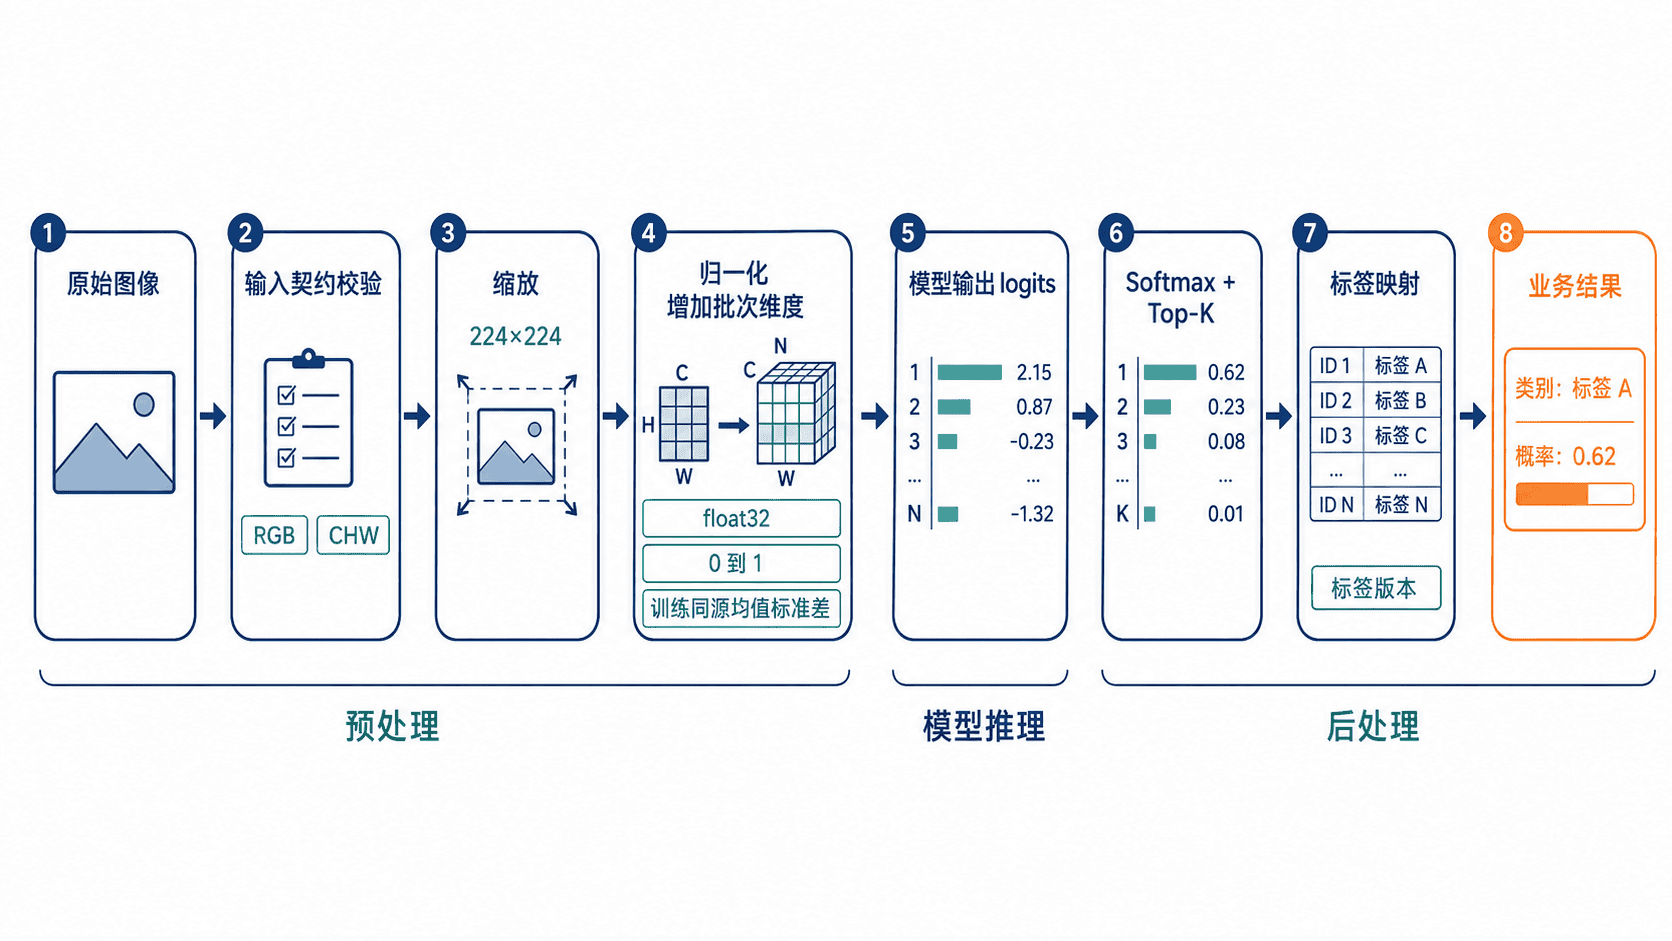
下面的示例用一个确定性分类器演示流程。真实项目只需替换模型类,预处理和后处理接口可以保持不变。
import torch
from torch import nn
from torch.nn import functional as F

# 这些常量共同构成模型的输入与标签契约。
LABELS = ["cat", "dog", "bird"]
IMAGE_SIZE = (224, 224)
MEAN = torch.tensor([0.485, 0.456, 0.406]).view(3, 1, 1)
STD = torch.tensor([0.229, 0.224, 0.225]).view(3, 1, 1)

class DemoClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        # 使用缓冲区保存固定参数,便于得到可重复的演示结果。
        self.register_buffer(
            "weight",
            torch.tensor(
                [
                    [0.6, -0.2, 0.1],
                    [-0.1, 0.5, 0.2],
                    [0.2, 0.1, 0.4],
                ]
            ),
        )
        self.register_buffer("bias", torch.tensor([0.1, 0.0, -0.05]))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        channel_mean = x.mean(dim=(2, 3))
        return channel_mean @ self.weight.T + self.bias

def preprocess(image: torch.Tensor) -> torch.Tensor:
    if image.ndim != 3 or image.shape[0] != 3:
        raise ValueError("image must use CHW format with 3 channels")

    min_value = image.min().item()
    max_value = image.max().item()
    if image.dtype != torch.float32 or min_value < 0.0 or max_value > 1.0:
        raise ValueError("image must be float32 in [0, 1]")

    # 先增加批次维度,再执行可批处理的空间变换。
    batch = image.unsqueeze(0)
    batch = F.interpolate(
        batch,
        size=IMAGE_SIZE,
        mode="bilinear",
        align_corners=False,
    )
    return (batch - MEAN) / STD

def postprocess(
    logits: torch.Tensor,
    top_k: int = 2,
) -> list[dict[str, float | str]]:
    # Softmax 只在输出解释阶段执行,模型仍返回 logits。
    probabilities = torch.softmax(logits, dim=1)[0]
    scores, indices = torch.topk(probabilities, k=top_k)
    return [
        {"label": LABELS[index], "score": round(score.item(), 4)}
        for score, index in zip(scores, indices.tolist())
    ]

def main() -> None:
    image = torch.empty(3, 300, 500, dtype=torch.float32)
    image[0].fill_(0.8)
    image[1].fill_(0.4)
    image[2].fill_(0.2)

    model = DemoClassifier().eval()
    # 推理模式关闭梯度记录,减少额外内存和计算开销。
    with torch.inference_mode():
        logits = model(preprocess(image))
        result = postprocess(logits)

    print(result)

if __name__ == "__main__":
    main()
预期输出:
[{'label': 'cat', 'score': 0.6193}, {'label': 'bird', 'score': 0.2168}]示例先拒绝错误形状、类型和像素范围,再统一尺寸与归一化。后处理只依赖固定标签表,因此模型输出索引 0 始终对应 cat,不会因为服务端标签顺序变化而产生静默错误。
避免训练推理偏差
最常见的问题不是模型无法运行,而是模型能够返回结果却持续变差。训练时使用随机裁剪,推理时通常应改为确定性的缩放或中心裁剪;训练读取 RGB,部署端若使用 OpenCV 默认 BGR,就必须显式转换通道顺序。
还要逐项核对像素是否已经除以 255、归一化是否重复执行、标签列表是否与训练类别索引一致,以及批量推理时是否保留 NCHW 维度。模型加载后必须调用 eval(),推理阶段应使用 torch.inference_mode()。
验收推理流程
至少准备一组固定样本作为冒烟测试,并保存其模型版本、预处理版本和期望 Top-K。正常样本应得到稳定结果,错误通道数和越界像素应被明确拒绝,而不是在模型深处产生难以定位的形状异常。
上线日志应记录模型版本、标签版本、输入尺寸和处理耗时,但不要记录原始敏感图像。若训练代码调整了裁剪、颜色空间或归一化参数,必须让同一组冒烟样本重新通过验收。
本课总结
- 推理契约必须同时固定输入形状、数值处理和标签顺序
- 预处理、模型前向与后处理应拆分并分别校验
- 固定样本冒烟测试能及时发现训练与推理实现偏差
下一课预告
下一课将保存模型权重与必要元数据,并通过安全加载、设备映射和输出一致性检查,保证模型文件能够可靠进入部署流程。