
机器学习与深度学习 / 系统课时
语义分割任务结构
语义分割任务结构
语义分割要为图像中的每个像素预测类别。本课从张量形状出发,拆解编码器、解码器、输出层与指标之间的关系,并用一个最小可运行示例验证模型输出能否直接参与训练。
学习目标
- 区分图像分类、目标检测与语义分割的输出差异
- 读懂编码器、解码器和跳跃连接各自承担的职责
- 正确使用交叉熵、IoU 与 Dice 检查分割结果
从像素级分类理解任务
图像分类只输出整张图的类别,语义分割则保留空间位置,为每个像素给出类别。输入通常是 [N, C, H, W],标签通常是 [N, H, W],其中每个标签值都是整数类别编号。
若任务有 4 个类别,模型输出应为 [N, 4, H, W]。第二个维度保存每个类别的未归一化分数,最终对该维度取最大值,即可得到 [N, H, W] 的预测掩码。
编码器与解码器如何协作
编码器通过卷积和下采样扩大感受野,将边缘、纹理逐步压缩为高层语义;解码器再把低分辨率特征恢复到原图大小。只依赖深层特征容易丢失边界,因此常用跳跃连接把浅层细节送入对应的解码阶段。
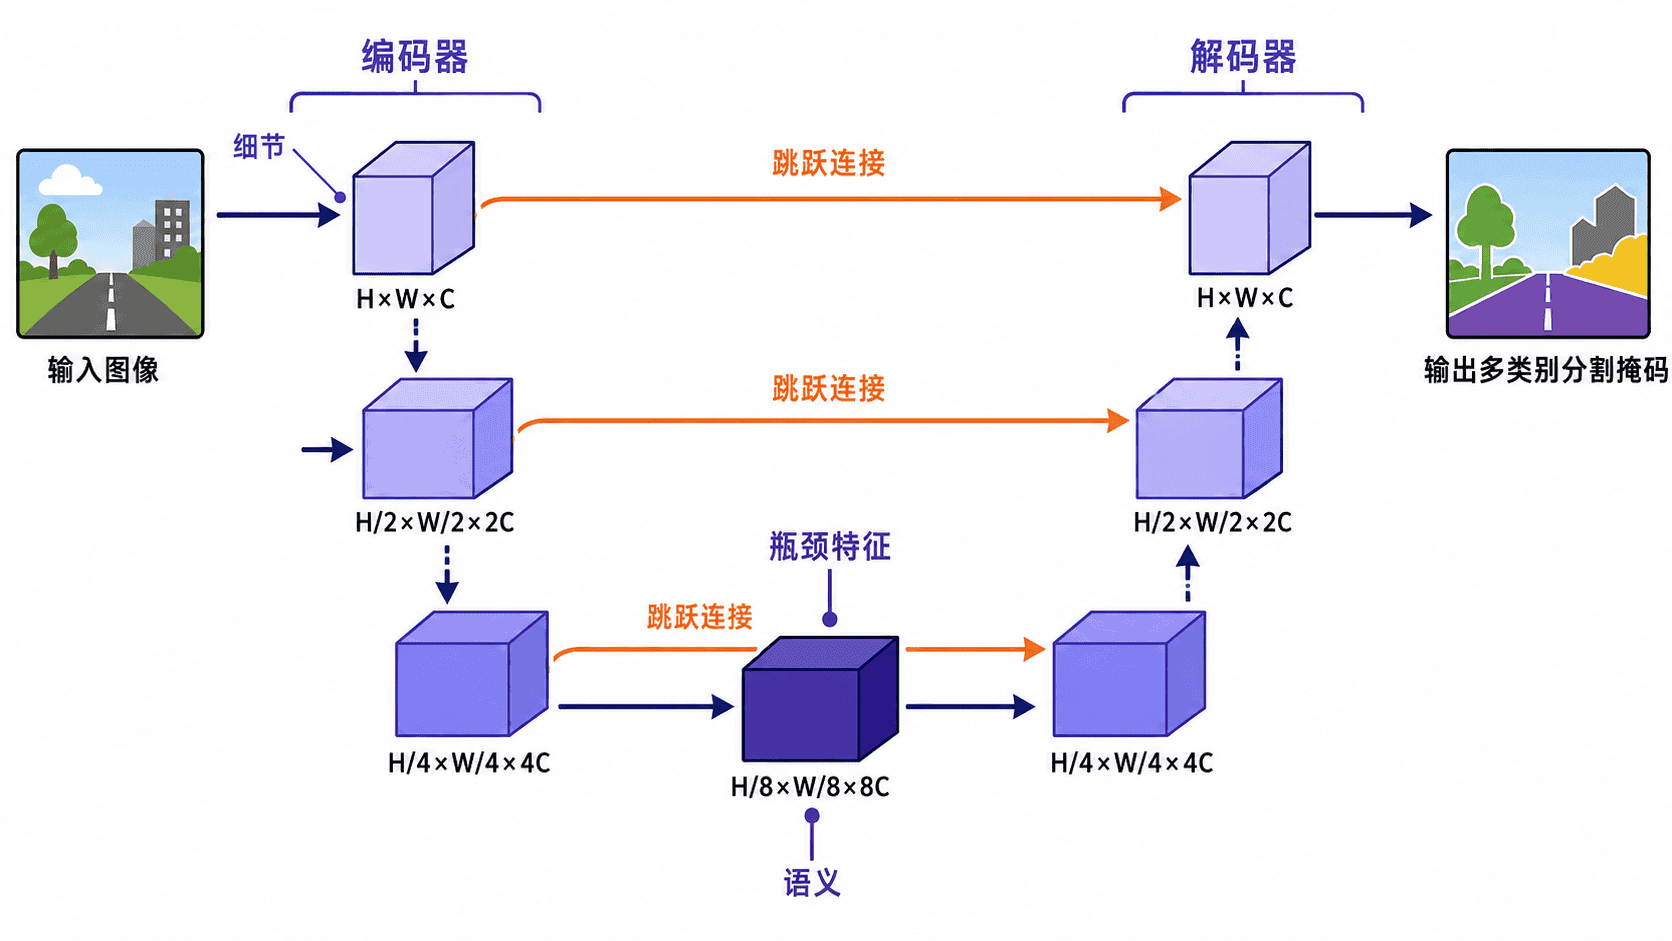
编码器可以来自预训练分类网络,但分类头必须移除;解码器可使用转置卷积、插值加卷积或专用分割模块。无论结构如何变化,最终输出的高度和宽度都必须与标签对齐。
输出层与损失函数
多类别分割通常使用 CrossEntropyLoss。模型最后一层输出每个类别的 logits,不要提前调用 softmax;标签应是整数类型,且不包含类别通道。下面的最小模型只用于验证接口和张量形状,不代表完整分割网络。
import torch
from torch import nn

torch.manual_seed(0)

images = torch.randn(2, 3, 64, 64)
masks = torch.randint(0, 4, (2, 64, 64))

model = nn.Sequential(
    nn.Conv2d(3, 16, kernel_size=3, padding=1),
    nn.ReLU(),
    nn.Conv2d(16, 4, kernel_size=1),
)

logits = model(images)
loss = nn.CrossEntropyLoss()(logits, masks)

print(logits.shape)
print(masks.shape)
print(loss.ndim, loss.item() > 0)
预期输出:
torch.Size([2, 4, 64, 64])
torch.Size([2, 64, 64])
0 True
这说明输出类别数、空间尺寸和标签格式能够对齐,损失也被归约为一个标量。真实任务还需处理无效像素,可通过 ignore_index 排除边界外或未标注区域。
常用指标与边界
像素准确率容易被大面积背景“冲高”,因此分割任务更常看 IoU、mIoU 和 Dice。单个类别的 IoU 为:
Dice 更强调预测区域与真实区域的重叠:
| 指标 | 适合回答的问题 | 主要限制 |
|---|---|---|
| 像素准确率 | 总体有多少像素预测正确 | 类别不平衡时可能虚高 |
| IoU / mIoU | 各类别区域重叠是否可靠 | 空类别的统计规则需统一 |
| Dice | 小目标或前景区域是否充分重叠 | 不能单独解释误检来源 |
计算指标时要固定是否包含背景类,并明确“某类别在标签和预测中都不存在”时如何处理。训练、验证和线上评估必须使用同一套规则,否则数值无法直接比较。
本课总结
- 语义分割的本质是对每个像素做分类,输出必须与标签空间尺寸一致
- 编码器提取语义,解码器恢复分辨率,跳跃连接补回边界细节
- 交叉熵负责训练,mIoU 与 Dice 更适合衡量区域重叠质量
下一课预告
下一课将建立视觉模型错误分析方法,按类别、尺度、遮挡和背景条件定位数据或模型的薄弱环节。