
机器学习与深度学习 / 系统课时
生成模型的任务与评估
生成模型的任务与评估
生成模型的核心不是判断输入属于哪一类,而是学习数据如何产生,并据此估计概率、生成新样本或按条件生成结果。本课将拆清三类任务,并建立“质量与多样性必须同时评估”的判断框架。
学习目标
- 区分密度建模、无条件采样和条件生成
- 理解生成质量、分布覆盖与模式崩塌之间的关系
- 根据模型能力选择合适的自动指标与人工评估
生成模型的三类任务
判别模型通常学习从输入到标签的映射,例如判断一张图是不是猫。生成模型则试图逼近训练数据的分布,使模型能够回答“什么样的数据更可能出现”,并从这个分布中产生新样本。
| 任务 | 输入 | 输出 | 典型问题 |
|---|---|---|---|
| 密度建模 | 样本 x |
概率或对数似然 | 这个样本在数据分布中有多合理 |
| 无条件采样 | 随机噪声或随机状态 | 新样本 | 能否生成真实且不重复的内容 |
| 条件生成 | 条件 c 与随机性 |
满足条件的新样本 | 能否按类别、文本或属性控制结果 |
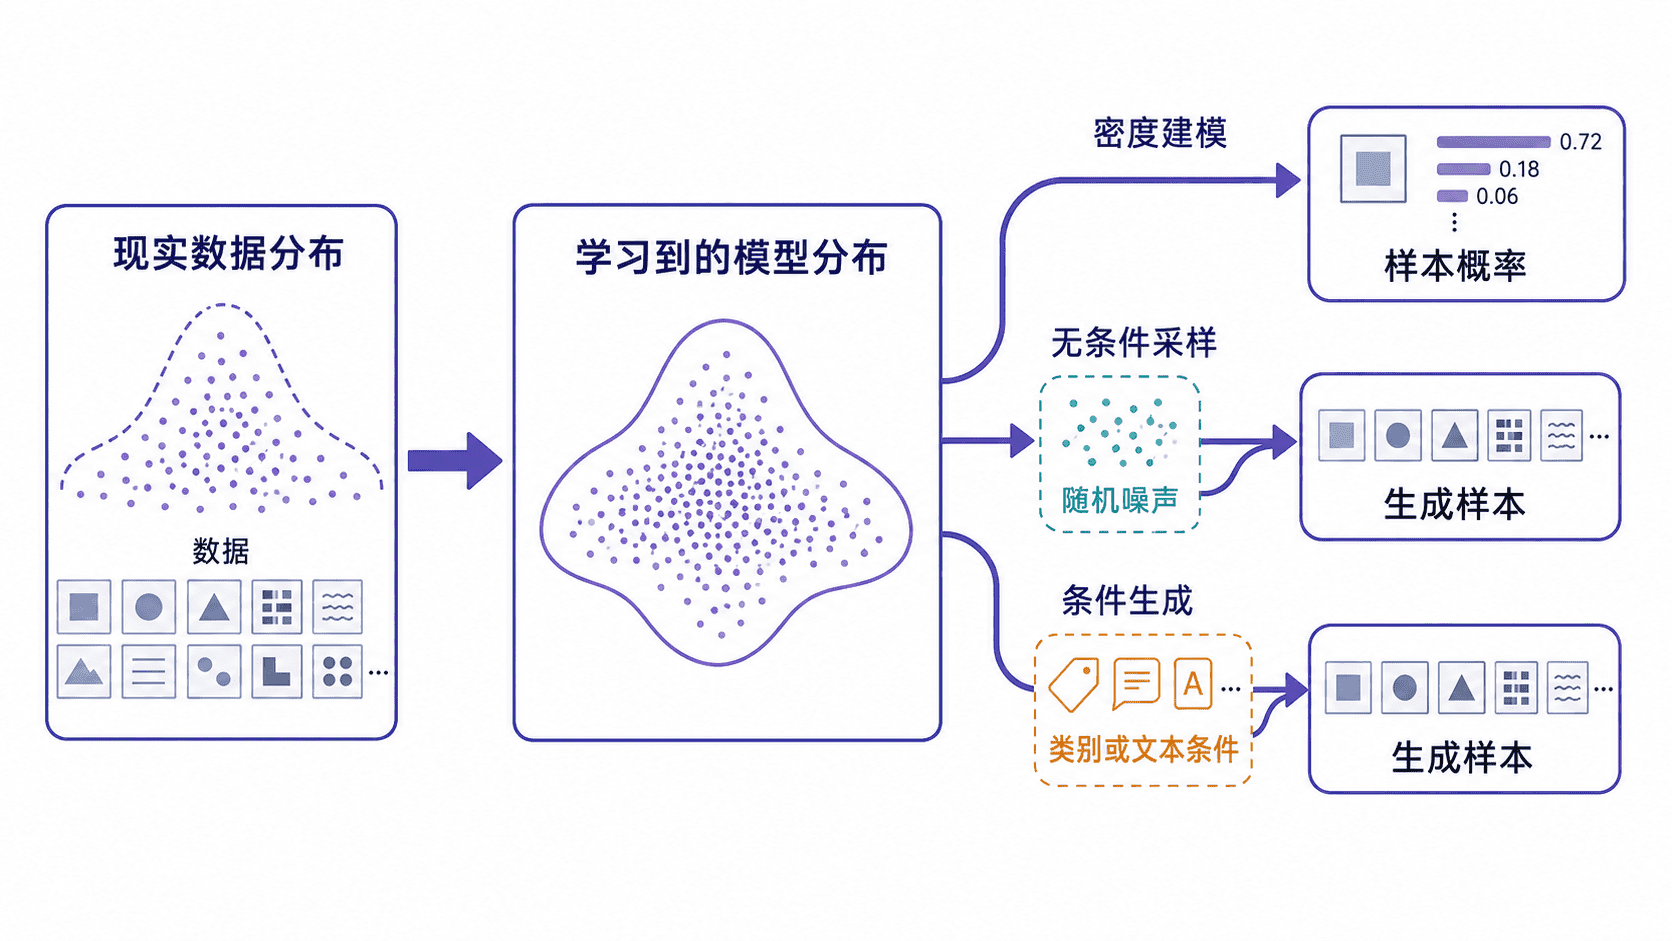
三类任务有关联,但并不等价。能够采样,不代表能够直接计算样本概率。GAN 可以生成图像,但通常没有可直接计算的显式似然;自回归模型和部分流模型则能分解或精确计算样本概率。
条件生成可以理解为“在条件 c 下生成 x”。条件可能是类别、文本、参考图像或结构约束。评估时除了真实性,还要检查结果是否遵守条件。
质量与多样性如何评估
单个样本很逼真,只能说明局部质量较高,不能证明模型覆盖了完整数据分布。模型若反复生成少数几种结果,会出现模式崩塌;若直接复制训练样本,则可能看起来真实,却没有学到可泛化的分布。
生成评估至少要同时回答两个问题:生成样本有多少落在真实数据附近,以及真实数据中的主要模式有多少被模型覆盖。前者偏向质量,后者偏向多样性与覆盖率。
可计算似然的模型可以报告负对数似然或每维比特数,但较好的似然不一定等于更符合人类感知。图像生成常用 FID 或 KID 比较真实样本与生成样本在特征空间中的分布差异;生成精度与召回率则分别观察样本质量和模式覆盖。
IS 不直接比较真实分布,主要反映分类置信度和类别分散程度。条件生成还应增加条件一致性指标,例如分类准确率、文本图像相似度或任务成功率。
指标只能回答其定义覆盖的问题。可靠结论通常来自自动指标、样本可视化、人工盲评和重复实验的组合。
用小实验观察两个维度
下面的二维示例不是 FID 的实现,而是用最近邻阈值直观演示质量与覆盖率。生成点靠近任意真实点时计为“质量合格”;真实点被任意生成点覆盖时计为“已覆盖”。
from math import dist

real_points = [
    (0, 0), (0, 1), (1, 0), (1, 1),
    (5, 5), (5, 6), (6, 5), (6, 6),
]

collapsed_samples = [(0, 0), (0, 1), (1, 0), (1, 1)]
broad_noisy_samples = real_points + [(10, 10), (12, 12)]

def evaluate(samples, threshold=0.25):
    # 质量:生成点中有多少靠近真实数据
    quality = sum(
        any(dist(sample, real) <= threshold for real in real_points)
        for sample in samples
    ) / len(samples)

    # 覆盖率:真实点中有多少被生成样本覆盖
    coverage = sum(
        any(dist(real, sample) <= threshold for sample in samples)
        for real in real_points
    ) / len(real_points)
    return quality, coverage

for name, samples in [
    ("模式收缩样本", collapsed_samples),
    ("广覆盖含噪声", broad_noisy_samples),
]:
    quality, coverage = evaluate(samples)
    print(f"{name} -> 质量:{quality:.2f}, 覆盖率:{coverage:.2f}")
预期输出
模式收缩样本 -> 质量:1.00, 覆盖率:0.50
广覆盖含噪声 -> 质量:0.80, 覆盖率:1.00
第一组样本都很真实,但只覆盖了一个数据簇;第二组覆盖全部真实点,却混入了离群点。结果说明质量和多样性必须分开观察,任何单一分数都可能掩盖模型缺陷。
本课总结
- 密度建模、采样和条件生成关注的输出不同,评估前要先确认模型能力
- 生成质量高不代表分布覆盖完整,模式崩塌和记忆训练样本都可能造成误判
- 自动指标应与可视化、人工评估和多次实验结合使用
下一课预告
下一课将构建自编码器,把输入压缩到潜在空间再完成重建,并分析潜在表示为什么能用于压缩、特征提取和异常检测。