
机器学习与深度学习 / 系统课时
扩散模型的核心过程
扩散模型的核心过程
扩散模型把“生成一个新样本”拆成两个方向相反的过程:训练时逐步给真实数据加噪声,模型学习不同噪声水平下的恢复方法;生成时再从随机噪声出发,反复去噪,得到符合数据分布与条件要求的结果。
学习目标
- 理解前向加噪与反向去噪各自承担的任务
- 说明时间步和噪声日程如何影响模型
- 理解文本、类别等条件怎样控制生成方向
前向加噪:把复杂生成变成分步修复
设原始样本为 ,前向过程在多个时间步中不断加入高斯噪声,得到 。时间步越靠后,原始结构越弱;到 时,样本通常已经接近随机噪声。
前向过程不需要神经网络,而是按照预设的噪声日程执行。它的价值不是生成内容,而是为训练制造不同难度的题目:模型只需在已知噪声水平的情况下,学习如何恢复更干净的样本。
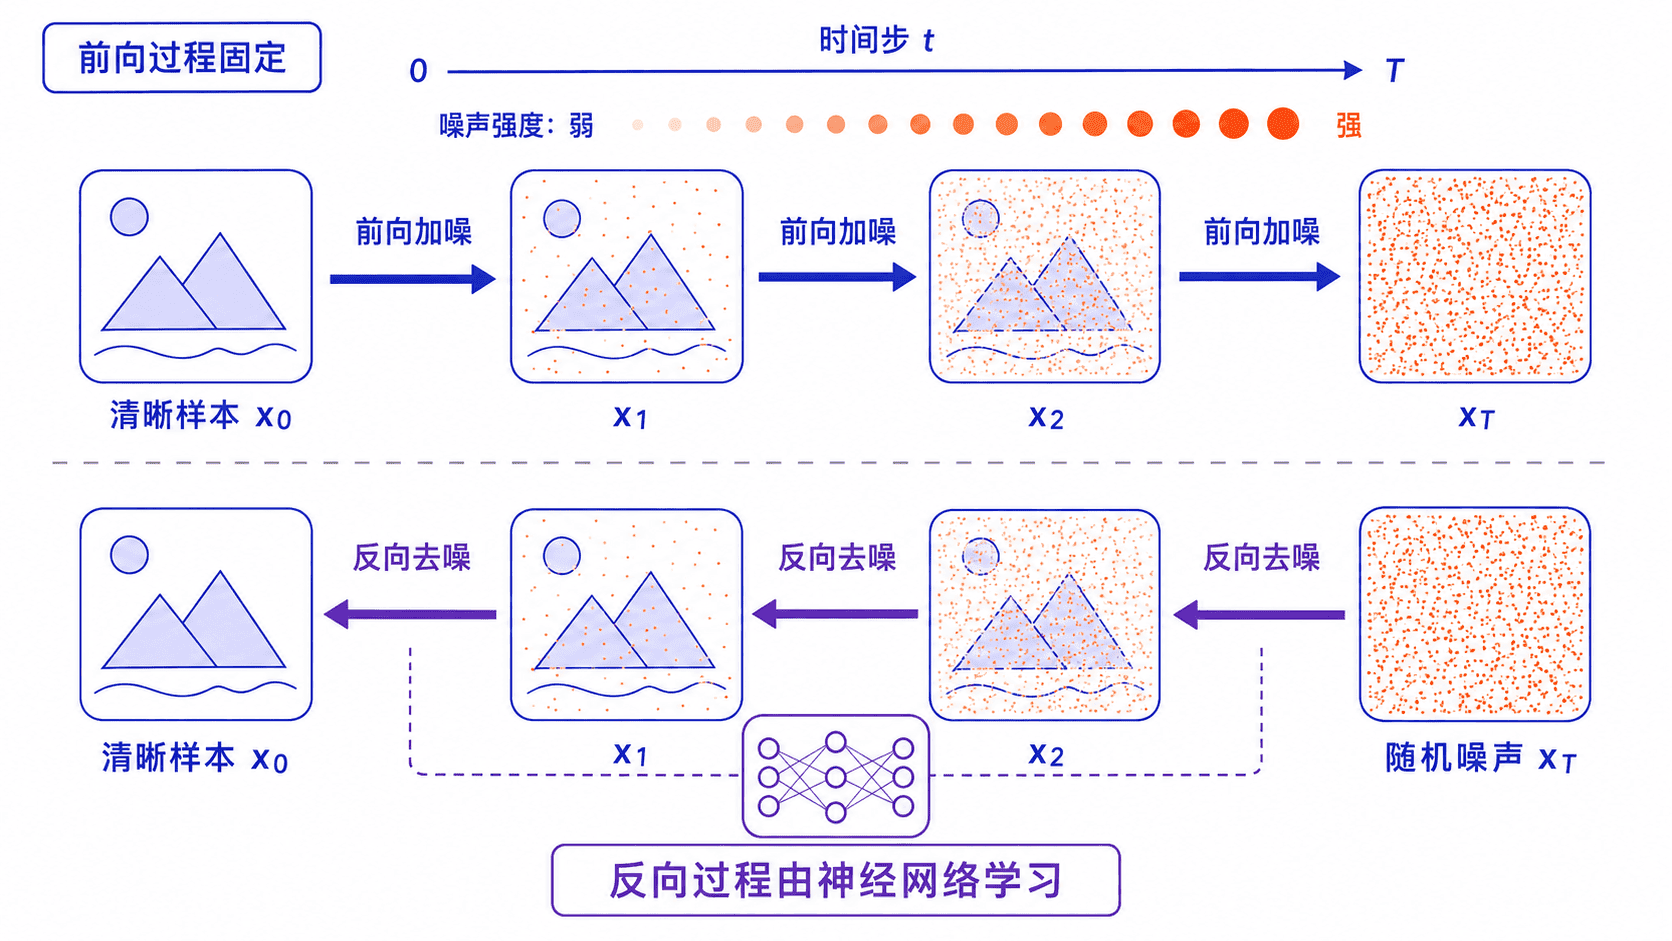
噪声日程决定每一步加入多少噪声,以及信息以什么速度消失。若前期噪声增长过快,模型很早就看不到有效结构;若增长过慢,则需要更多步骤才能接近纯噪声。合理的日程会让相邻时间步之间的恢复难度平滑变化。
反向去噪:从局部预测串成完整生成
常见训练方式会随机抽取时间步 ,直接构造该噪声水平下的样本 ,再让神经网络根据 和时间步 预测加入的噪声。预测越准确,模型越能掌握这一阶段的恢复规则。部分实现也会改为预测干净样本或速度参数,但核心仍是学习反向更新方向。
生成时没有真实样本可用,系统从随机噪声 开始。模型先估计当前应去除的噪声,再由采样器计算更干净的 ;这个过程持续到 。一次生成因此不是单次前向计算,而是一条由多个去噪步骤组成的迭代链路。
时间步不是普通序号,而是噪声水平的编码。模型必须知道当前样本有多“脏”,才能选择合适的恢复力度。
时间步通常会转换成向量嵌入,并注入神经网络的多个层。这样,同一个网络就能处理从“几乎清晰”到“接近纯噪声”的不同输入,而不必为每个时间步训练独立模型。
条件控制:让去噪朝目标方向收敛
无条件扩散模型只需生成“像训练数据”的样本;条件扩散模型还要满足文本、类别、边缘图或参考图等约束。条件信息会先编码成向量,再持续参与每一步去噪,使恢复过程朝指定语义或结构靠近。
以文本生成图像为例,同一份初始噪声在不同文本条件下会沿不同路径被去噪。条件引导较弱时,结果更自由但可能偏离描述;引导过强时,结果更贴合条件,但多样性可能下降,细节也可能被过度强化。
训练阶段可以从真实样本直接构造任意时间步,因此不同训练样本能够并行处理。生成阶段则依赖上一步结果,通常必须顺序执行多个去噪步骤。这解释了扩散模型为什么训练目标相对规整,却常有较高的推理延迟。
本课总结
- 前向过程按固定规则加噪,为模型制造不同难度的恢复任务
- 反向过程把各噪声水平下的局部预测串联成完整生成
- 时间步描述当前噪声程度,条件信息持续约束生成方向
下一课预告
下一课将把扩散模型与自编码器、VAE、GAN 放在同一组决策维度中比较,帮助你根据生成质量、速度、成本和任务类型选择合适路线。