
机器学习与深度学习 / 系统课时
学习率与调度策略
学习率与调度策略
学习率决定每次参数更新迈多大一步。本课将把固定、分段衰减、余弦退火、预热和按验证指标调整五类策略放进同一训练框架,并说明调用顺序、选型依据与恢复训练时的关键边界。
学习目标
- 理解学习率过大、过小以及动态调整带来的训练差异
- 能在 PyTorch 中配置五类常用调度策略
- 能根据训练轮数、验证指标和模型规模选择合适方案
学习率为什么需要变化
参数更新可以写成 。其中 是当前学习率:过大时损失可能震荡甚至发散,过小时训练稳定但收敛缓慢。训练早期通常需要较快探索,后期则需要更小步长精细收敛,因此学习率常随训练进程变化。
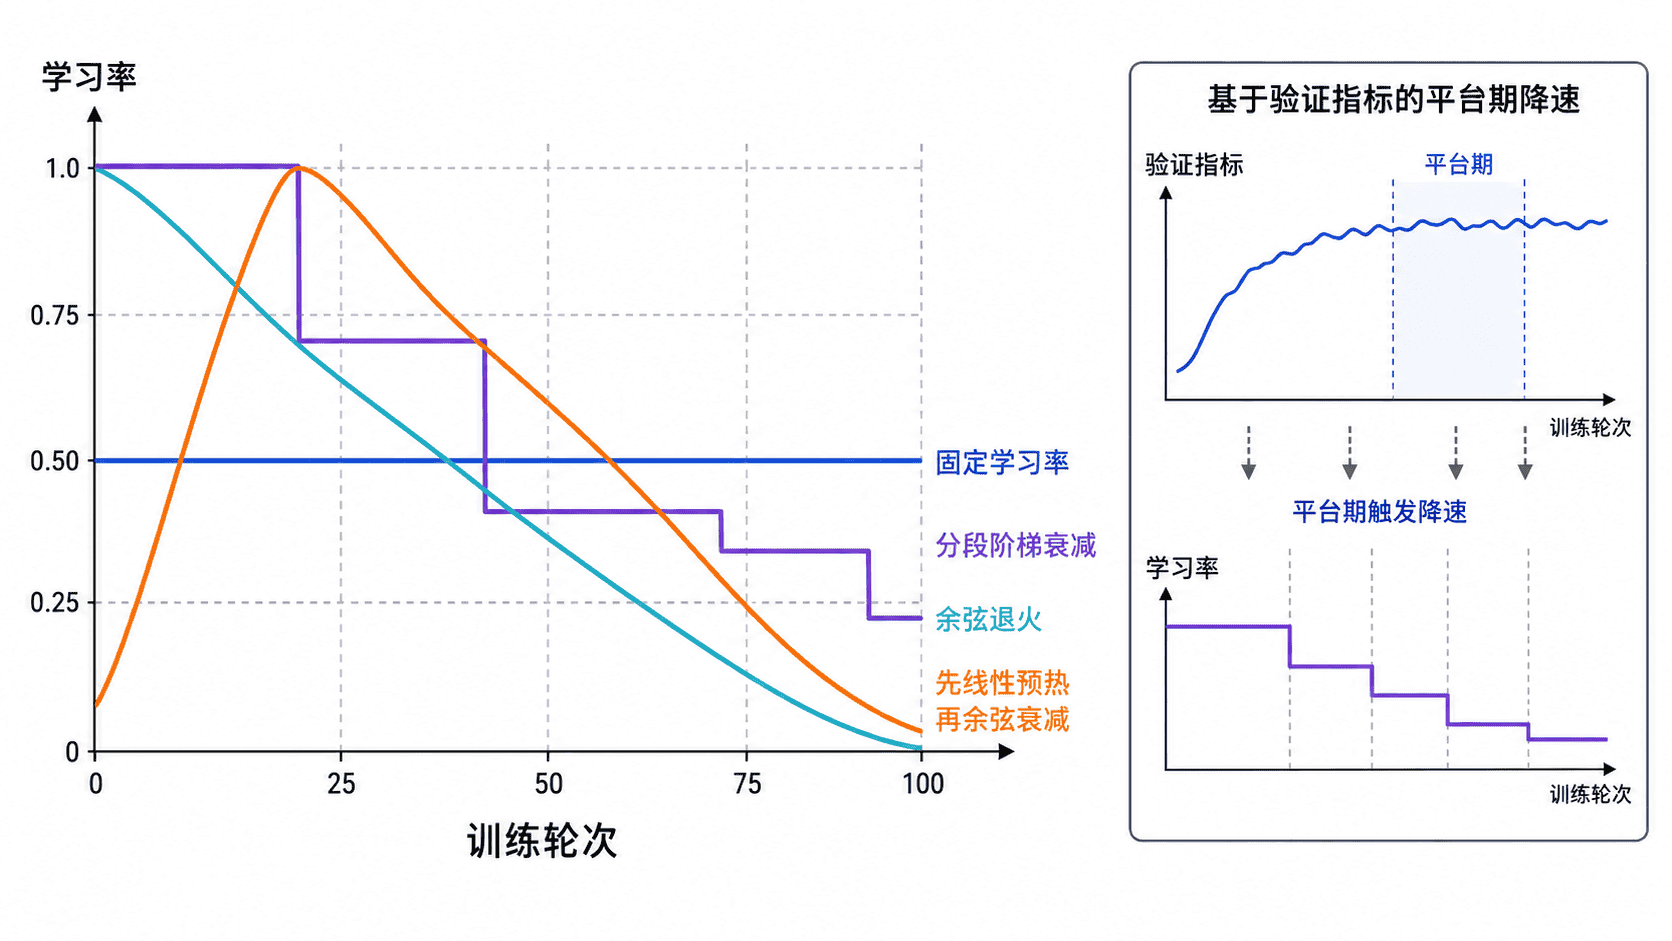
五类策略怎么选
| 策略 | 变化方式 | 适合场景 | 主要风险 |
|---|---|---|---|
| 固定学习率 | 全程不变 | 短实验、基线验证 | 后期可能在最优点附近震荡 |
| 分段衰减 | 到指定轮次乘衰减系数 | 训练阶段边界明确 | 阶跃位置需要人工设定 |
| 余弦退火 | 平滑下降到最小学习率 | 已知总训练轮数 | 总轮数改变时需重新配置 |
| 预热加衰减 | 先从小值升高,再逐步下降 | 大批量、Transformer、训练初期不稳定 | 预热过长会浪费训练预算 |
| 基于指标 | 验证指标停滞后降低 | 总轮数不确定、验证集可信 | 指标噪声会导致误降速 |
固定学习率最适合作为基线;训练计划明确时优先考虑余弦退火;初期容易不稳定时增加预热;只有验证指标能可靠反映泛化能力时,才使用基于指标的策略。
在 PyTorch 中统一实现
下面的完整程序为五类策略创建独立优化器,并记录每个 epoch 实际使用的学习率。示例不训练真实模型,只验证调度行为,便于直接观察策略差异。
python
import math

import torch

TOTAL_EPOCHS = 8
BASE_LR = 0.1

def new_optimizer():
    parameter = torch.nn.Parameter(torch.tensor(0.0))
    return torch.optim.SGD([parameter], lr=BASE_LR)

def warmup_cosine_factor(epoch):
    warmup_epochs = 2
    min_ratio = 0.1

    if epoch < warmup_epochs:
        return (epoch + 1) / warmup_epochs

    progress = (epoch - warmup_epochs + 1) / (TOTAL_EPOCHS - warmup_epochs)
    cosine = 0.5 * (1 + math.cos(math.pi * progress))
    return min_ratio + (1 - min_ratio) * cosine

def sample_epoch_scheduler(kind):
    optimizer = new_optimizer()

    if kind == "fixed":
        scheduler = None
    elif kind == "step":
        scheduler = torch.optim.lr_scheduler.StepLR(
            optimizer, step_size=3, gamma=0.1
        )
    elif kind == "cosine":
        scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(
            optimizer, T_max=TOTAL_EPOCHS, eta_min=0.01
        )
    elif kind == "warmup_cosine":
        scheduler = torch.optim.lr_scheduler.LambdaLR(
            optimizer, lr_lambda=warmup_cosine_factor
        )
    else:
        raise ValueError(f"unsupported strategy: {kind}")

    values = []
    for _ in range(TOTAL_EPOCHS):
        # 当前学习率用于本轮参数更新,轮末再推进调度器。
        values.append(optimizer.param_groups[0]["lr"])
        optimizer.step()
        if scheduler is not None:
            scheduler.step()

    return values

def sample_plateau_scheduler():
    metrics = [1.00, 0.90, 0.91, 0.92, 0.80, 0.81, 0.82, 0.83]
    optimizer = new_optimizer()
    scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(
        optimizer, mode="min", factor=0.5, patience=1, threshold=0.0
    )

    values = []
    for metric in metrics:
        values.append(optimizer.param_groups[0]["lr"])
        optimizer.step()
        # 该调度器必须接收本轮验证指标。
        scheduler.step(metric)

    return values

for name in ["fixed", "step", "cosine", "warmup_cosine"]:
    values = sample_epoch_scheduler(name)
    print(f"{name:13s}: " + " ".join(f"{value:.4f}" for value in values))

plateau_values = sample_plateau_scheduler()
print(f"{'plateau':13s}: " + " ".join(f"{value:.4f}" for value in plateau_values))
预期输出
text
fixed        : 0.1000 0.1000 0.1000 0.1000 0.1000 0.1000 0.1000 0.1000
step         : 0.1000 0.1000 0.1000 0.0100 0.0100 0.0100 0.0010 0.0010
cosine       : 0.1000 0.0966 0.0868 0.0722 0.0550 0.0378 0.0232 0.0134
warmup_cosine: 0.0500 0.1000 0.0940 0.0775 0.0550 0.0325 0.0160 0.0100
plateau      : 0.1000 0.1000 0.1000 0.1000 0.0500 0.0500 0.0500 0.0250
输出表明,分段策略在固定轮次发生阶跃,余弦策略连续下降,预热策略先升后降,而平台期策略只在验证指标连续未改善时调整。
调用顺序与训练边界
按 epoch 调度时,通常先执行 optimizer.step(),再执行 scheduler.step(),这样当前轮使用的是进入该轮时的学习率。ReduceLROnPlateau 不同,它应在验证结束后调用 scheduler.step(val_loss),不能无参数执行。
恢复训练时必须同时保存并恢复模型、优化器和调度器的 state_dict。如果只恢复模型参数,学习率可能从初始阶段重新开始,导致训练曲线突然跳变。按 batch 调度的策略还要以总更新步数而不是 epoch 数计算进度。
本课总结
- 学习率策略的目标是兼顾前期探索速度与后期收敛精度
- 固定、分段、余弦、预热和按指标调度分别适合不同训练约束
- 调度器的调用时机与状态恢复会直接影响实际学习率轨迹
下一课预告
下一课将处理梯度爆炸、NaN 和异常更新,学习在优化器执行前检查梯度、裁剪范数并定位产生异常的算子。
按自己的节奏,确认真正理解。