
机器学习与深度学习 / 系统课时
自动微分与计算图
自动微分与计算图
本课通过一个可运行的最小训练过程,演示 PyTorch 如何记录前向运算、按链式法则反向计算梯度,以及为什么每轮更新后都必须主动清零梯度。
学习目标
- 理解
requires_grad与动态计算图的关系 - 使用
backward()计算叶子张量的梯度 - 正确完成参数更新与梯度清零
计算图如何记录运算
当叶子张量设置 requires_grad=True 后,PyTorch 会记录由它参与的张量运算。每个中间结果保存产生自己的运算关系,最终形成一张从参数到损失值的有向计算图。
调用 loss.backward() 时,自动微分引擎从损失节点反向遍历计算图,按链式法则把局部导数组合起来,并把结果累加到叶子张量的 .grad 属性中。动态图会在每次前向执行时重新构建,因此普通 Python 条件和循环也能参与模型计算。
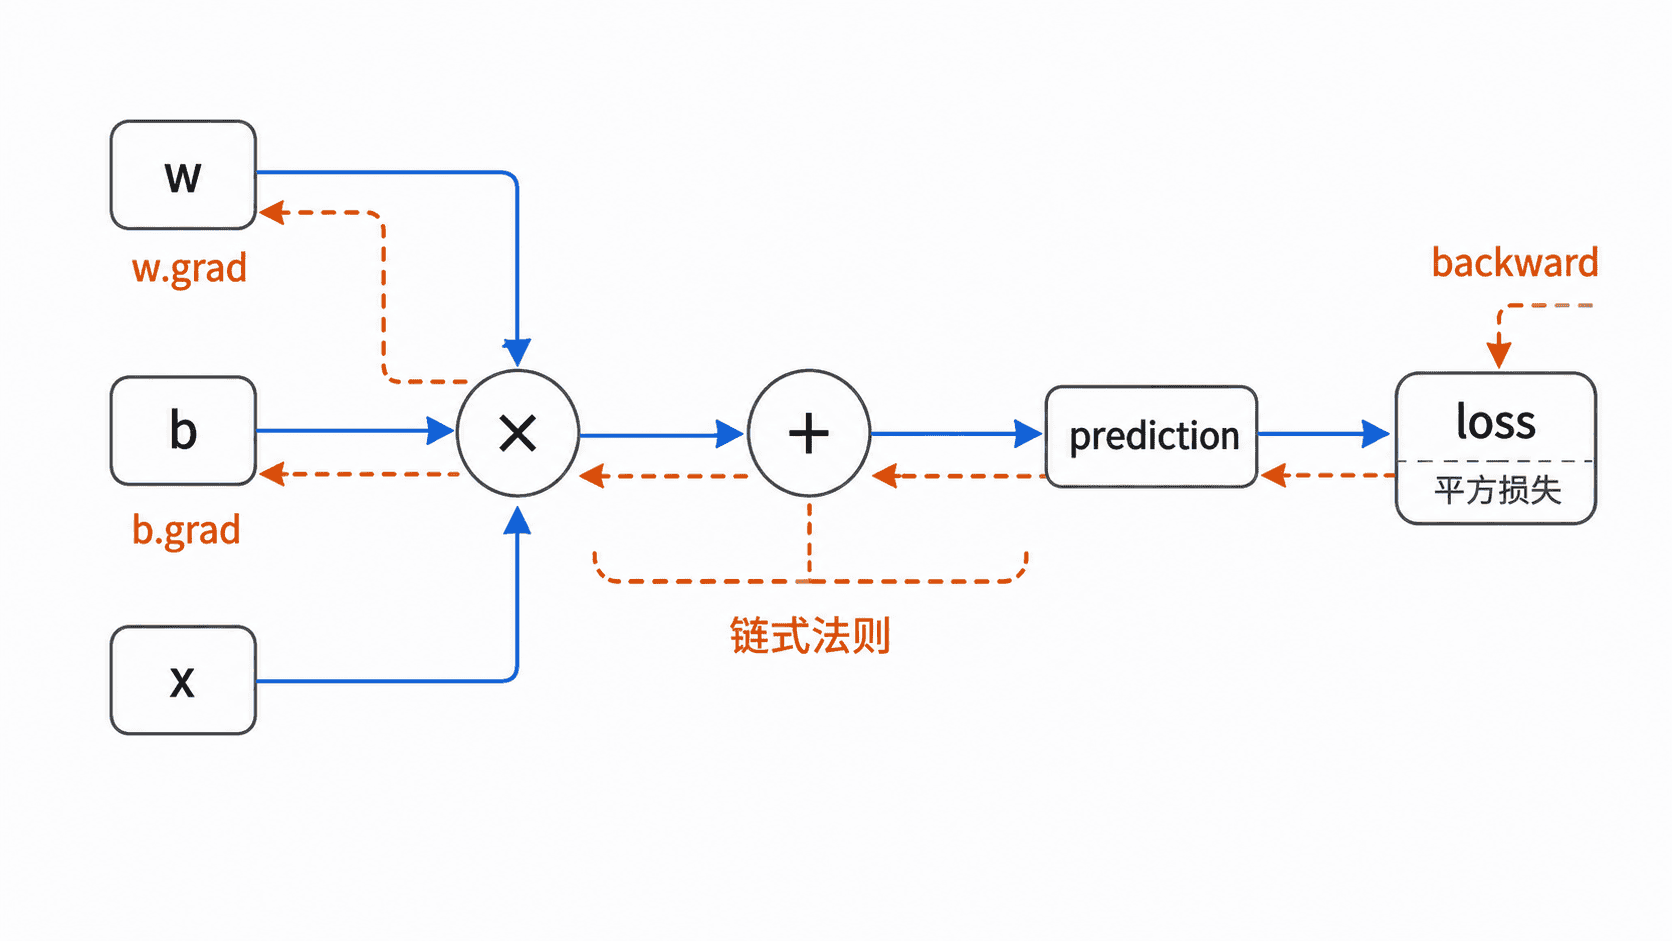
完整示例:前向、反向与清零
下面用一个标量线性模型拟合目标值。程序执行两轮:第一轮计算梯度并更新参数,第二轮验证损失已经降为零。
import torch

def main() -> None:
    x = torch.tensor(2.0)
    target = torch.tensor(10.0)

    # 只有需要训练的叶子张量开启梯度跟踪
    w = torch.tensor(3.0, requires_grad=True)
    b = torch.tensor(1.0, requires_grad=True)
    learning_rate = 0.1

    for step in range(2):
        prediction = w * x + b
        loss = (prediction - target).pow(2)

        # 从标量损失反向计算 w 和 b 的梯度
        loss.backward()

        print(
            f"step={step}, loss={loss.item():.1f}, "
            f"w_grad={w.grad.item():.1f}, b_grad={b.grad.item():.1f}"
        )

        # 参数更新不应进入下一轮计算图
        with torch.no_grad():
            w -= learning_rate * w.grad
            b -= learning_rate * b.grad

        w.grad.zero_()
        b.grad.zero_()

    print(f"w={w.item():.1f}, b={b.item():.1f}")

if __name__ == "__main__":
    main()
预期输出
step=0, loss=9.0, w_grad=-12.0, b_grad=-6.0
step=1, loss=0.0, w_grad=0.0, b_grad=0.0
w=4.2, b=1.6
第一轮中,预测值为 7,损失为 9。反向传播得到 w.grad=-12、b.grad=-6,更新后模型恰好输出 10,因此第二轮损失与梯度都变为 0。
为什么更新参数要关闭梯度
参数更新本身不是模型前向计算的一部分。若直接在梯度跟踪状态下原地修改需要求导的叶子张量,PyTorch 会阻止这类操作或把无关步骤记录进计算关系。
with torch.no_grad(): 会在代码块内临时关闭梯度记录,适合手动更新参数。实际训练通常由优化器完成同样的工作,例如先调用 optimizer.step(),再调用 optimizer.zero_grad()。
梯度为什么必须清零
PyTorch 默认对 .grad 进行累加,而不是覆盖。连续两次调用 backward(),如果中间没有清零,第二次得到的是“旧梯度加新梯度”。这种设计便于实现梯度累积,但普通逐批训练必须显式清零。
对同一张已释放的计算图重复调用 backward() 通常会报错。常规做法是重新执行一次前向计算,生成新的动态图;只有确实需要重复反向时才考虑 retain_graph=True,否则会增加内存占用。
观察计算图时的关键边界
.grad 默认只保存在叶子张量上,中间结果即使参与求导,也不会自动保存梯度。调试中若确实需要查看中间张量梯度,可以在反向前调用 retain_grad()。
推理阶段不需要构建计算图,应使用 torch.no_grad() 或 torch.inference_mode() 包裹前向过程,从而减少内存占用和额外记录开销。
本课总结
requires_grad=True让 PyTorch 在前向过程中动态记录运算关系backward()按链式法则计算梯度,并把结果累加到叶子张量的.grad- 参数更新时关闭梯度记录,每轮训练后显式清零梯度
下一课预告
下一课将把张量、设备与自动微分组合起来,构建一个包含参数、损失函数和优化步骤的最小训练循环。