
机器学习与深度学习 / 系统课时
构建验证与测试流程
构建验证与测试流程
本课将为训练代码补齐可靠的评估环节:使用验证集选择模型,使用测试集报告最终效果,并在无梯度模式下运行推理。完成后,你能避免测试集泄漏、随机层行为错误和额外显存占用。
学习目标
- 区分训练集、验证集和测试集的用途
- 能够使用
eval()与inference_mode()完成评估 - 能够保存验证表现最佳的模型并执行最终测试
数据集职责与使用时机
训练集用于计算梯度和更新参数;验证集用于比较超参数、选择最佳轮次或执行早停;测试集只在方案确定后使用,用于报告模型面对未见数据时的最终表现。
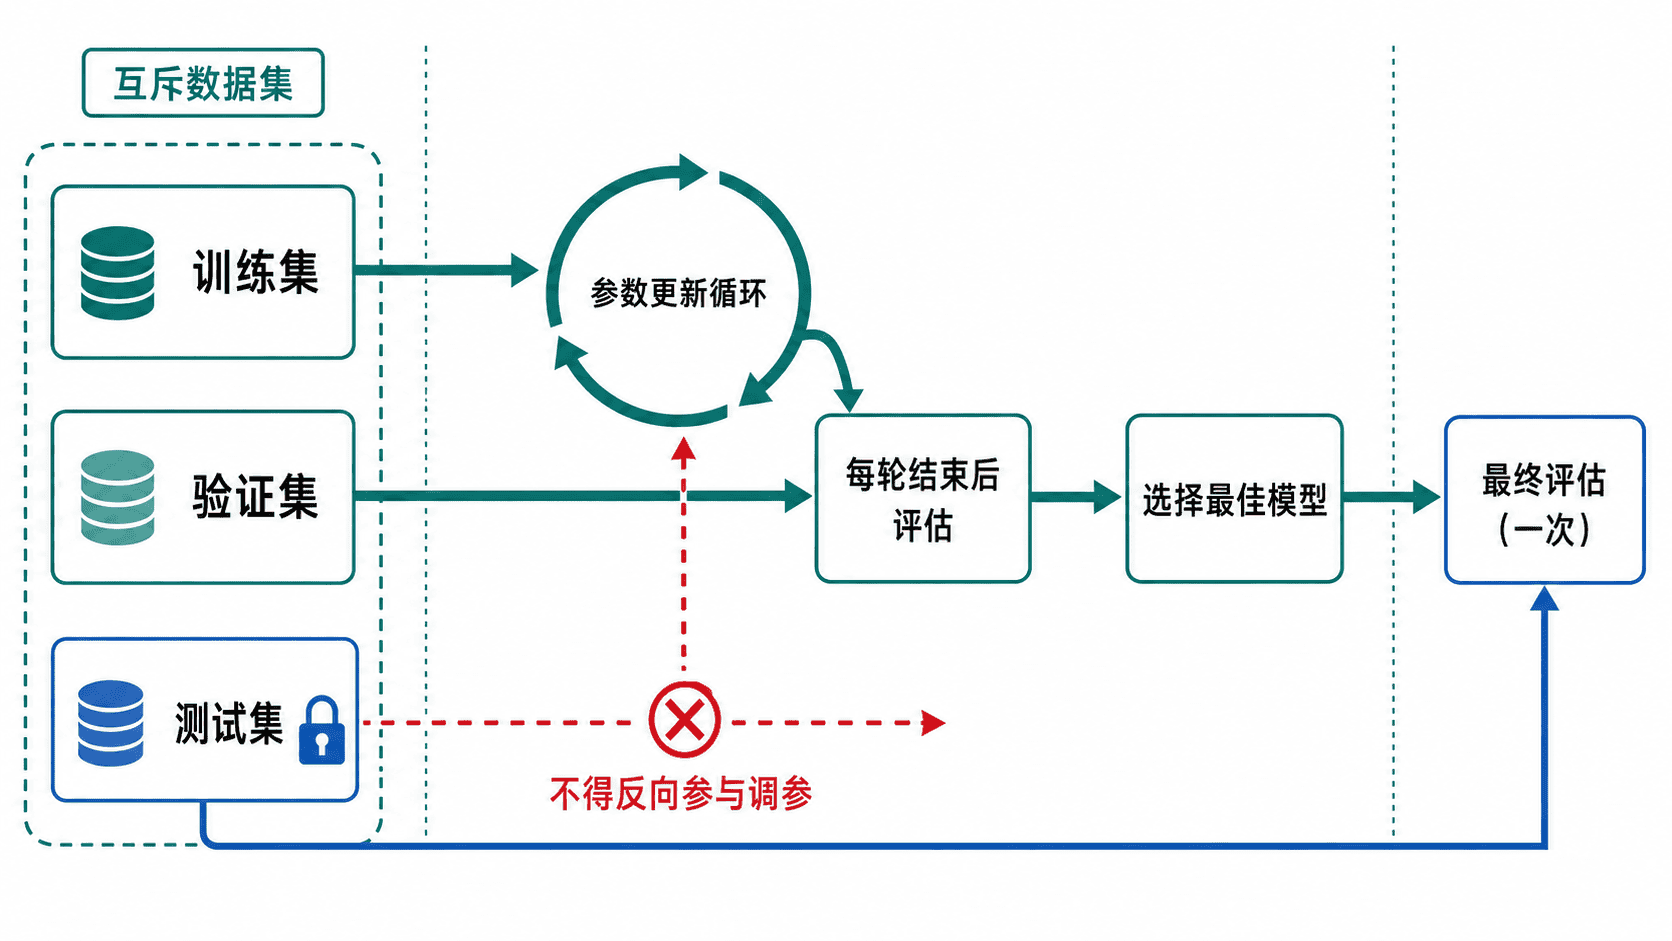
若反复查看测试指标并据此修改模型,测试集就会间接参与调参,最终结果会偏乐观。正确做法是依据验证指标保存最佳参数,训练方案确定后再加载这些参数执行一次测试。
完整评估示例
下面的脚本训练一个二分类模型。每轮训练后评估验证集,保留验证损失最低的参数,最后只对测试集评估一次。
import copy
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset, random_split

torch.manual_seed(7)

x = torch.randn(300, 1)
y = (x[:, 0] > 0).long()
dataset = TensorDataset(x, y)

# 固定划分,保证三份数据互斥且可复现
train_set, val_set, test_set = random_split(
    dataset,
    [180, 60, 60],
    generator=torch.Generator().manual_seed(7),
)

train_loader = DataLoader(train_set, batch_size=32, shuffle=True)
val_loader = DataLoader(val_set, batch_size=32, shuffle=False)
test_loader = DataLoader(test_set, batch_size=32, shuffle=False)

model = nn.Sequential(nn.Linear(1, 8), nn.ReLU(), nn.Linear(8, 2))
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.03)

def evaluate(data_loader: DataLoader) -> tuple[float, float]:
    model.eval()
    total_loss = 0.0
    total_correct = 0
    total_samples = 0

    # 评估阶段不构建计算图,也不更新参数
    with torch.inference_mode():
        for batch_x, batch_y in data_loader:
            logits = model(batch_x)
            loss = loss_fn(logits, batch_y)
            batch_size = batch_x.size(0)
            total_loss += loss.item() * batch_size
            total_correct += (logits.argmax(1) == batch_y).sum().item()
            total_samples += batch_size

    return total_loss / total_samples, total_correct / total_samples

best_val_loss = float("inf")
best_state = None

for epoch in range(1, 6):
    model.train()
    for batch_x, batch_y in train_loader:
        optimizer.zero_grad()
        loss = loss_fn(model(batch_x), batch_y)
        loss.backward()
        optimizer.step()

    val_loss, val_accuracy = evaluate(val_loader)
    print(f"epoch={epoch}, val_loss={val_loss:.4f}, val_acc={val_accuracy:.2%}")

    if val_loss < best_val_loss:
        best_val_loss = val_loss
        best_state = copy.deepcopy(model.state_dict())

model.load_state_dict(best_state)
test_loss, test_accuracy = evaluate(test_loader)
print(f"test_loss={test_loss:.4f}, test_acc={test_accuracy:.2%}")预期输出如下。<VAL_LOSS> 和 <TEST_LOSS> 会随环境略有变化,准确率应明显高于随机猜测的 50%。
epoch=1, val_loss=<VAL_LOSS>, val_acc=<高于 50%>
epoch=2, val_loss=<VAL_LOSS>, val_acc=<高于 50%>
epoch=3, val_loss=<VAL_LOSS>, val_acc=<高于 50%>
epoch=4, val_loss=<VAL_LOSS>, val_acc=<高于 50%>
epoch=5, val_loss=<VAL_LOSS>, val_acc=<高于 50%>
test_loss=<TEST_LOSS>, test_acc=<高于 50%>
评估模式与无梯度执行
model.eval() 会让 Dropout 停止随机丢弃,并让 BatchNorm 使用已统计的均值和方差,但它不会关闭自动求导。torch.inference_mode() 才负责禁用梯度记录并减少推理开销,因此评估时通常同时使用两者。
下一轮训练开始前应再次调用 model.train()。把模式切换放在训练和评估入口处,比在多个内部函数中隐式恢复状态更容易检查。
验收与常见错误
可靠的评估流程应满足三个条件:验证和测试阶段不调用 backward();验证与测试加载器不随机打乱;测试发生在模型选择完成之后。
只调用 eval() 而不关闭梯度,结果通常仍然正确,但会构建无用计算图。另一个常见错误是使用最后一个训练批次的损失代替验证指标,这无法反映模型在完整验证集上的表现。
Tips:验证指标用于做决定,测试指标用于做报告。测试结果一旦影响调参,就不再是独立评估。
本课总结
- 训练集更新参数,验证集选择方案,测试集负责最终独立报告
- 正确评估需要同时使用
model.eval()和torch.inference_mode() - 应保存验证表现最佳的参数,再执行一次最终测试
下一课预告
下一课将比较 SGD、Momentum 和 Adam 的更新机制,并学习如何根据任务特征选择优化器与学习率。