
机器学习与深度学习 / 系统课时
向量矩阵与线性变换
向量矩阵与线性变换
本课把神经网络中常见的向量、矩阵、张量和线性变换连接起来。你将理解一批数字如何表示样本与参数,以及一层网络为什么可以写成矩阵乘法。
学习目标
- 区分标量、向量、矩阵和张量的形状与用途
- 理解矩阵乘法如何完成特征组合与批量计算
- 能从维度判断线性层的输入、参数和输出是否匹配
从形状理解四类数据
标量只有一个数,例如损失值或学习率。向量是一列有顺序的数,可以表示一个样本的特征,如身高、体重和年龄。矩阵把多个向量按行或列组织起来,常用于存放一批样本或一组权重。
张量是对标量、向量和矩阵的统一扩展。零维张量对应标量,一维张量对应向量,二维张量对应矩阵,更高维张量则适合表示图像、视频和批量数据。实际开发中,理解张量首先要看形状,而不是只看其中的数值。
| 对象 | 典型形状 | 深度学习中的例子 |
|---|---|---|
| 标量 | () |
单个损失值 |
| 向量 | (features,) |
一个样本的特征 |
| 矩阵 | (batch, features) |
一批样本 |
| 高维张量 | (batch, channels, height, width) |
一批图像 |
矩阵乘法在做什么
设输入向量为 ,权重矩阵为 。线性层的核心计算可写为:
这里的每个输出分量,都是输入各个分量的加权求和。矩阵乘法并不是简单地“把数乘起来”,而是在一次运算中完成多组特征组合。偏置向量 则允许输出整体平移,使变换不必经过坐标原点。
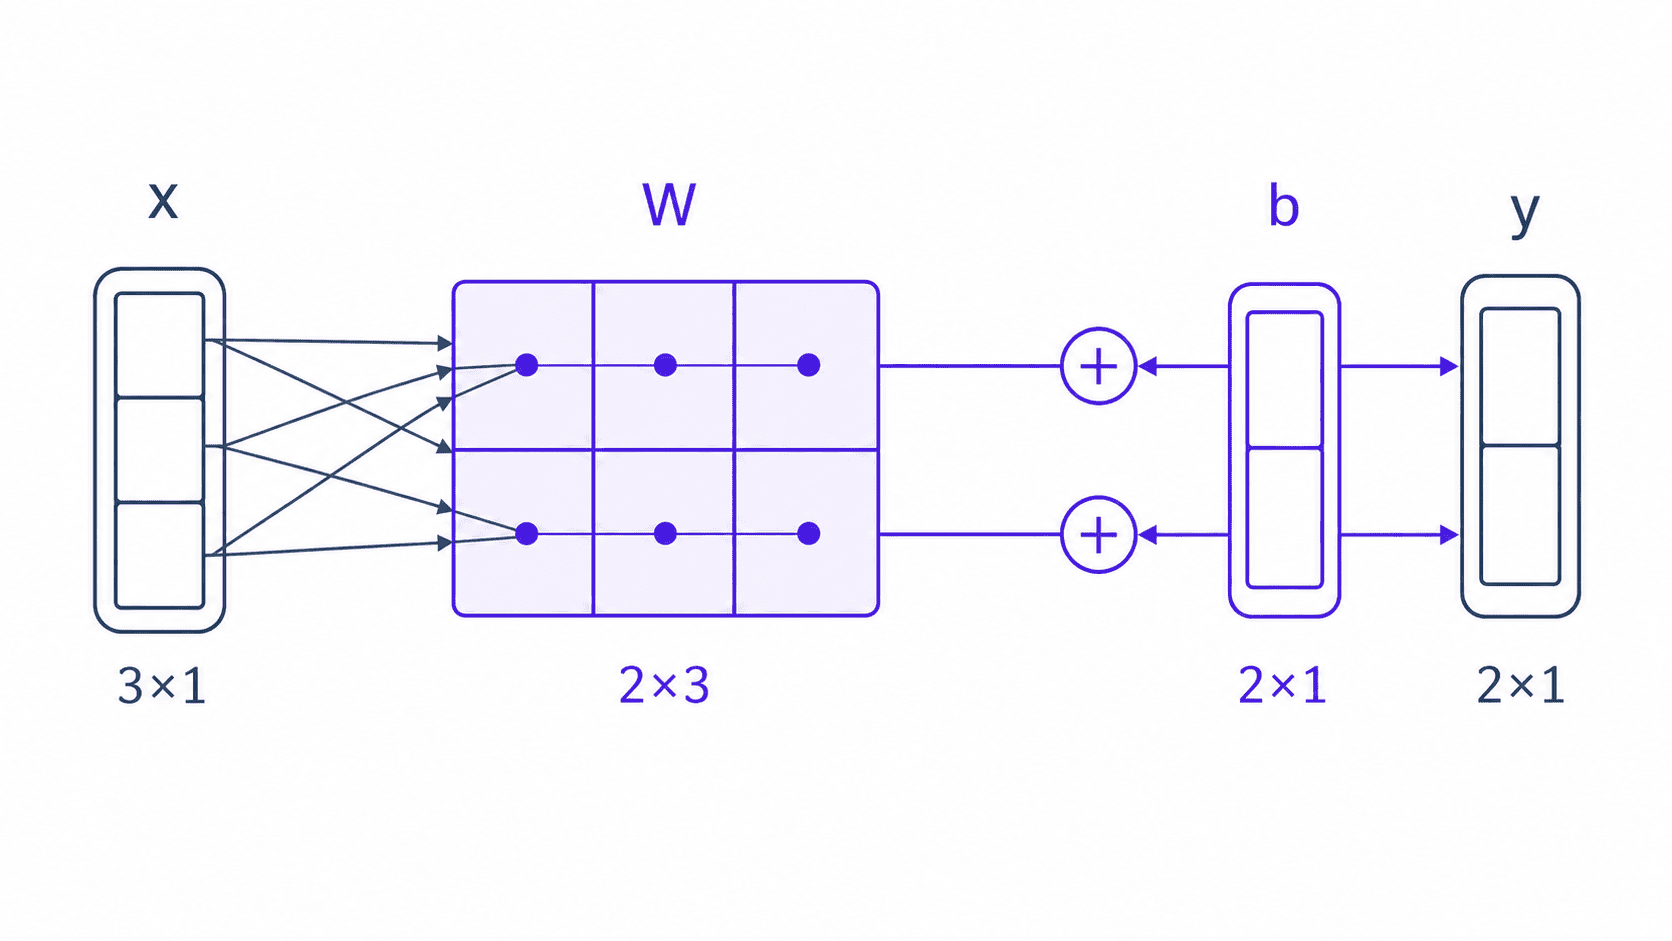
例如,输入有 3 个特征,输出要得到 2 个新特征,则可以令 的形状为 , 的形状为 ,最终 的形状为 。判断矩阵乘法是否成立时,关键是让相邻的内部维度相等。
批量输入与神经网络线性层
训练时通常不会一次只处理一个样本。若一批输入 的形状为 ,其中 是批量大小, 是输入特征数;权重 的形状为 ,则输出形状为 :
这个表达式表示:同一组权重被应用到批次中的每个样本。偏置 的形状通常为 ,计算时会沿批量维自动扩展。由此可见,神经网络中的全连接层,本质上就是“线性变换加偏置”,后面再接非线性激活函数。
线性变换的边界
严格的线性变换要求满足可加性与齐次性,并且必须把零向量映射为零向量。因此 是线性变换,而 在 不为零时更准确地称为仿射变换。工程中常把整个线性层仍简称为 Linear,这是一种约定俗成的命名。
仅靠线性层反复堆叠,整体仍可合并为一次线性或仿射变换,无法表达复杂的弯曲决策边界。神经网络必须在线性层之间加入激活函数,才能获得真正的非线性建模能力。
维度检查方法
遇到矩阵乘法时,先写出每个对象的形状,再检查相邻维度。对于 ,中间的 被消去,输出保留外侧维度 。如果写成 ,内部维度不匹配,就需要转置权重或重新确认数据布局。
Tips:不要凭变量名猜维度。把批量大小、输入特征数和输出特征数明确标在公式旁,能快速发现大多数形状错误。
本课总结
- 向量表示一个样本,矩阵常表示一批样本或一组权重,张量是更高维的统一表示
- 矩阵乘法通过加权求和完成特征组合,维度是否匹配取决于相邻内部维度
- 神经网络线性层通常是仿射变换,必须结合激活函数才能表达非线性关系
下一课预告
下一课将从函数变化率出发,理解导数、偏导数和梯度,并说明它们为什么能指导神经网络更新参数。