
机器学习与深度学习 / 系统课时
Dropout 与随机正则化
Dropout 与随机正则化
Dropout 通过在训练时随机屏蔽部分激活,阻止网络长期依赖少数固定路径。本课将拆解它在训练与推理阶段的不同计算方式,并用 PyTorch 验证模式切换与缩放行为。
学习目标
- 说明 Dropout 随机掩码与缩放的工作机制
- 区分
model.train()、model.eval()与torch.no_grad() - 识别 Dropout 概率、放置位置和组合使用中的常见误区
训练阶段发生了什么
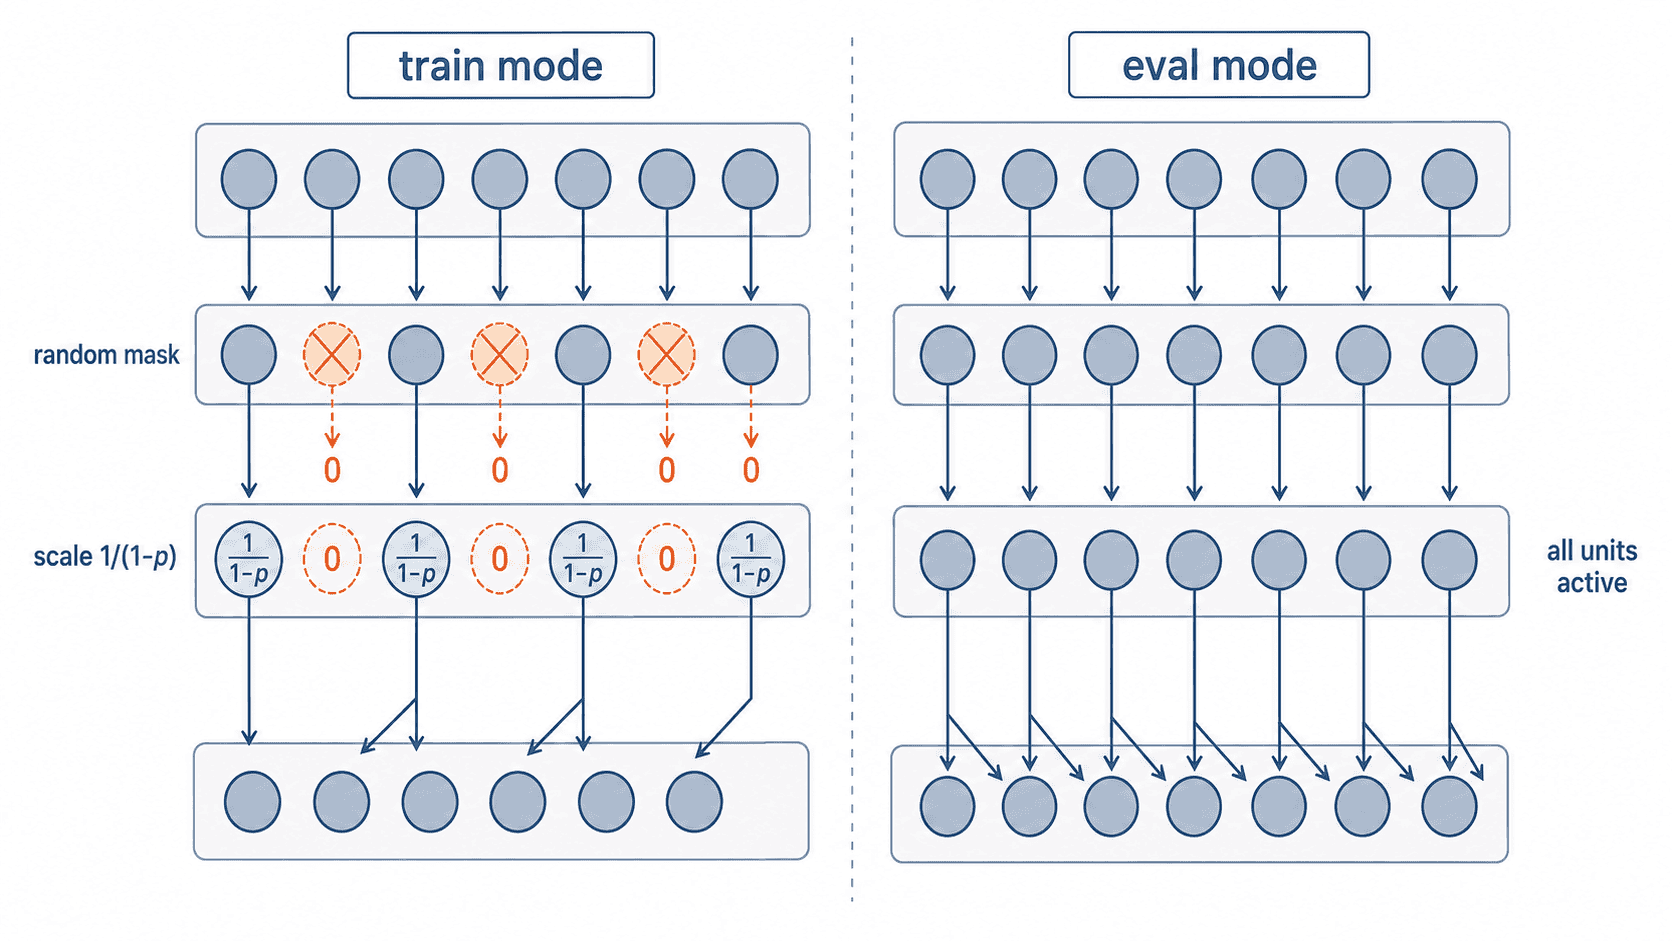
设输入激活为 ,丢弃概率为 。训练时会为每个元素采样伯努利掩码 ,被保留的激活再除以 :
这种做法称为反向缩放 Dropout。由于保留值被放大,训练阶段输出的期望仍接近原输入,因此推理阶段不需要再额外乘以保留概率。
随机掩码会让每个批次经过略有不同的子网络。模型无法依赖某个神经元始终存在,只能把信息分散到多条路径上,从而减少特征之间的脆弱共适应。
推理阶段为何必须关闭
推理需要稳定、可重复的输出,因此不能继续随机屏蔽激活。在 PyTorch 中,model.eval() 会把 Dropout 切换为恒等映射,同时也会改变 BatchNorm 等依赖训练状态的层。
torch.no_grad() 只关闭梯度记录,减少显存和计算开销,并不会自动关闭 Dropout。因此,验证和推理通常同时使用 model.eval() 与 torch.no_grad();训练恢复时再调用 model.train()。
使用 PyTorch 验证行为
下面的示例使用全 1 输入。p=0.5 时,训练输出只可能是 0 或 2;切换到评估模式后,输出应与输入完全相同。
import torch
from torch import nn

dropout = nn.Dropout(p=0.5)
x = torch.ones(1000)

torch.manual_seed(0)
dropout.train()
train_output = dropout(x)

dropout.eval()
with torch.no_grad():
    eval_output = dropout(x)

allowed_values = set(train_output.unique().tolist()).issubset({0.0, 2.0})
print(train_output.shape)
print(allowed_values)
print(torch.equal(eval_output, x))
预期输出:
torch.Size([1000])
True
True
第一个 True 说明训练输出遵循“置零或放大”的规则;第二个 True 说明评估模式下 Dropout 不再修改输入。具体被置零的位置由随机掩码决定,每次训练可能不同。
放置位置与概率选择
全连接网络常把 Dropout 放在激活函数之后、下一线性层之前。卷积网络也可使用 Dropout2d,它按通道丢弃特征图,更符合卷积特征的空间相关性。Transformer 中则常在注意力权重、前馈层和残差分支上使用不同位置的 Dropout。
PyTorch 的 p 表示丢弃概率,不是保留概率。p=0.1 表示随机置零约 10% 的激活。概率过高会让有效信息不足,训练损失长期偏高;数据量大、模型较小或已有强数据增强时,Dropout 也可能没有收益。
常见误区与随机正则化
不要把 Dropout 放在最终输出之后,否则会直接破坏预测结果。与 BatchNorm 组合时也不能简单认为“越多越好”:两者都改变激活统计,过强叠加可能降低训练稳定性,应以验证集结果为准。
随机正则化不只有 Dropout。随机深度会按样本跳过残差分支,DropPath 常用于视觉 Transformer,数据增强则随机改变输入。它们共享同一思路:训练阶段引入受控随机性,推理阶段恢复确定性,但随机对象和适用结构不同。
本课总结
- Dropout 在训练时随机置零并对保留激活做反向缩放,推理时保持恒等映射
model.eval()控制层的训练状态,torch.no_grad()只控制梯度记录- 丢弃概率和放置位置必须结合模型结构与验证集表现选择
下一课预告
下一课将继续讨论数据增强等数据侧正则化方法,比较它们与参数约束、随机网络正则化的作用位置。