
机器学习与深度学习 / 系统课时
自编码器与潜在表示
自编码器与潜在表示
自编码器通过“压缩后再还原”的任务学习数据表示。本课将搭建一个可运行的编码器与解码器,观察潜在向量的形状和重建损失,并说明重建能力、表示压缩与生成能力之间的边界。
学习目标
- 理解编码器、潜在表示和解码器的职责
- 使用 PyTorch 训练一个最小自编码器
- 判断瓶颈大小、重建损失与表示质量之间的关系
自编码器的结构与瓶颈
自编码器包含两个连续模块:编码器把输入 x 映射为潜在向量 z,解码器再根据 z 生成重建结果 x_hat。训练目标是让 x_hat 尽可能接近原始输入,而不是直接预测类别标签。
潜在层通常比输入维度更小,形成信息瓶颈。模型不能逐项复制输入时,就必须保留对重建最有用的结构,例如变量相关性、主要形状或常见模式。
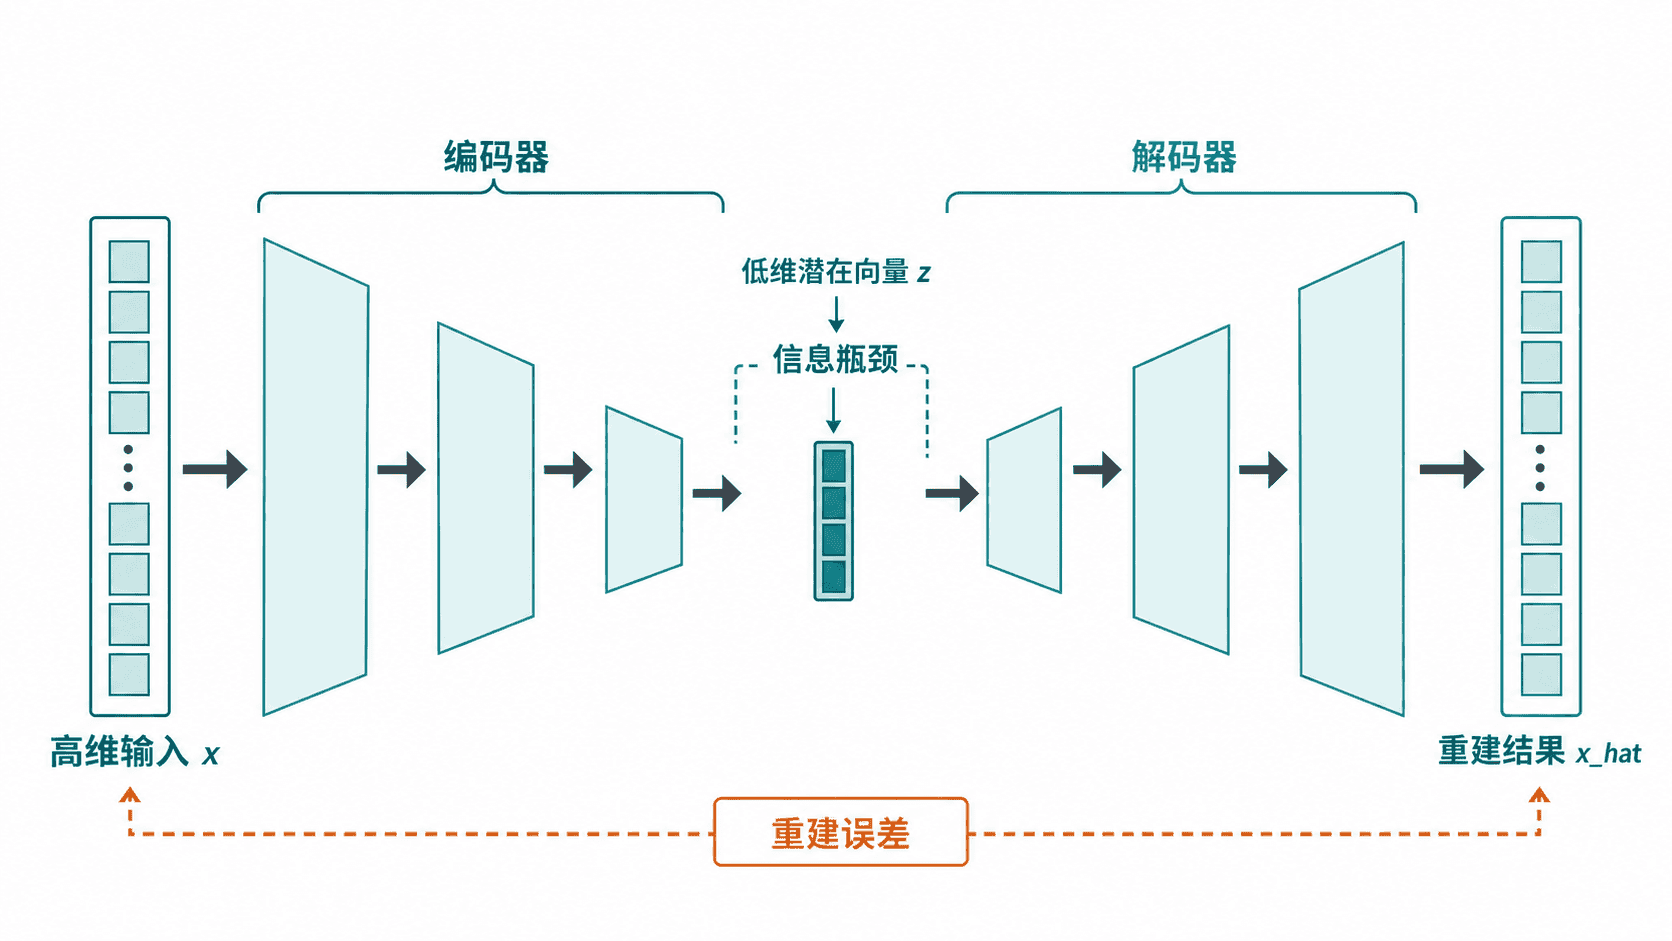
瓶颈过小会丢失重要信息,表现为重建模糊或关键细节缺失。瓶颈过大时,模型可能学会近似复制输入,潜在向量虽然维度高,却没有提炼出稳定结构。
构建最小自编码器
下面使用两个隐变量合成四维数据,再让模型把四维输入压缩为二维潜在表示。数据不需要下载,安装 PyTorch 后即可直接运行。
import torch
from torch import nn

class AutoEncoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(4, 8),
            nn.ReLU(),
            nn.Linear(8, 2),
        )
        self.decoder = nn.Sequential(
            nn.Linear(2, 8),
            nn.ReLU(),
            nn.Linear(8, 4),
        )

    def forward(self, x):
        z = self.encoder(x)
        x_hat = self.decoder(z)
        return x_hat

def build_data(sample_count=256):
    # 四维观测由两个潜在因素组合而成,便于模型学习压缩关系
    factors = torch.randn(sample_count, 2)
    x1, x2 = factors[:, :1], factors[:, 1:]
    data = torch.cat([x1, x2, x1 + x2, x1 - x2], dim=1)
    return data + 0.02 * torch.randn_like(data)

def main():
    torch.manual_seed(7)
    data = build_data()

    model = AutoEncoder()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
    loss_fn = nn.MSELoss()

    for epoch in range(301):
        reconstruction = model(data)
        loss = loss_fn(reconstruction, data)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        if epoch % 100 == 0:
            print(f"epoch={epoch:03d} loss={loss.item():.6f}")

    model.eval()
    with torch.no_grad():
        latent = model.encoder(data)
        reconstruction = model.decoder(latent)

    print("latent shape:", latent.shape)
    print("reconstruction shape:", reconstruction.shape)

if __name__ == "__main__":
    main()
预期输出
epoch=000 loss=<INITIAL_LOSS>
epoch=100 loss=<MID_LOSS>
epoch=200 loss=<LOWER_LOSS>
epoch=300 loss=<FINAL_LOSS>
latent shape: torch.Size([256, 2])
reconstruction shape: torch.Size([256, 4])
四个损失值会因 PyTorch 版本和硬件产生细微差异,但应整体下降,且最终损失明显低于初始损失。潜在表示的第二维为 2,说明每个四维样本都被压缩成了两个数。
重建目标与能力边界
连续数值通常使用均方误差,它会惩罚较大的逐元素偏差。输入是缩放到 [0, 1] 的二值或概率型数据时,可以考虑二元交叉熵,并让解码器输出与损失定义匹配。
损失函数只衡量重建目标,不会自动保证潜在空间具有清晰类别边界。两个模型可能得到相近的重建误差,却形成完全不同的潜在结构,因此不能把低损失直接等同于高质量表示。
当隐藏层容量较大时,可以加入稀疏约束、噪声扰动或权重正则化。去噪自编码器让模型从受损输入恢复干净样本,迫使表示关注稳定模式,而不是记住每个输入值。
训练完成后,编码器可以用于降维、特征提取、相似度检索和异常检测。异常样本若与训练分布差异较大,往往会产生更高的重建误差,但阈值仍需在验证集上校准。
普通自编码器不一定是可靠的生成模型。它只保证训练样本经过编码后能够重建,没有约束潜在空间必须连续或服从已知分布。直接随机采样潜在向量,可能落入训练数据从未覆盖的空洞区域,导致解码结果失真。
本课总结
- 自编码器通过编码、瓶颈和解码完成重建,并从中学习潜在表示
- 重建损失低不等于潜在空间结构一定好,瓶颈容量和正则化同样关键
- 普通自编码器适合表示学习,但其潜在空间未必支持稳定随机采样
下一课预告
下一课将引入变分自编码器,通过分布约束和重参数化让潜在空间更连续,从而把表示学习扩展为可采样的生成模型。