
机器学习与深度学习 / 系统课时
视觉模型错误分析
视觉模型错误分析
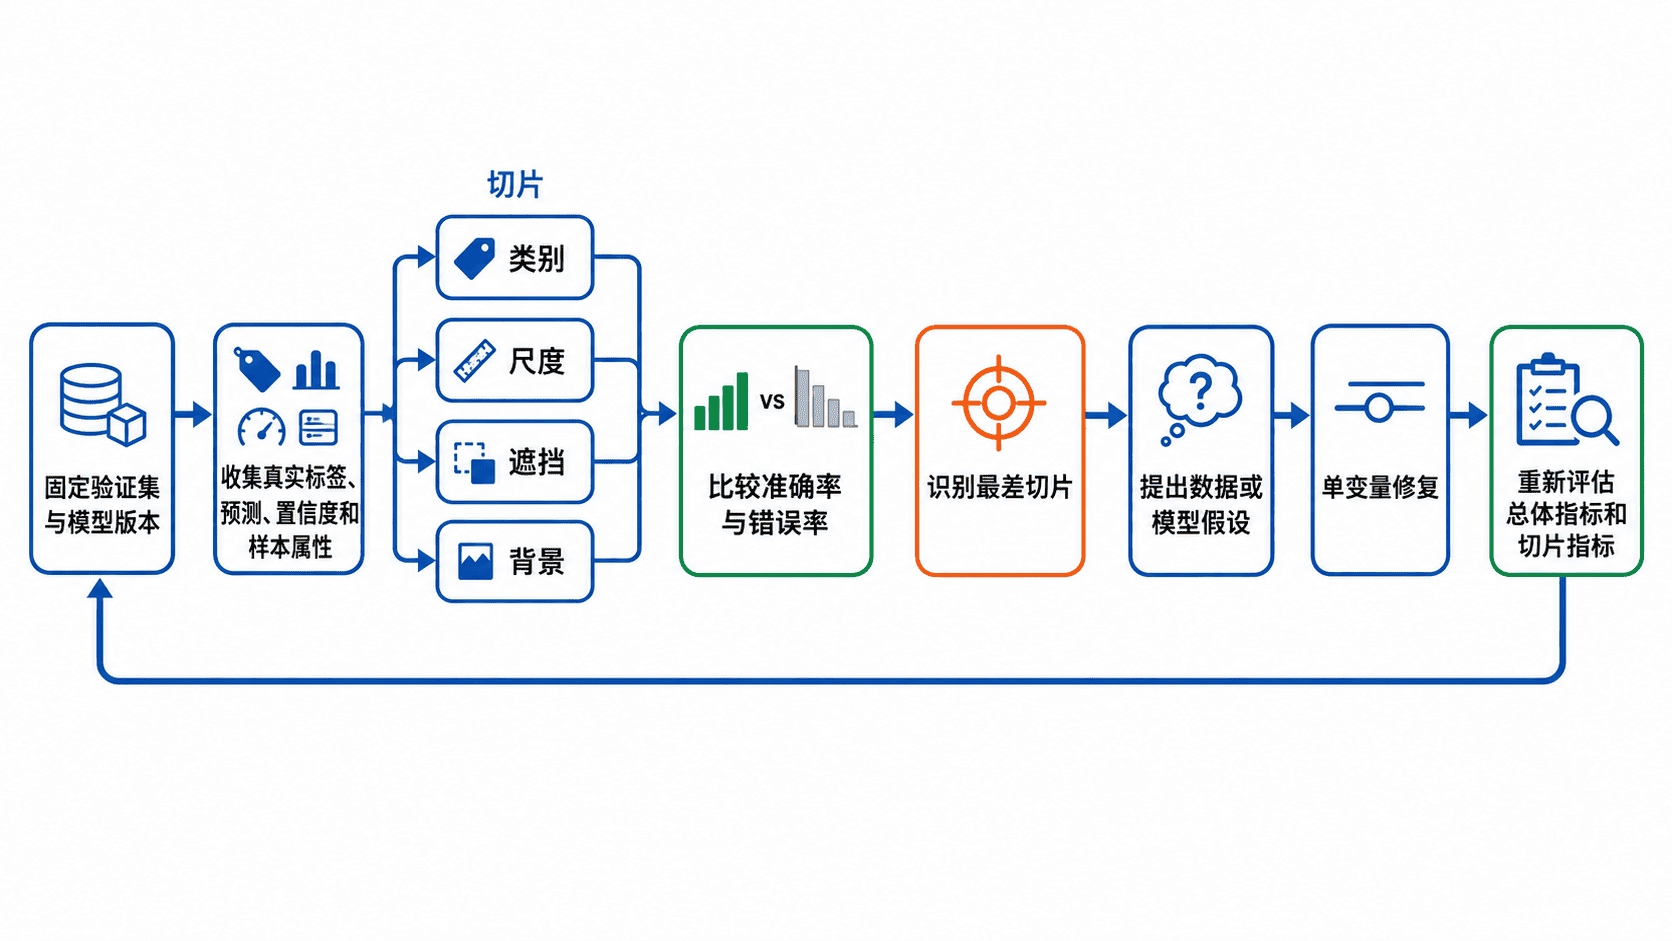
视觉模型整体准确率下降时,直接换模型通常无法回答“错在哪里”。本课建立一套可重复的切片分析流程,把错误按类别、目标尺度、遮挡程度和背景复杂度拆开,并据此确定最值得优先修复的问题。
学习目标
- 建立包含样本属性、预测结果和置信度的错误分析表
- 按类别、尺度、遮挡和背景条件比较局部指标
- 将异常切片映射到数据、模型或训练流程中的可能根因
先固定分析输入
每条验证样本至少要记录样本编号、真实类别、预测类别和置信度。为了定位视觉条件,还应补充目标尺度、遮挡程度和背景复杂度;检测或分割任务可继续加入框面积、目标数量、边界清晰度等字段。
分析必须基于固定验证集和固定模型版本。若每次评估使用不同数据、随机增强或不同阈值,切片结果就无法比较。混淆矩阵适合发现类别混淆,但不能替代尺度、遮挡和背景分析。
按四个维度切片
类别切片回答“哪些语义最难”,尺度切片回答“小目标是否被下采样损失”,遮挡切片回答“可见区域减少后模型是否失效”,背景切片则用于发现模型是否过度依赖场景线索。
| 维度 | 常见分组 | 低分时优先检查 |
|---|---|---|
| 类别 | 猫、狗、车辆等 | 标签噪声、类别不平衡、相似类别边界 |
| 尺度 | 小、中、大目标 | 输入分辨率、特征步长、裁剪策略 |
| 遮挡 | 无、部分、严重 | 训练样本覆盖、遮挡增强、上下文依赖 |
| 背景 | 简单、复杂 | 背景捷径、前景占比、数据采集偏差 |
切片数量不宜过多。每组样本太少时,百分比会剧烈波动,应同时报告样本数和错误数,而不是只展示一个准确率。
用脚本生成可比较报告
下面的示例使用内置数据生成四类切片报告。真实项目可把 records 替换为从 CSV、数据库或评估脚本读取的记录。
from collections import defaultdict

records = [
    {"true": "cat", "pred": "cat", "scale": "small", "occlusion": "none", "background": "simple"},
    {"true": "cat", "pred": "dog", "scale": "small", "occlusion": "partial", "background": "cluttered"},
    {"true": "dog", "pred": "dog", "scale": "large", "occlusion": "none", "background": "simple"},
    {"true": "dog", "pred": "cat", "scale": "small", "occlusion": "heavy", "background": "cluttered"},
    {"true": "car", "pred": "car", "scale": "large", "occlusion": "partial", "background": "simple"},
    {"true": "car", "pred": "truck", "scale": "small", "occlusion": "none", "background": "cluttered"},
    {"true": "truck", "pred": "truck", "scale": "large", "occlusion": "none", "background": "simple"},
    {"true": "truck", "pred": "car", "scale": "small", "occlusion": "partial", "background": "cluttered"},
]

def summarize(rows, field):
    stats = defaultdict(lambda: {"total": 0, "correct": 0})
    for row in rows:
        key = row["true"] if field == "class" else row[field]
        stats[key]["total"] += 1
        stats[key]["correct"] += int(row["true"] == row["pred"])

    print(f"[{field}]")
    for key in sorted(stats):
        total = stats[key]["total"]
        correct = stats[key]["correct"]
        errors = total - correct
        print(f"{key}: accuracy={correct / total:.2%}, errors={errors}/{total}")

for dimension in ("class", "scale", "occlusion", "background"):
    summarize(records, dimension)
预期输出:
[class]
car: accuracy=50.00%, errors=1/2
cat: accuracy=50.00%, errors=1/2
dog: accuracy=50.00%, errors=1/2
truck: accuracy=50.00%, errors=1/2
[scale]
large: accuracy=100.00%, errors=0/3
small: accuracy=20.00%, errors=4/5
[occlusion]
heavy: accuracy=0.00%, errors=1/1
none: accuracy=75.00%, errors=1/4
partial: accuracy=33.33%, errors=2/3
[background]
cluttered: accuracy=0.00%, errors=4/4
simple: accuracy=100.00%, errors=0/4
报告显示类别之间没有明显差异,但小目标和复杂背景表现显著更差。由于样本很少,这只能生成排查假设,不能直接证明背景就是根因。
从现象定位可能根因
若只有少数类别持续低分,先检查错标、类别不平衡和视觉相似性;若小目标明显低分,应检查输入分辨率、裁剪是否丢失目标,以及主干网络下采样倍率是否过大。
遮挡条件恶化通常说明训练数据覆盖不足,或模型过度依赖完整轮廓。复杂背景低分则可能来自前景占比过小、采集场景偏差或背景捷径。最可靠的做法是查看该切片中的真实失败样本,再提出可验证假设。
修复与验证闭环
一次只改变一个主要变量,例如提高输入分辨率、补充复杂背景样本或加入遮挡增强。修改前保存基线结果,修改后同时比较总体指标和目标切片指标,避免局部提升却让其他类别退化。
常见误区包括只看训练集、只挑高置信度错误、把低置信度全部视为模型问题,以及在样本量很小的切片上做确定性结论。错误分析的目标不是解释每个失败,而是找到能带来最大收益的可操作问题。
本课总结
- 整体指标只能说明是否变好,切片指标才能指出问题集中在哪里
- 类别、尺度、遮挡和背景应同时记录样本数、错误数与准确率
- 切片结果用于提出假设,最终要通过单变量修复和重新评估验证
下一课预告
下一课将把错误分析结论转化为数据增强、采样策略和模型改进方案,并建立可量化的回归检查。