
机器学习与深度学习 / 系统课时
LSTM 与 GRU
LSTM 与 GRU
LSTM 与 GRU 在普通 RNN 的状态传递上加入门控,让模型能够选择保留、更新或丢弃信息。本课将对比两种结构的核心状态、输出接口和参数规模,并给出实际选择时的判断依据。
学习目标
- 理解门控机制如何缓解长期依赖和梯度消失
- 区分 LSTM 的细胞状态与 GRU 的单一隐藏状态
- 使用 PyTorch 比较两种网络的输出结构和参数量
为什么普通 RNN 难以长期记忆
序列反向传播需要连续乘上多个时间步的导数。当这些导数长期小于 1 时,早期信息对应的梯度会快速衰减;长期大于 1 时,梯度又可能爆炸。普通 RNN 还会在每一步重写隐藏状态,使较早但重要的信息难以稳定保留。
LSTM 和 GRU 不保证彻底消除这些问题,但门控提供了更直接的信息通道。模型可以学习“哪些内容继续传递、哪些内容需要更新”,因此通常比基础 RNN 更适合长距离依赖。
两种门控结构如何工作
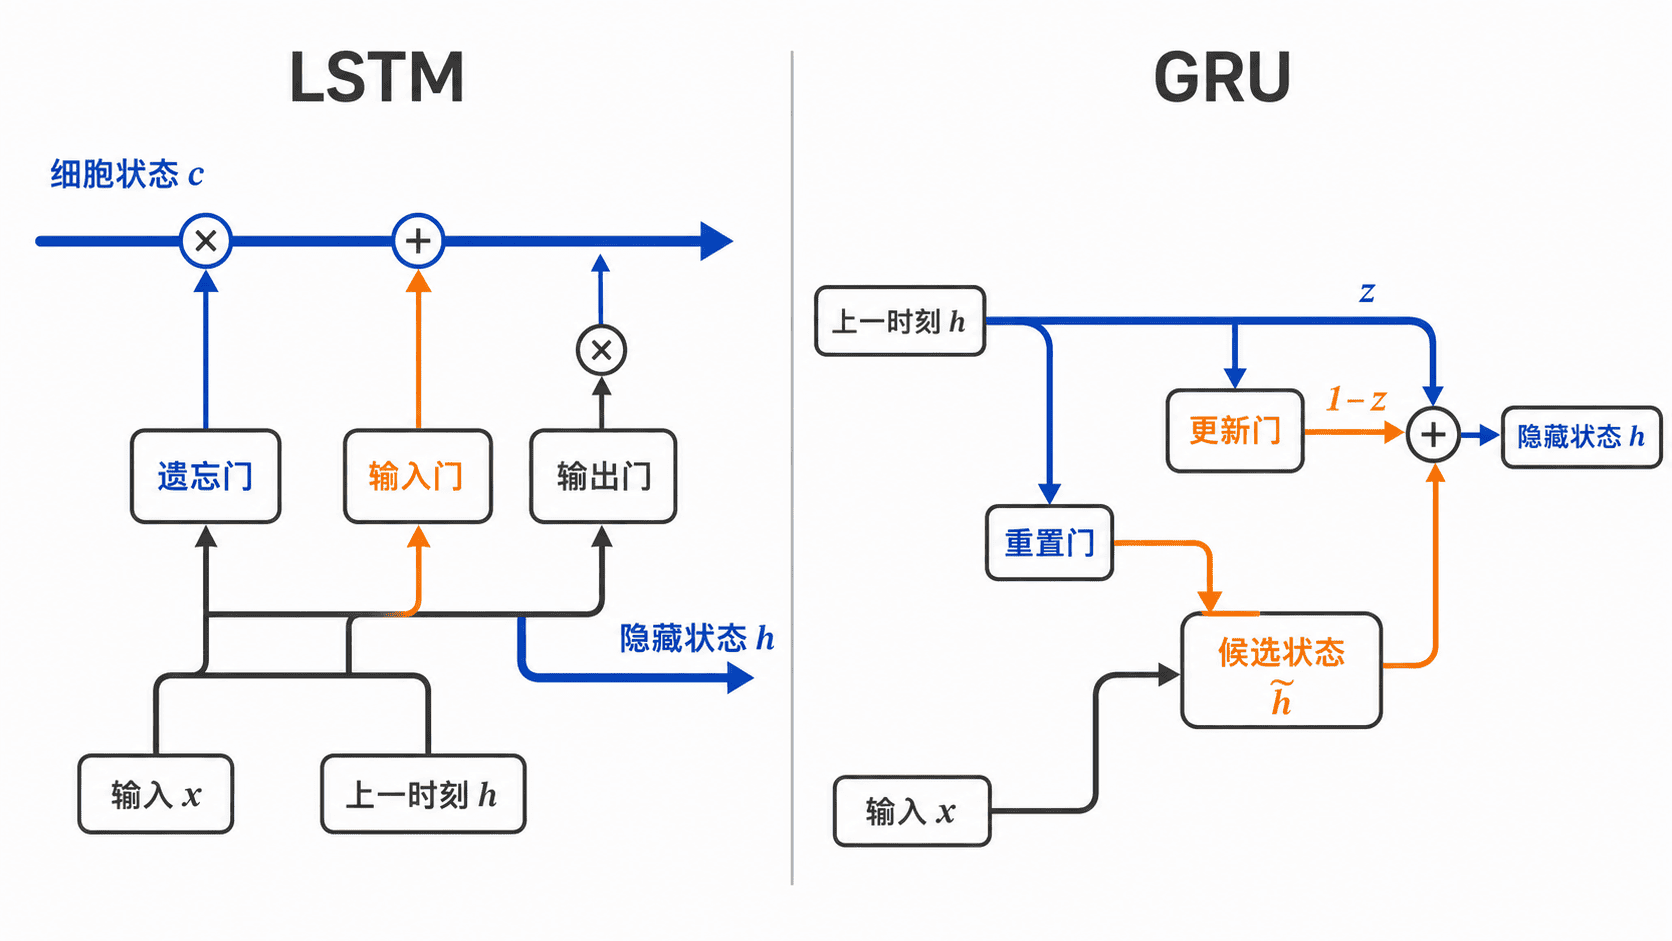
LSTM 同时维护隐藏状态 和细胞状态 。遗忘门决定旧细胞状态保留多少,输入门控制写入多少新信息,输出门决定当前暴露多少状态。细胞状态的加法更新为梯度提供了较顺畅的传播路径。
GRU 把细胞状态与隐藏状态合并,只使用更新门和重置门。更新门在旧状态与候选状态之间做插值,重置门控制生成候选状态时参考多少历史信息。结构更紧凑,参数通常少于同隐藏维度的 LSTM。
| 对比项 | LSTM | GRU |
|---|---|---|
| 状态 | 隐藏状态与细胞状态 | 单一隐藏状态 |
| 门数量 | 输入门、遗忘门、输出门 | 更新门、重置门 |
| 参数规模 | 较大 | 较小 |
| 常见特点 | 控制更细,适合复杂长期依赖 | 训练和推理通常更轻量 |
用 PyTorch 比较输出接口
下面使用相同输入维度和隐藏维度创建 LSTM 与 GRU。示例同时打印输出形状、最终状态形状和参数量,便于理解两者接口差异。
import torch
from torch import nn

batch_size = 2
sequence_length = 5
input_size = 3
hidden_size = 4

inputs = torch.randn(batch_size, sequence_length, input_size)
lstm = nn.LSTM(input_size, hidden_size, batch_first=True)
gru = nn.GRU(input_size, hidden_size, batch_first=True)

lstm_output, (lstm_h, lstm_c) = lstm(inputs)
gru_output, gru_h = gru(inputs)

count_params = lambda model: sum(p.numel() for p in model.parameters())

print("LSTM output:", tuple(lstm_output.shape))
print("LSTM h/c:", tuple(lstm_h.shape), tuple(lstm_c.shape))
print("GRU output:", tuple(gru_output.shape))
print("GRU h:", tuple(gru_h.shape))
print("parameters:", count_params(lstm), count_params(gru))
预期输出:
LSTM output: (2, 5, 4)
LSTM h/c: (1, 2, 4) (1, 2, 4)
GRU output: (2, 5, 4)
GRU h: (1, 2, 4)
parameters: 144 108
两者的逐时间步输出形状相同,但 LSTM 返回最终隐藏状态和最终细胞状态,GRU 只返回最终隐藏状态。参数量取决于输入维度、隐藏维度、层数和方向数,本例中的数值只对应当前配置。
选择与使用边界
优先考虑 GRU 时,可以关注训练速度、模型体积和数据规模;优先考虑 LSTM 时,可以关注更复杂的长期依赖与更细粒度的状态控制。最终选择应通过验证集指标、训练耗时和推理资源共同决定,而不是只凭结构复杂度判断。
无论选择哪一种,都要配合合适的序列长度、梯度裁剪、填充掩码和学习率。门控网络能改善长期记忆,但无法替代正确的数据处理与训练策略。
本课总结
- LSTM 通过三类门和独立细胞状态控制信息流
- GRU 合并状态并减少门数量,参数更少、结构更紧凑
- 两者的优劣取决于任务与资源,应通过实验而不是经验定论选择
下一课预告
下一课将学习双向循环网络,理解模型如何同时利用当前位置之前和之后的上下文信息。